当 AI 生成界面时,语法对了意思可能悄悄变了。
代码层看到了这个问题,数据层看到了这个问题,语义层也需要看到这个问题。
不是限制AI的能力,是给AI的能力加上边界。
1. AI生成时代的结构性问题是意思比语法更容易丢
LLM生成内容时,表面语法几乎总是对的。代码能编译,界面能渲染,文案通顺。
但语义所映射的“组件在这个场景下的意味”“文案在这个语境下代表的情绪”“按钮按下后用户应该预期的后果”则是另一回事。
概率采样机制决定了LLM天生就会"变着花样说"。
同一个Prompt生成 10 次,变体都语法正确但语义可能各不相同。
这是生成式AI的内禀属性,而不是某个模型的缺陷。
语法对了,意思可能悄悄变了
代码层早就发现了这个问题。
EPAM Systems 的工程师在arXiv的论文中提出:
Code-to-Code 转换能够保留表面语法,但业务语义、数据依赖、副作用逻辑可能全变了。
他们的解法不是在转换后修修补补,而是把"意思"和"语法"解耦,在转换链条中间加一层规范。
没有规范层,语法对了,语义漂移了
当AI参与生成内容时,代码、数据、界面和文案都需要一层规范来防止"表面合规,语义漂移"。
2.独立验证规范层是 AI 时代的通用基础设施
AI生成时代的结构性需求倒逼学术界和工业界正在不同领域独立验证同一套方向。
验证 1:代码层 Code-Text-Code
EPAM Systems的论文验证了:在Python转Java、SQL方言互转等场景中,直接Code-to-Code 转换必然引入语义漂移。
解法是在中间插入中性文本规范,用一份受控的语义表示,捕获程序行为、数据依赖、副作用和领域意图,但不直接转移源语言语法。
关键洞察:转换链条中的必要中间层,替代规范层的注释和文档。否则语法和语义耦合,漂移无法被拦截。
验证 2:审查层 review-verdict-revise-verify
PaperJury验证了AI辅助论文审查的闭环模型:review(发现问题)→ verdict(判定性质)→ revise(修改问题)→ verify(验证到位)。
关键洞察:负载承载的安全逻辑必须放在确定性编排层,停止审查、应用补丁、记录账本,这些动作如果交给 AI 自由裁量,可能漏停、漏补、漏记。
这是AI概率性生成的内禀属性。AI只负责需要理解力的软任务(审查、判断、修复),硬逻辑(路由、停止、补丁应用)用确定性代码保证。
四段环形流程图。
review(审查)→ verdict(裁决)→ revise(修订)→ verify(验证)→ 回到 review。
验证 3:数据层 阿里云约束基建
阿里云在《构建可审计、可进化的 AI Agent 底座》中提出约束基建,提出数据定义、业务流程、规则引擎都需要被约束,防止数据schema漂移、规则逻辑漂移、模型输出漂移。
关键洞察:约束必须可审计、可进化。优于一次性配置,创建版本化、可追溯、可回滚的基础设施。

"规范层不是某个领域的特例,是 AI 时代的通用基础设施。"
三个领域,三套系统都验证了同一套底层逻辑:
- 代码层:规范锁住代码语义
- 数据层:规范锁住业务规则
- 审查层:规范锁住审查闭环
所以我总结得出“语义层也需要一道闸门”。
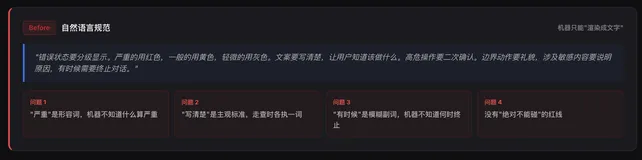
当AI生成界面时,按钮颜色、文案措辞、错误状态级别的"意思"也需要被规范锁住。
3. 从"直接生成"到"规范驱动生成"
AI 生成内容的发展路径,正在从"直接生成"转向"规范驱动生成"。
第一阶段:直接生成
给AI一个Prompt,让AI直接输出。输出什么全靠模型自由裁量。语法对了但是语义可能漂移。出了问题再修。
第二阶段:Prompt 工程
优化Prompt让AI"说得更准"。但Prompt是请求不是约束。同一个Prompt生成10次,10种变体。优化无法消除概率性漂移。
第三阶段:规范驱动
在生成之前把"意思"固定下来。生成时必须携带规范、必须遵守约束、必须留下审计痕迹。用约束生成替代优化生成。

学术界和工业界的独立验证,都在指向同一个趋势:
- 代码层从"直接转换"到"规范驱动重工程"
- 数据层从"自由定义"到"约束基建"
- 审查层从"AI 自由裁量"到"确定性编排 + 语义 Agent"
语义层也在同一条路径上。从"直接生成界面"到"Prompt 工程优化",再到"规范驱动生成"。
设计意图先被写成机器可读的契约,AI 在契约边界内生成,生成后自动验证。
4. Agent = Model + Harness
AI Agent不是只有模型(Model),还需要马具(Harness),构成约束框架。
模型(Model):负责理解力、创造力、上下文推理。生成文案、调整颜色、优化布局。
马具(Harness):负责边界、约束、审计。什么绝对不能碰、什么必须包含、生成后怎么验证。
"马负责跑,缰绳负责方向。AI 负责在边界内发挥创造力,规则负责守住边界。"
模型自由裁量负责"怎么生成更好":
- 模型可以决定。这个按钮的圆角是4px还是6px。
- 模型可以决定。这个文案的语气是正式还是亲和。
确定性规则泽夫"什么绝对不能碰":
- 绝对不能。Critical 能不能写成"严重"。
- 绝对不能。删除按钮能不能做成蓝色实心。
- 绝对不能。错误状态能不能全部用红色。
两者分工,AI负责在边界内发挥创造力,规则负责守住边界。
所以我总结得出语义也需要一道闸门,给 AI 的能力加上边界而不是单纯的限制。
5. 预告:语义层的规范驱动重工程
我正在设计语义层的规范驱动重工程流程。一个受控的语义约束闭环:发现漂移 → 生成契约 → 验证有效
- 发现:按组件类型做结构化识别,扫描 AI 生成界面中的语义偏差。机器按规则扫描替代人工走查。
- 契约:把设计意图写成机器可读的 YAML 规则。代码格式的约束替代文档,让机器能执行、人能写、版本可追溯。
- 验证:产品开发级别的三级测试标准。让那个机器自动审查有明确的通过准则。
"语义层的规范驱动重工程,
对象从代码换成了按钮、文案和错误状态,但根因和解法哲学完全一样。"
- 代码层用中性文本规范锁住业务语义
- 语义层用YAML语义契约锁住设计意图
规范层正在逐渐演化为AI时代的通用基础设施。
当AI生成内容时,无论是代码、数据、界面还是文案,语义也需要一道闸门。
附录:引用索引
领域
来源
核心概念
代码层
EPAM Systems, arXiv 2026
Code-Text-Code Reengineering
审查层
PaperJury, arXiv 2026
review-verdict-revise-verify
数据层
阿里云
约束基建(Constraint Infrastructure)
语义层
Schema-As-Code
规范驱动重工程(预告)
关于作者
魏雯,体验架构设计师。
专注于:AI 界面的语义治理。解决的核心问题:让 LLM 生成的界面不偏离设计规范。
10+ 年互联网设计经验。设计系统 / 体验工程 / AI 原生|广州 / 深圳