我们需要在GPU一张卡部署多个模型实例。
在PAI-EAS先需要先购买GPU专有资源组(包月资源组),然后把模型打分服务部署在专有资源组上。
一般来说:推理卡可以是32核的A10或者gu30,或者是L20 。
官方文档:共享gpu
参数:
以下是重点的参数,具体操作看下一节。
显卡内存可以划分:例如A10的GPU有24G的显存(实际可用不到24G),可划分3个实例,每个实例用7G(并不是8G)。
PAI-EAS服务配置中的重点参数:
"gpu_memory": 7, 7G内存
不要配置 gpu_core_percentage ,可能导致GPU RT的毛刺。
在EasyRec中,需要设置 'cuda': "11.2"。
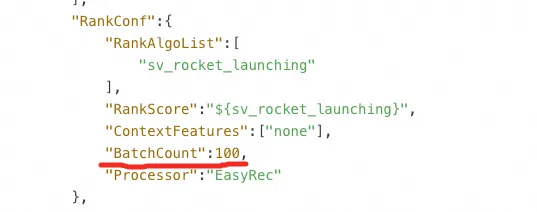
pairec 引擎配置单中的重点参数:
BatchCount,设置每次打分的物品个数。
操作步骤:
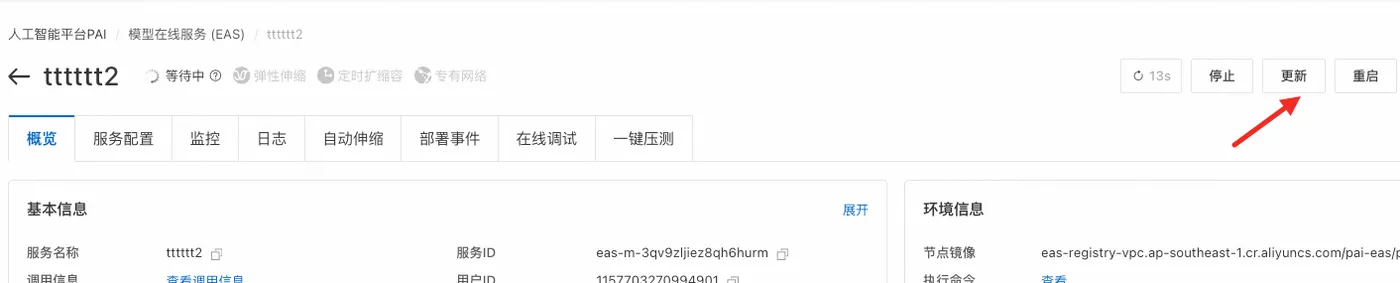
(1)点击“更新服务”
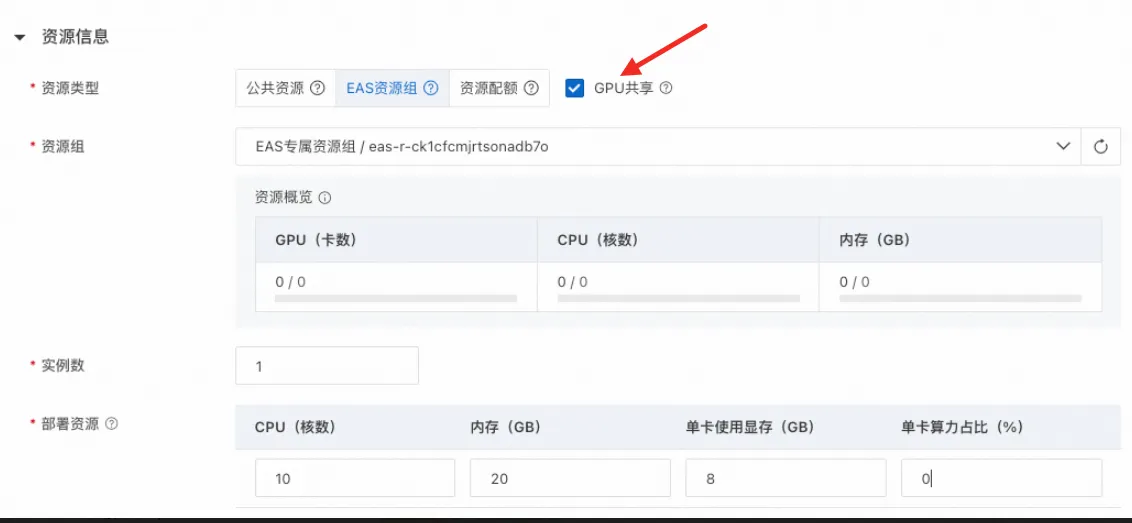
(2)点击“GPU”共享,设置cpu数量、内存数量、显存。
(3)点击“确定”更新服务。
(4)在PAI-EAS服务的“监控”tab页面,查看cpu内存、gpu显存
内存和gpu显存都正常,服务状态“运行中”,则正常。
核:32个 内存:188G gu30卡:一个实例7G显存 gpu 核心占比:30% |
|


(5)设置引擎配置单中的BatchCount
BatchCount一般设置为100到300。如果BatchCount=300,精排数量是900,则意味着精排PAI-EAS服务的实例至少要有3个,才能尽快返回打分结果;如果打分实例只有1个,则需要打分3次,rt时间则是前者的3倍。
参考TorchEasyRec版本的配置文件
TorchEasyRec Processor: https://help.aliyun.com/zh/pai/torcheasyrec-processor
{
    "cronscaler": {
        "excludeDates": [],
        "scaleJobs": []
    },
    "metadata": {
        "cpu": 10,
        "gateway": "default",
        "gpu_memory": 7,
        "instance": 4,
        "memory": 32000,
        "name": "${服务名称}",
        "resource": "eas-r-xxxxx",
        "resource_burstable": false,
        "rpc": {
            "enable_jemalloc": 1,
            "max_queue_size": 256
        },
        "worker_threads": 16,
        "workspace_id": "32668"
    },
    "model_config": {
        "access_key_id": "1111",
        "access_key_secret": "2222",
        "featuredb_password": "aaaa",
        "featuredb_username": "bbbb",
        "fg_mode": "normal",
        "fg_threads": 8,
        "fs_entity": "host",
        "fs_model": "${model_name}",
        "fs_project": "${fs_name}",
        "load_feature_from_offlinestore": false,
        "outputs": "probs_is_click",
        "period": 2880,
        "region": "ap-southeast-1",
        "security_token": "None",
        "steady_mode": true,
        "storage_api_quota_name": "ot_quota_name_xxxx"
    },
    "model_path": "oss://xxxx/EasyRec/deploy/model_name/20250515/export/final_with_fg",
    "name": "model_name",
    "networking": {
        "gateway": "default"
    },
    "processor": "easyrec-torch-1.0",
    "processor_envs": [
        {
            "name": "INPUT_TILE",
            "value": "2"    ### input tile 参数
        },
        {
            "name": "NO_GRAD_GUARD",
            "value": "1"
        },
        {
            "name": "PYTORCH_TENSOREXPR_FALLBACK",
            "value": "2"
        }
    ],
}
EasyRec版本:参考DataWorks部署任务的脚本:
EasyRec 需要设置 'cuda': "11.2"
'''PyODPS 3
请确保不要使用从 MaxCompute下载数据来处理。下载数据操作常包括Table/Instance的open_reader以及 DataFrame的to_pandas方法。
推荐使用 PyODPS DataFrame(从 MaxCompute 表创建)和MaxCompute SQL来处理数据。
更详细的内容可以参考:https://help.aliyun.com/document_detail/90481.html
'''
import json
import os
service_name = 'fs_dbmtl_v4'
config = {
  'name': service_name,
  'metadata': {
    'cpu': 7,
    'gateway': 'default',
    'gpu': 0,
    'cuda': "11.2",
    'gpu_memory': 7,
    'memory': 55000,
    'name': 'fs_dbmtl_v4',
    'rpc': {
        'enable_jemalloc': 1,
        'max_queue_size': 256
    },
    'resource': 'eas-r-ssss',
    'rolling_strategy.max_unavailable': 1
  },
  'model_path': f"oss://xxx-saas/EasyRec/deploy/home_feed_dbmtl_v3/{args['ymd']}/export/final_with_fg",
  'model_config': {
    'outputs': 'probs_is_click,probs_is_collect_like_comment',
    'fg_mode': 'tf',
    'steady_mode': True,
    'period': 2880,
    'access_key_id': f'{o.account.access_id}',
    'access_key_secret': f'{o.account.secret_access_key}',
    "load_feature_from_offlinestore": True,
    'region': 'cn-shanghai',
    'fs_project': 'ffffff',
    'fs_model': 'fs_dbmtl_v2',
    'fs_entity': 'item',
    'featuredb_username': '111',
    'featuredb_password': '111',
    'log_iterate_time_threshold': 100,
    'iterate_featuredb_interval': 5,
    'mc_thread_pool_num': 1,
  },
  "processor": "easyrec-2.6"
}
with open('echo.json', 'w') as output_file:
    json.dump(config, output_file)
#os.system(f'/home/admin/usertools/tools/eascmd -i {o.account.access_id} -k {o.account.secret_access_key} -e pai-eas.cn-shanghai.aliyuncs.com create echo.json')
os.system(f'/home/admin/usertools/tools/eascmd -i {o.account.access_id} -k {o.account.secret_access_key} -e pai-eas.cn-shanghai.aliyuncs.com modify {service_name} -s echo.json')