PPO 算法的基础认识
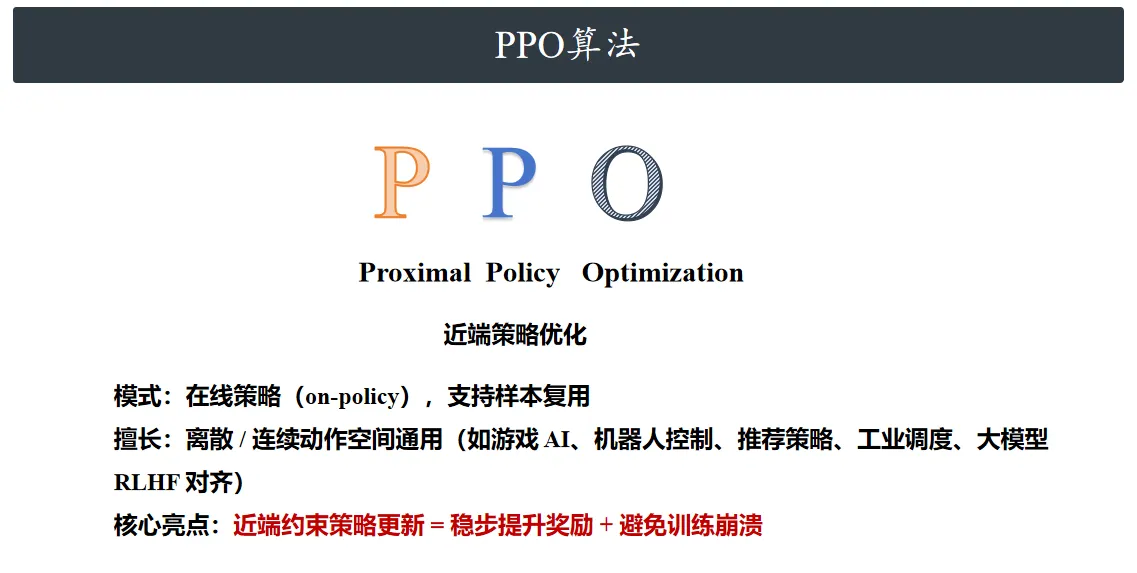
PPO = Proximal Policy Optimization(近端策略优化算法)
PPO 是目前落地最广、上手最简单、训练稳定性极强的通用强化学习算法,兼顾离散与连续动
作场景,游戏AI、机器人控制、大模型对齐、工业决策等任务普遍首选它。它属于策略梯度类算
法,核心思想是严格限制新旧策略的更新幅度,在保证策略稳步提升的同时,避免参数更新幅
度过大导致训练震荡、模型崩溃,还支持重复利用采样样本,大幅提升数据效率。

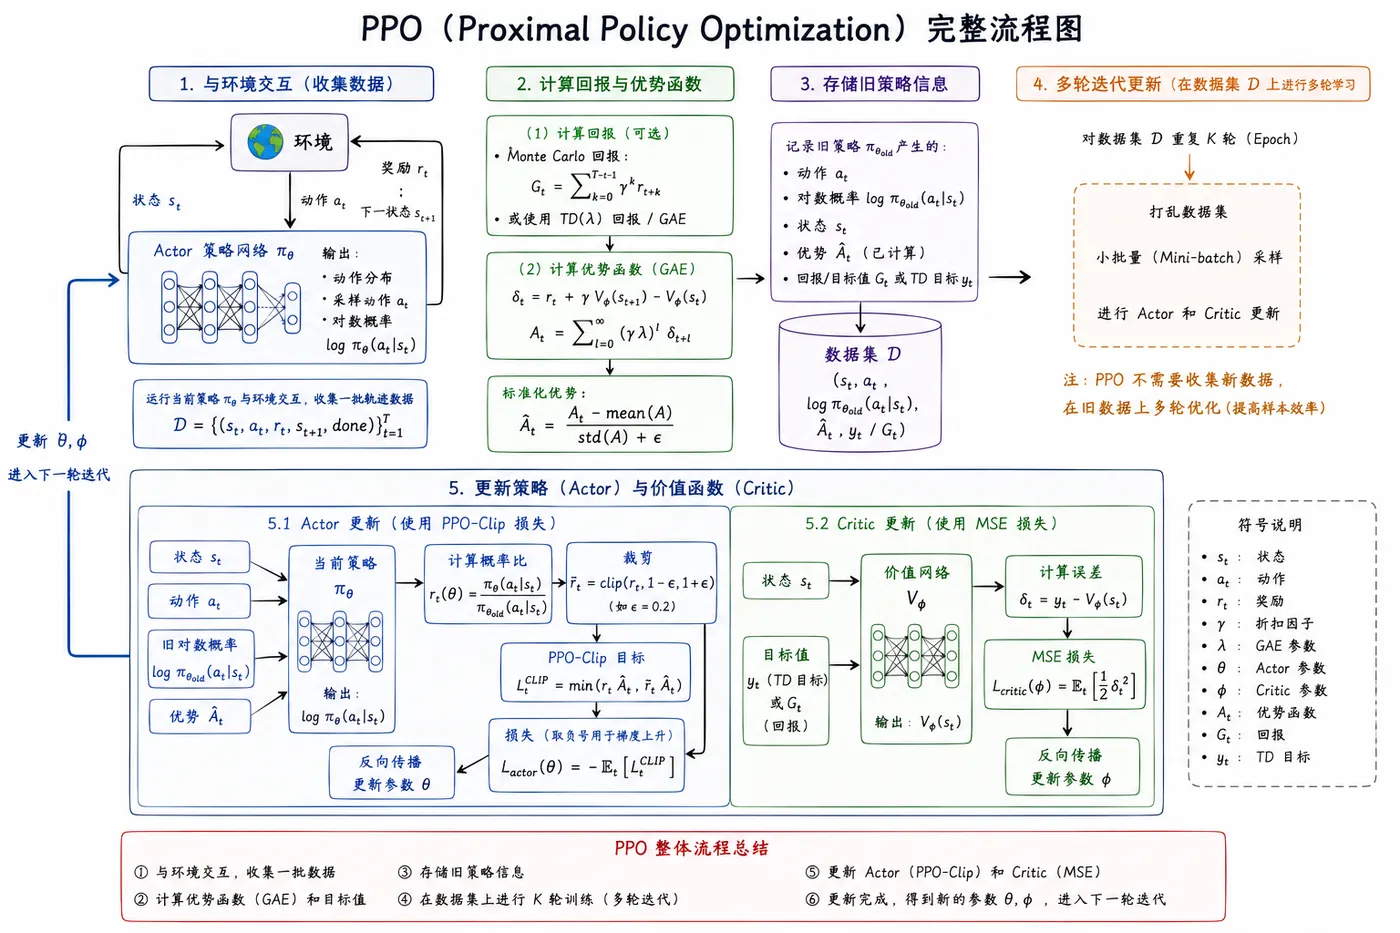
PPO 算法的网络结构
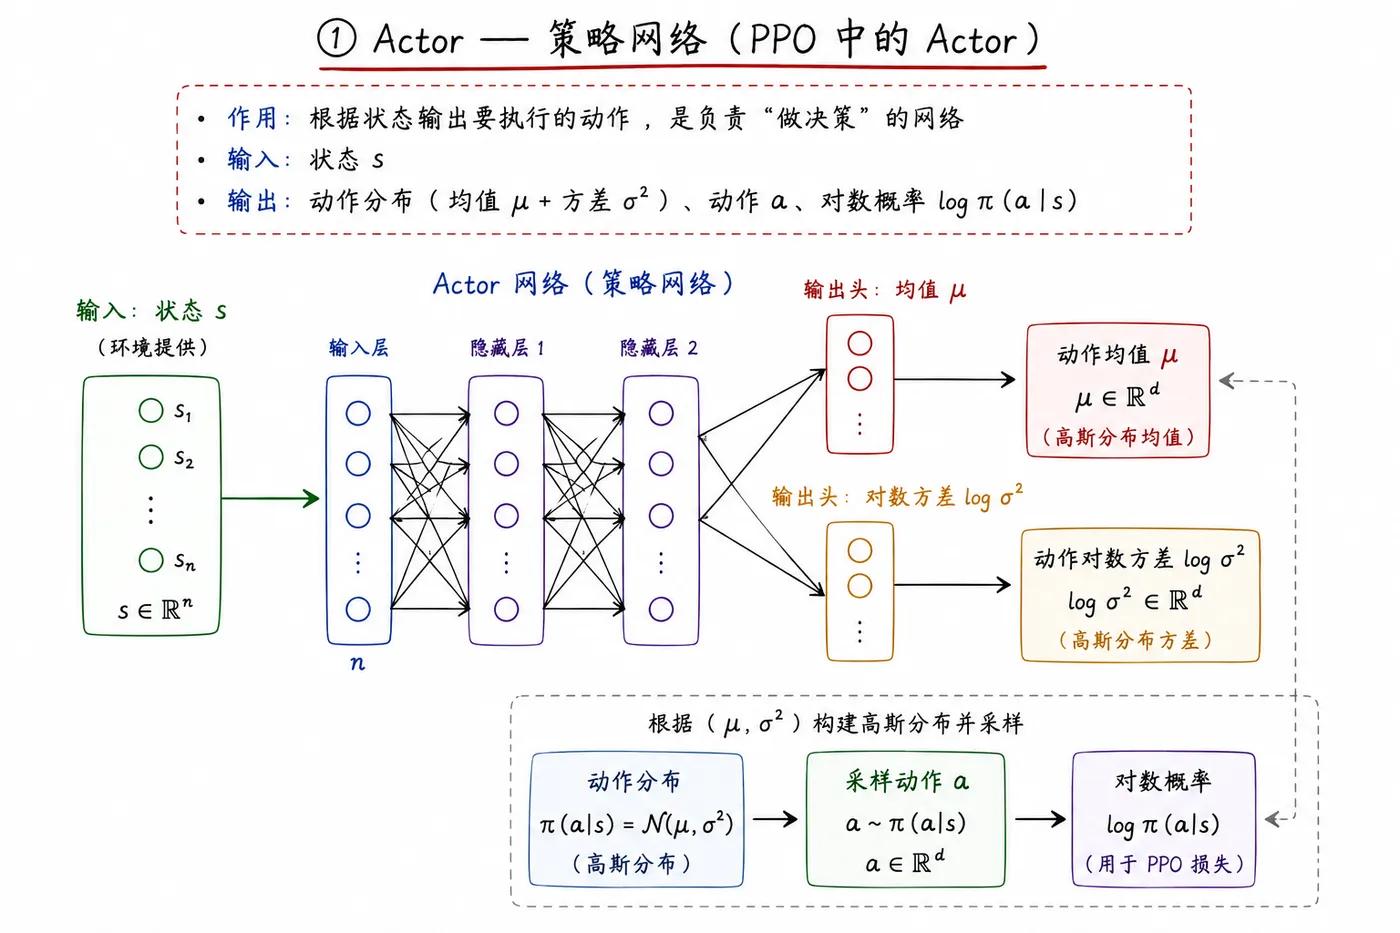
① Actor —— 策略网络
输入:状态 s
输出:动作分布(均值 + 方差)、动作 a、对数概率 log π(a|s)
作用:根据状态输出要执行的动作,是负责 “做决策” 的网络

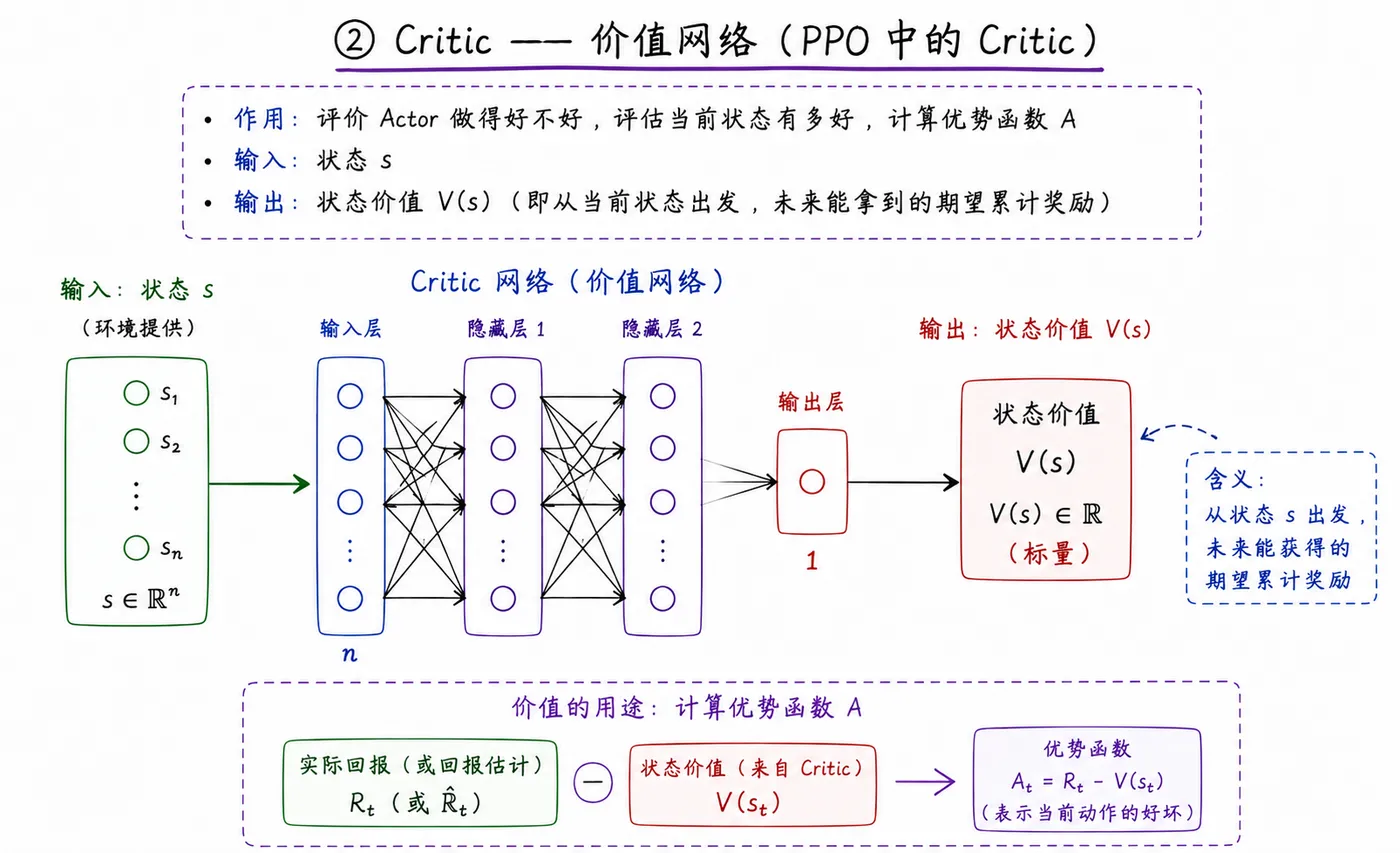
② Critic —— 价值网络
输入:状态 s
输出:状态价值 V (s)(评估当前状态好不好、未来能拿多少奖励)
作用:评价 Actor 做得好不好,计算优势函数 A

网络更新
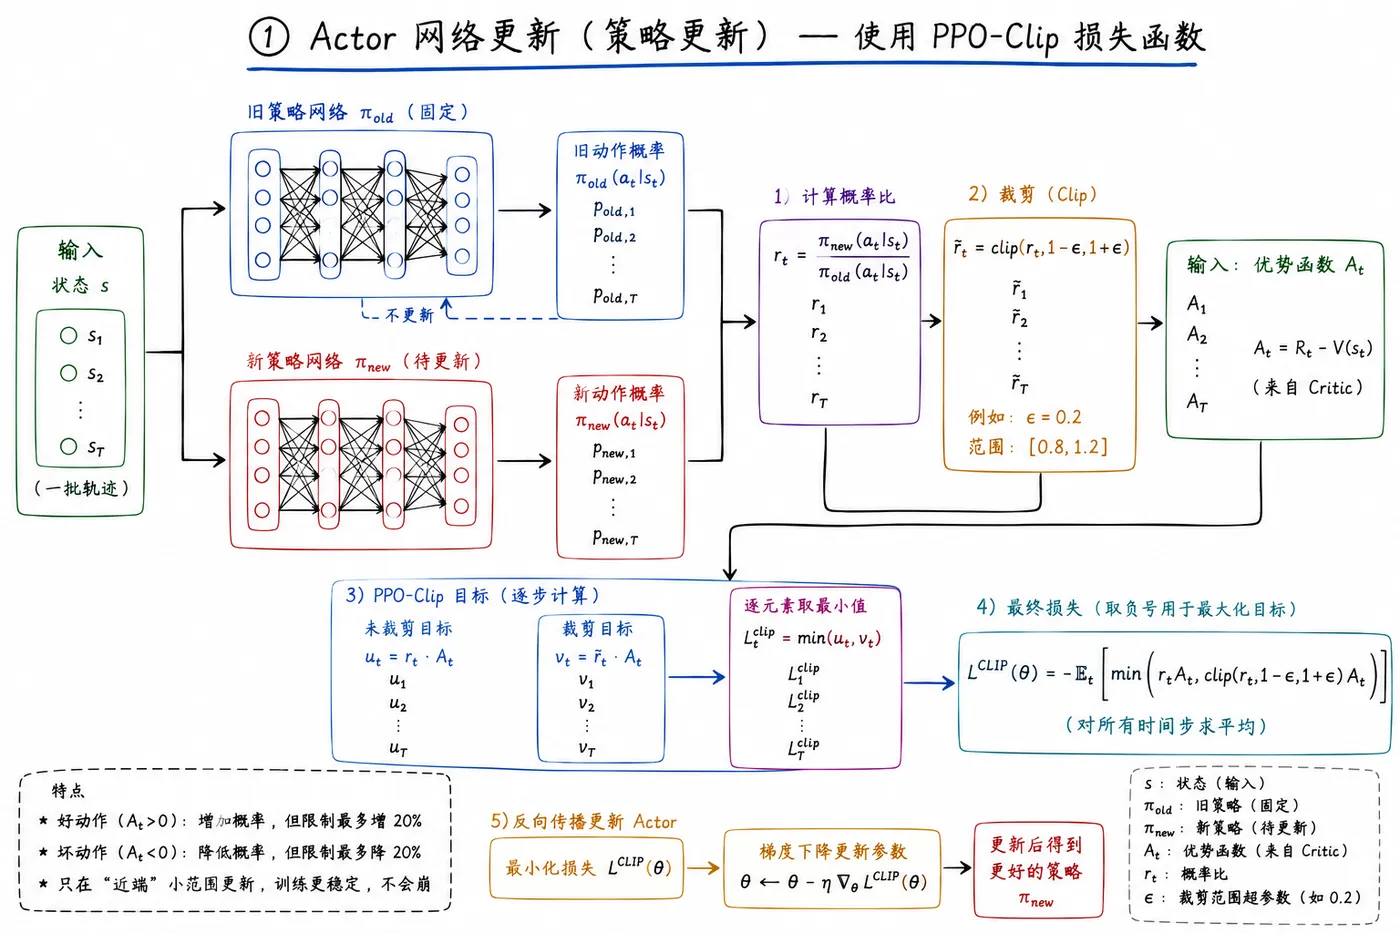
① Actor 网络更新(策略更新)
使用:PPO-Clip 损失函数
目的:更新策略,让好动作概率变高,坏动作变低,但更新幅度被限制,不会崩。
输入:
- 状态 s
- 旧动作概率 π_old
- 新动作概率 π_new
- 优势函数 A
计算:
- 求概率比 r = π_new / π_old
- 裁剪到 [1-ε, 1+ε]
- 取 min (r*A, clip (r)*A) → 得到最终损失
- 反向传播更新 Actor
特点:
- 只在 “近端” 小范围更新
- 训练超级稳定
- 不会像传统策略梯度那样炸掉
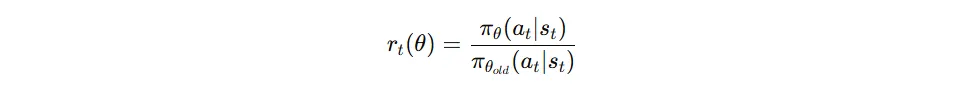

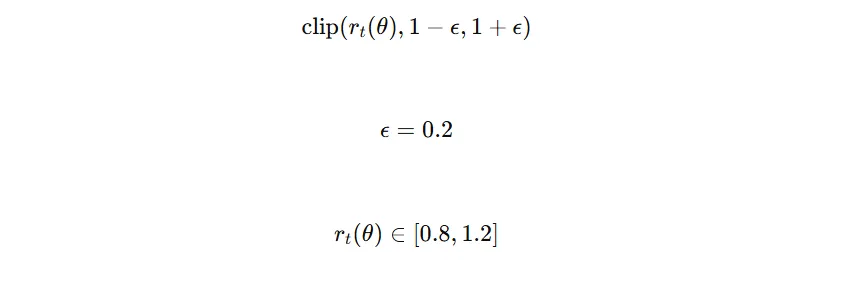
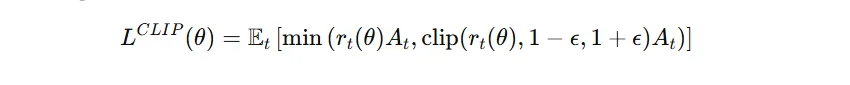

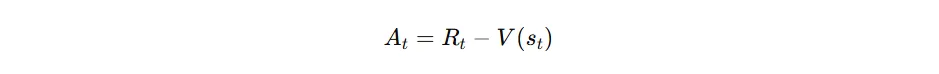

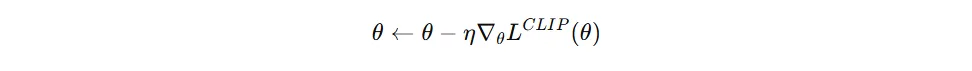


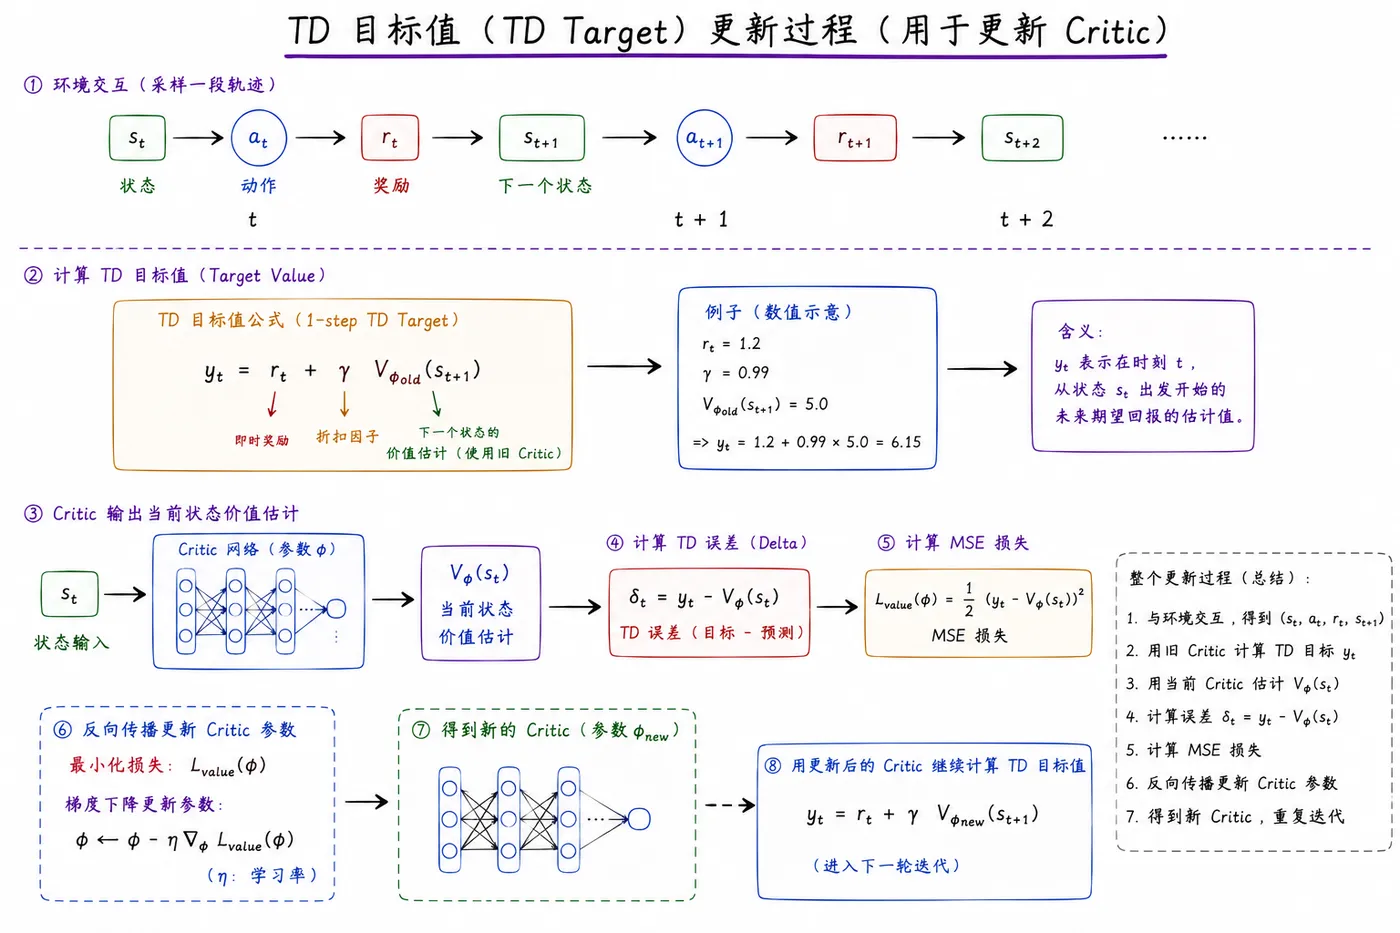
② Critic 网络更新(价值评估更新)
使用:MSE 均方误差损失
目的:让价值估计 V (s) 更准,从而让优势函数 A 更准。
输入:
状态 s
实际回报 G / TD 目标值
计算:
Critic 输出 V (s)
计算 V (s) 与 目标回报 的误差
MSE 损失反向传播更新 Critic
特点:
简单、稳定
帮助 Actor 获得更准确的优势信号
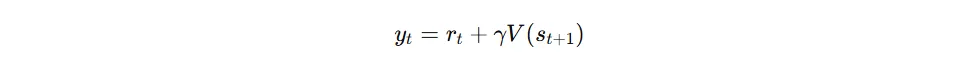

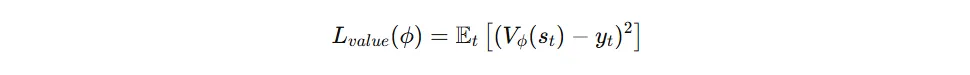


手动计算
当前执行 → 永远用旧策略动作
更新网络 → 只用新策略算旧动作的概率
新策略的动作,要等到【下一轮】才会执行!
广义优势估计

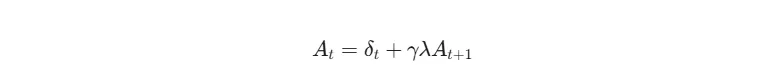
TD 误差(td_delta)
td_delta = 即时奖励 + 折扣×下一个状态价值 - 当前状态价值

GAE 优势(advantage)
advantage = 当前TD误差 + 衰减系数 × 下一步的advantage

td_delta = [10, 5, -10]
gamma * lamda = 0.81 (衰减系数)

t=2
r = -10
advantage = -10 + 0.81×0 = -10
r = 5
advantage = 5 + 0.81×(-10) = -3.1
r = 10
advantage = 10 + 0.81×(-3.1) = 7.489
GAE 优势 = [7.489, -3.1, -10]

模型更新(update)
gamma = 0.9
lamda = 0.9
clip_eps = 0.2      → 裁剪范围 [0.8, 1.2]
# 两条样本
state0 = [1.0, 0.0, 1.0, 0.0, 0.0, 0.0]
state1 = [0.9, 0.1, 0.8, 0.2, 0.5, 0.1]
action0 = 0
action1 = 2
advantage = [-0.82, -2.0]

新旧概率比 ratio
旧策略 s0 动作 0 概率 = 0.70
旧策略 s1 动作 2 概率 = 0.10
old_log_prob0 = ln(0.70) ≈ -0.357
old_log_prob1 = ln(0.10) ≈ -2.303
新策略 s0 动作 0 概率 = 0.91  → ratio≈1.3
新策略 s1 动作 2 概率 = 0.05
new_log_prob0 = ln(0.91) ≈ -0.094
new_log_prob1 = ln(0.05) ≈ -3.000
new_log_prob0 - old_log_prob0
= (-0.094) - (-0.357)
= 0.263
ratio0 = exp(0.263) ≈ 1.30
new_log_prob1 - old_log_prob1
= (-3.000) - (-2.303)
= -0.697
ratio1 = exp(-0.697) ≈ 0.50
ratio0 = 1.30   (超过 1.2,需要裁剪)
ratio1 = 0.50  (低于 0.8,需要裁剪)

PPO Clip 损失
adv0 = -0.82
adv1 = -2.0

part1 = 1.30 * (-0.82) = -1.066
part2 = clamp(1.30) → 1.2  → 1.2 * (-0.82) = -0.984
取 min:
min(-1.066, -0.984) = -1.066

part1 = 0.50 * (-2.0) = -1.0
part2 = clamp(0.50) → 0.8 → 0.8 * (-2.0) = -1.6
取 min:
min(-1.0, -1.6) = -1.6

策略损失 policy_loss
policy_loss = - [ (-1.066) + (-1.6) ] / 2
policy_loss = - [ -2.666 / 2 ]
policy_loss = - [ -1.333 ]
policy_loss = 1.333

价值损失 value_loss
V(s0) = -3.18
V(s1) = 0.0
td_target0 = -1.0 + 0.9*0 = -1.0
td_target1 = 0.0
loss0 = (-3.18 + 1.0)^2 = ( -2.18 )^2 = 4.75
loss1 = 0
value_loss = (4.75 + 0)/2 = 2.375

手算结果
ratio0        = 1.30
ratio1        = 0.50
policy_loss   = 1.333
value_loss    = 2.375