索引基础:B+树详解
大家好,我是一名拥有10年以上经验的DBA老兵。
做这个系列,源于一个朴素的愿望:把踩过的坑、总结的经验系统化输出,希望能帮到刚入行或想进阶的兄弟们。
让我们开始今天的第5天内容。
背景引入
💡 说白了:索引就是一本书的目录。没有目录,你想找"事务"这个词,只能一页一页翻;有了目录,直接翻到对应页码。
很多同学知道索引能加速查询,但面试官一问"B+树为什么比B树适合做索引?""为什么不用二叉树?"——就懵了。
今天的目标:搞懂B+树结构,面试必问!
核心概念
一、没有索引会怎样?
没有索引时,MySQL只能全表扫描——从第一行开始,逐行对比,直到找到目标。
-- 没有索引时,查找name='张三'要扫描全表
SELECT * FROM user WHERE name = '张三';

-- EXPLAIN 查看执行结果(type=ALL,说明全表扫描)
-- type列值:ALL → 全表扫描,性能最差
假设一张表100万行,找一个值最多要对比100万次。这就是为什么索引这么重要。
二、为什么是B+树?
面试官喜欢问:为什么MySQL索引用B+树,而不是二叉树、哈希表?
我们逐个对比:
| 数据结构 | 查找复杂度 | 适合场景 | 不适合做索引的原因 |
|---|---|---|---|
| 二叉搜索树 | O(log n) | 内存查找 | 树太高,磁盘IO多 |
| 哈希表 | O(1) | 等值查找 | 不支持范围查询 |
| B树 | O(log n) | 早期数据库 | 非叶子节点存数据,一次IO拿到的key少 |
| B+树 | O(log n) | MySQL InnoDB | ✅ 叶子节点存数据,非叶子节点只存key |
💡 说白了:B+树就像一栋楼——电梯口(非叶子节点)只放楼层号,每间房(叶子节点)放真正的数据。电梯口越小,一层能放的楼层号越多,树就越矮,IO就越少。
三、B+树的关键特征
3.1 非叶子节点只存key,不存数据
好处:非叶子节点只存key,一个页(16KB)能存更多key,树更矮,IO更少。
3.2 叶子节点用双向链表连接
这是B+树和B树最大的区别——B+树的叶子之间有指针,B树没有。
好处:
- 范围查询极快:找到起点后,顺着链表往后扫就行
- 排序查询天然有序:ORDER BY不用额外排序
💡 说白了:B+树的叶子像一排人手拉手,找到第一个人,后面的跟着就出来了。B树呢?每找一个人都要重新回上一层找,效率差远了。
面试必问:
- B+树和B树有什么区别?
- 为什么MySQL用B+树而不是B树做索引?
📝 面试解答:
Q: B+树和B树有什么区别?
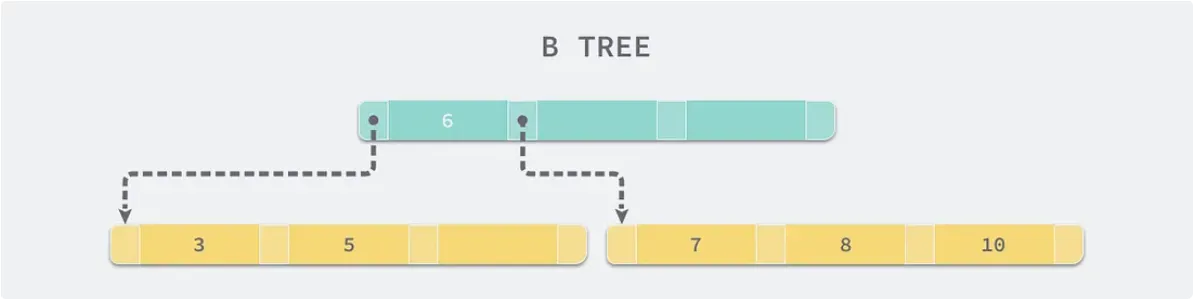
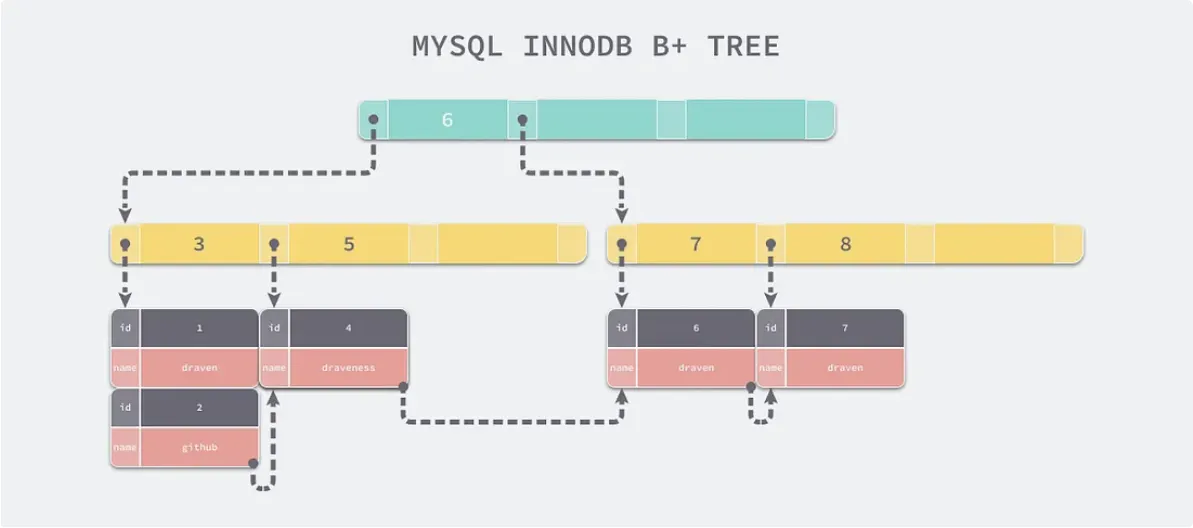
三个核心区别:
- 非叶子节点:B+树只存key,B树存key+数据 → B+树一个页能存更多key,树更矮
- 叶子节点:B+树所有数据都在叶子,B树数据分散在各层 → B+树查询稳定,都是O(log n)
- 叶子链表:B+树叶子之间有双向链表,B树没有 → B+树范围查询极快
Q: 为什么MySQL用B+树而不是B树做索引?
- IO更少:B+树非叶子只存key,同样16KB的页能存更多key,树更矮,IO次数更少
- 范围查询更快:叶子之间有链表,找到起点后顺着扫就行;B树要中序遍历
- 查询更稳定:所有数据都在叶子节点,每次查询路径长度一样
四、InnoDB的索引结构
InnoDB有两种索引:聚簇索引和二级索引。
4.1 聚簇索引(主键索引)
聚簇索引的叶子节点存的是整行数据。
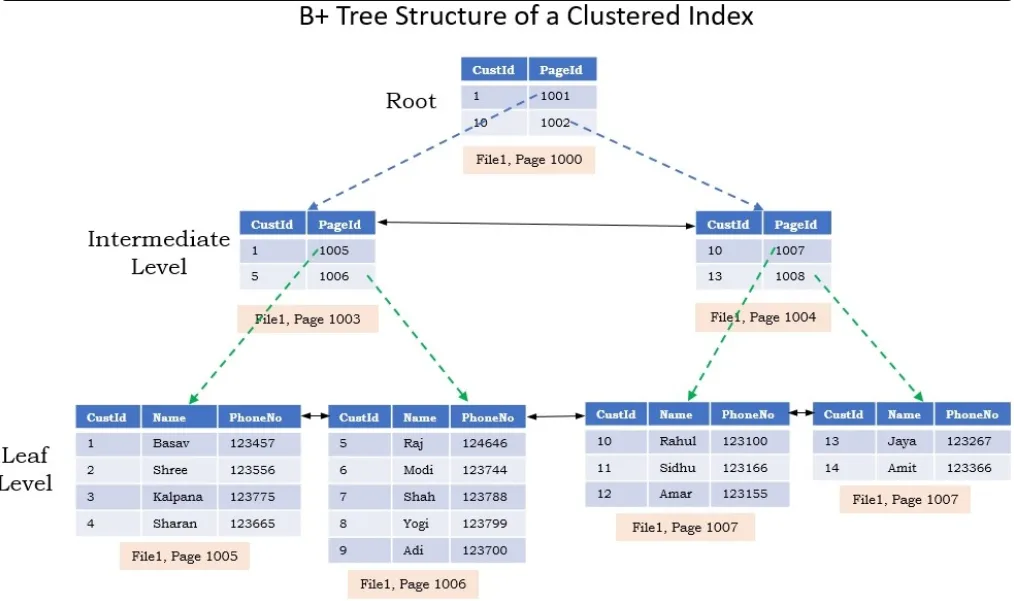
💡 聚簇索引 = 数据本身。InnoDB的数据就是按主键顺序存的,所以主键查询是最快的。
4.2 二级索引(非主键索引)
二级索引的叶子节点存的是主键值,不是整行数据。
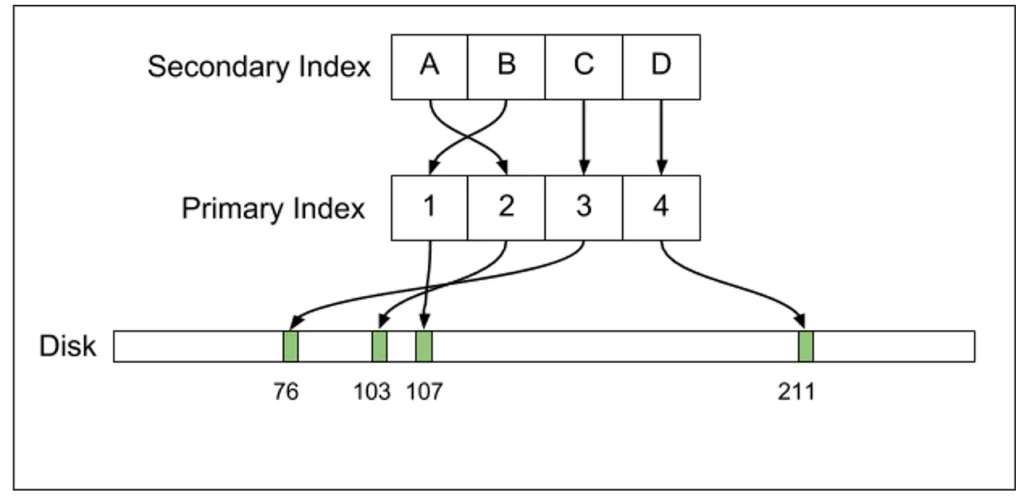
查name='张三',先用二级索引找到主键id=30,再回聚簇索引找整行数据——这个过程叫回表。
面试必问:
- 什么是聚簇索引?什么是二级索引?
- 什么是回表?
📝 面试解答:
Q: 什么是聚簇索引?什么是二级索引?
- 聚簇索引:叶子节点存整行数据,数据按主键顺序存储。一张表只有一个聚簇索引。
- 二级索引:叶子节点存主键值,查到主键后需要回聚簇索引取完整数据。
Q: 什么是回表?
通过二级索引找到主键值,再回聚簇索引查整行数据的过程叫回表。
回表意味着多一次B+树查找,所以二级索引比主键索引慢。
避免回表的方法:覆盖索引(后续章节讲)——让查询只需要走二级索引就能拿到所有需要的列。
实战案例
场景一:查看索引结构
-- 创建测试表及执行结果
CREATE TABLE t_index_demo (
    id INT PRIMARY KEY AUTO_INCREMENT,
    name VARCHAR(50),
    age INT,
    INDEX idx_name (name)
) ENGINE=InnoDB;

-- 查看索引
SHOW INDEX FROM t_index_demo;
-- 结果:会看到两个索引
-- 1. PRIMARY(聚簇索引,列id)
-- 2. idx_name(二级索引,列name)

-- 用EXPLAIN观察索引使用
EXPLAIN SELECT * FROM t_index_demo WHERE id = 1;
-- type=const,走主键索引,最快

EXPLAIN SELECT * FROM t_index_demo WHERE name = '张三';
-- type=ref,走二级索引,需要回表
场景二:观察回表过程
-- 回表示例及执行结果
-- 只查主键,不需要回表
EXPLAIN SELECT id FROM t_index_demo WHERE name = '张三';
-- Extra: Using index → 覆盖索引,不回表!

-- 查所有列,需要回表
EXPLAIN SELECT * FROM t_index_demo WHERE name = '张三';
-- Extra: NULL 或 Using where 或留空 → 回表查询
💡 说白了:查
id不回表(二级索引叶子就有),查*要回表(二级索引叶子没age等列)。
场景三:B+树的分裂
-- 顺序插入(主键自增,不分裂)
-- InnoDB主键自增时,B+树顺序追加,不会发生页分裂
INSERT INTO t_index_demo (name, age) VALUES ('张三', 25);
INSERT INTO t_index_demo (name, age) VALUES ('李四', 30);
-- ... 顺序插入,性能好

-- 乱序插入(可能触发页分裂)
-- 如果主键不是自增的,插入可能触发B+树的页分裂,导致性能下降
💡 这也是为什么主键推荐自增——顺序插入不会触发页分裂,性能最好。
避坑指南
⚠️ 真实踩过的坑:
主键乱序导致页分裂
- 主键不是自增的(如UUID),插入时B+树频繁分裂
- 建议用自增主键,顺序插入效率最高
二级索引回表导致慢查询
SELECT *走二级索引必须回表,比主键索引慢- 能用覆盖索引就用覆盖索引,避免回表
索引列数据太大影响B+树高度
- 索引列越短,一页存越多key,树越矮
- VARCHAR(255)做索引比INT做索引,树更高更多IO
混淆聚簇索引和二级索引
- 聚簇索引只有一张表一个,就是主键
- 二级索引叶子存的是主键值,不是数据行指针
思考题
🤔 互动时间:
- 为什么InnoDB表必须有主键?如果没有定义主键会发生什么?
- 覆盖索引为什么不需要回表?
总结
🎯 面试考点
- B+树 vs B树:非叶子只存key、叶子有链表、查询稳定
- 聚簇索引:叶子存整行数据,按主键顺序存储
- 二级索引:叶子存主键值,需要回表
- 回表:二级索引→主键值→聚簇索引→整行数据
- 自增主键避免页分裂,性能最优
💡 AI实战建议:让自己的AI助手记住建表规范检查清单,每次写CREATE TABLE时自动检查:
- 必须有主键,且推荐自增
- 索引命名遵循规范:普通索引以
idx_开头,唯一索引以uk_开头- 联合索引列数不超过5列
下期预告:索引优化:何时建索引、何时不建 —— 面试必问!
全本合集:《每天一个MySQL知识点,百日打怪升级》 您的关注是我每日更新的动力
有问题欢迎评论区交流,明天见!