【故障定位系列】波动度故障

简介: 本文探讨SQL耗时故障的自适应定位方法,针对不同波动程度的故障,提出通过自学习正常区间特征(如方差、标准差)实现异常检测,并结合上下游响应时间比例关系判断根因,辅以实战案例验证定位准确性。

原文地址:https://www.databuff.com/infoDetail/blog99

耗时波动不同,会产生不同程度的故障,如何自适应定位?

01 故障场景

有如下2个同样类型的故障:

● 故障A

某个SQL的耗时故障(耗时更长,造成的影响大)

● 故障B

某个SQL的耗时故障(耗时相对短,造成的影响小)
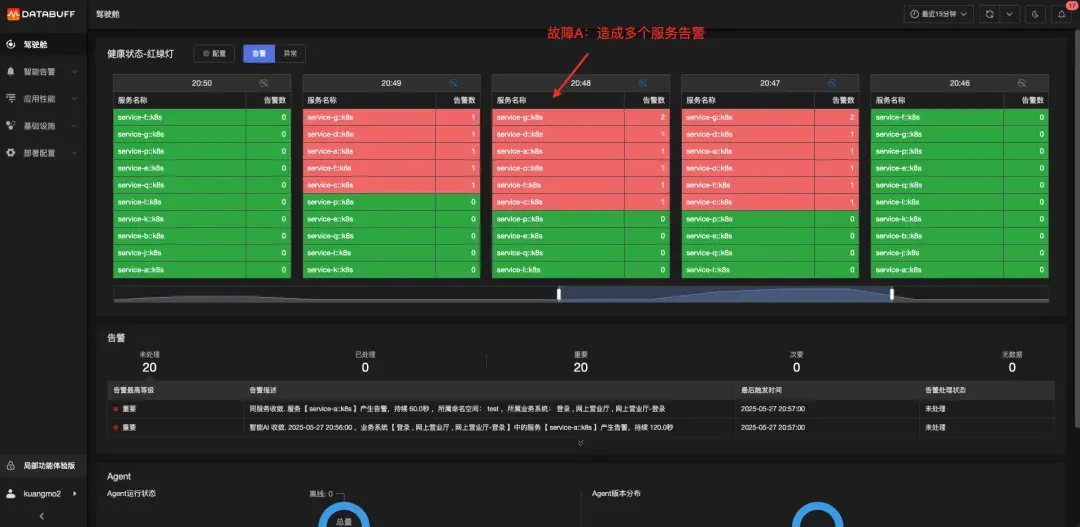
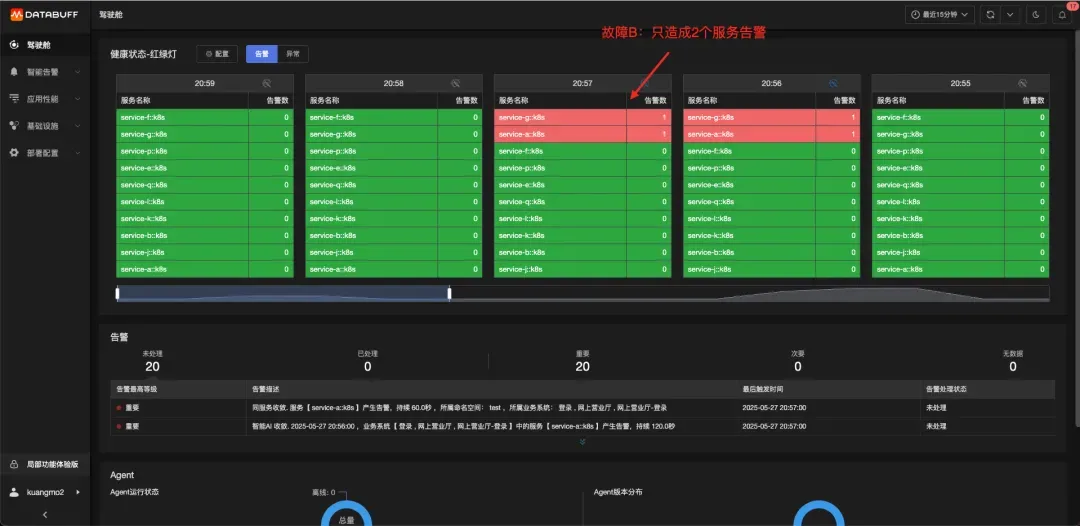
image.png

image.png

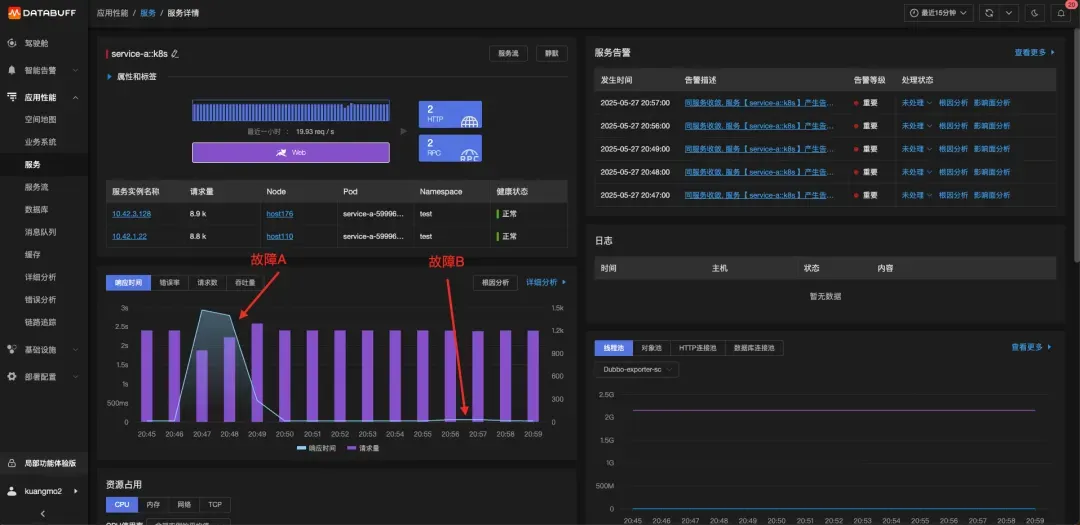
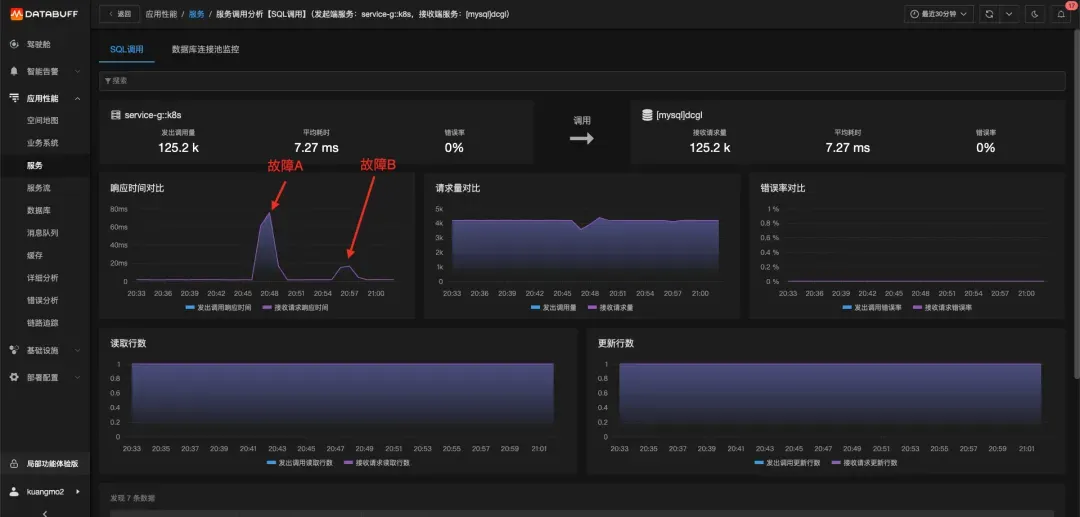
其中某个服务在2个故障中的表现如下:
image.png

可以明显看出,这2次故障造成的耗时波动是不一样的,那这里就引出一个定位难点:如何能自适应不同程度的故障呢?

02 定位难点

要想适应不同程度的故障,需要做到如下2点:

● 异常检测需要自适应不同的波动度

● 上下游根因的界定如何适应不同的波动度

2.1 异常检测需要自适应不同的波动度

要想做到自适应,就必须先做到自学习,即对当前曲线的正常时间段的曲线波动进行学习
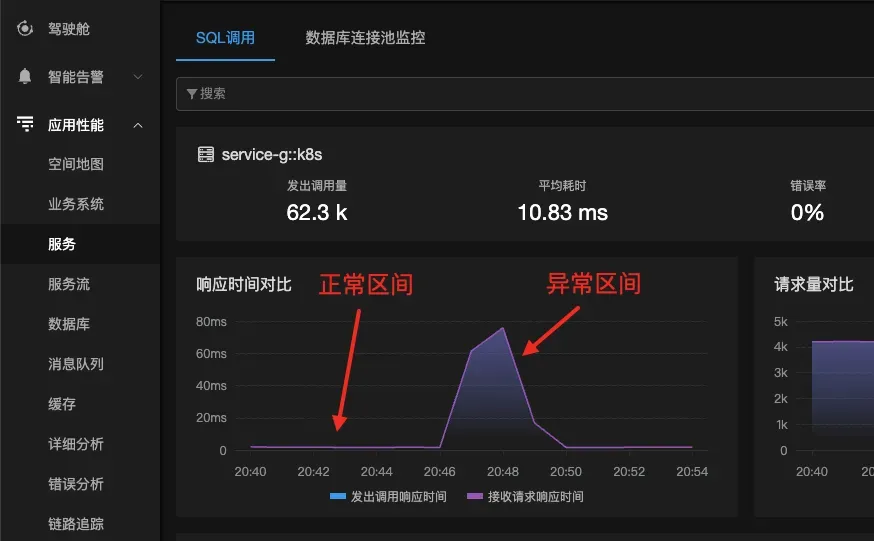
image.png

学习正常区间内的一些特征值:最大值、最小值、中位数、平均值、方差、标准差动态等计算出波动幅度,一旦响应时间波动大计算出的波动幅度也大,响应时间的波动小计算出的波动幅度也小,这样就容易适配不同的波动幅度了。

再对异常区间进行异常检测:是否超过波动幅度,如果超过则认为异常,同时标记出异常范围。

这里又引出了一个难点:如何界定出一段正常区间。

一般通过告警来触发定位,因此可以将告警前几十分钟作为一个正常区间。

2.2 上下游根因的界定如何适应不同的波动度
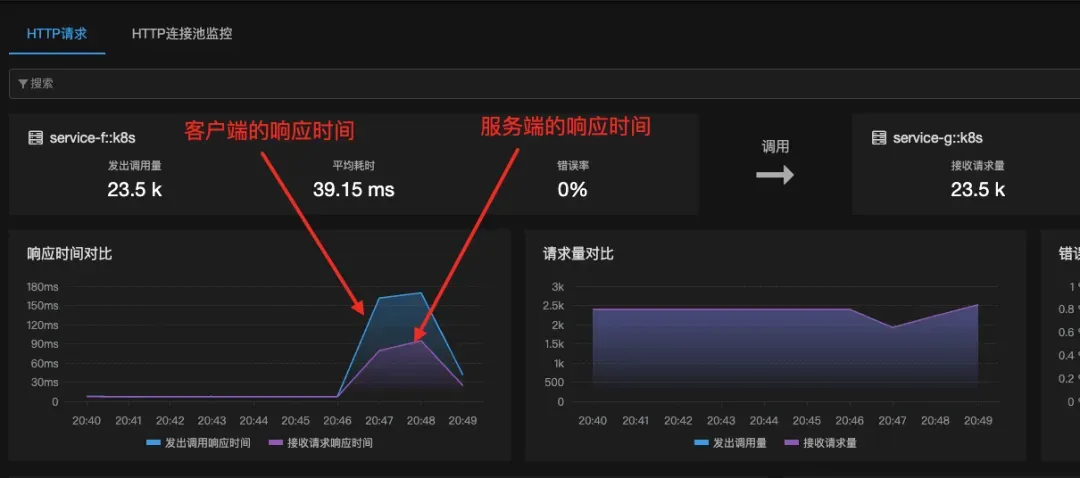
image.png

通常大家认为:客户端的响应时间上升了。

● 如果服务端的响应时间也上升了,则认为是服务端的问题

● 如果服务端的响应时间没变化,则认为是客户端自身或者网络的问题

上述逻辑其实也涉及到一个波动度的问题,上图看起来是服务端造成了客户端的波动,但是如果服务端波动度再小一些,这时再去界定客户端还是服务端的问题就很难了。

有什么解决办法呢?

可以配置一定的比例关系,如果2者响应时间的比例关系超过一定的比例再认为他们不相关,即并不是服务端造成了客户端的问题。

这时候可能没法仅仅从这个点来判定到底是服务端还是客户端的问题,还是需要一个更综合的判断。

03 实战案例

我们到RootTalk Sandbox上进行上述故障场景的复现。

RootTalk Sandbox是一个故障演练和定位的系统,可以进行多种故障场景的复现,目前开放注册。

地址:https://sandbox.databuff.com/

3.1 故障注入

注入一个中度的故障。
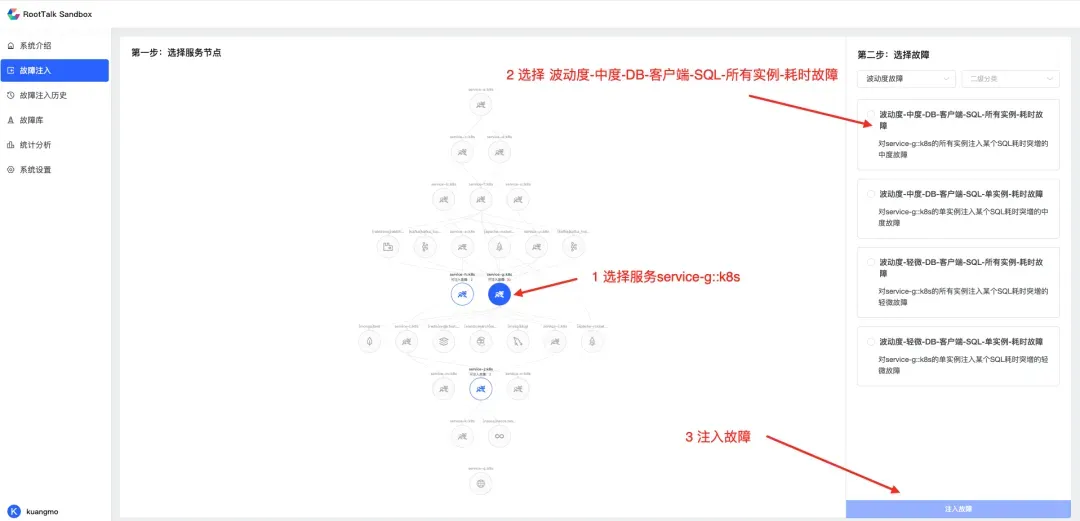
image.png

然后再按照上述操作注入一个轻微的故障。

注入后等待2~3分钟,可直接点击跳转到Databuff的故障定位平台。

3.2 故障定位

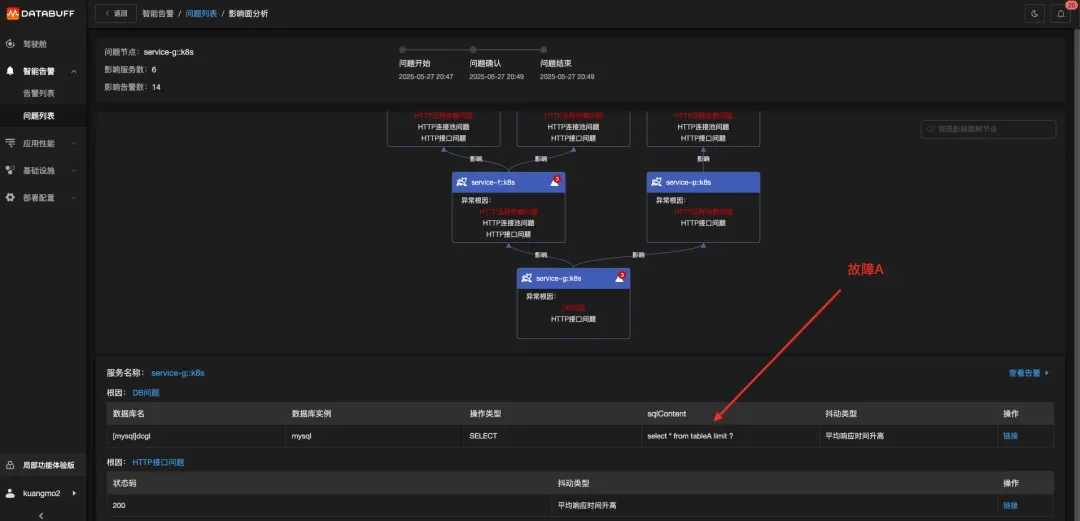
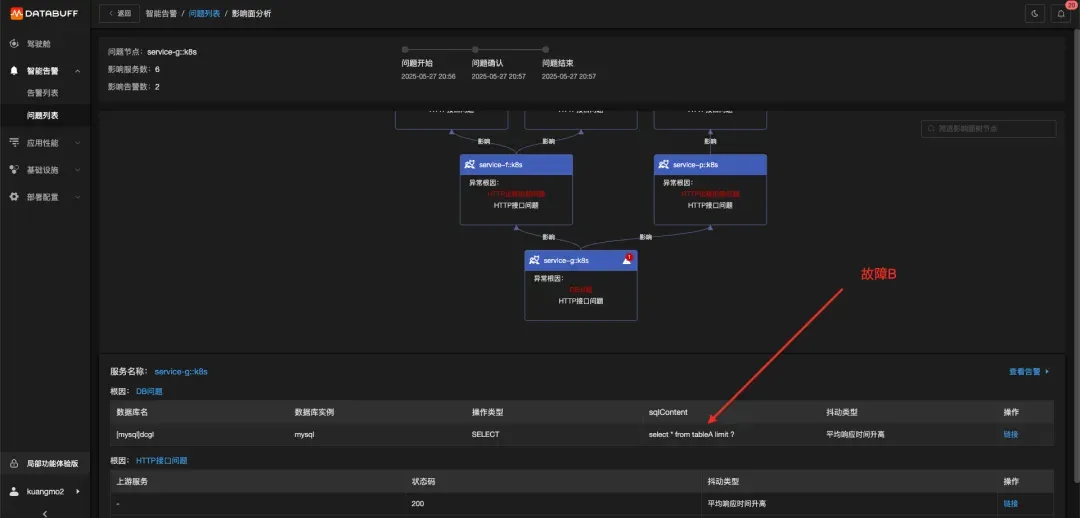
登录Databuff后可以看到2次都能准确定位到故障。
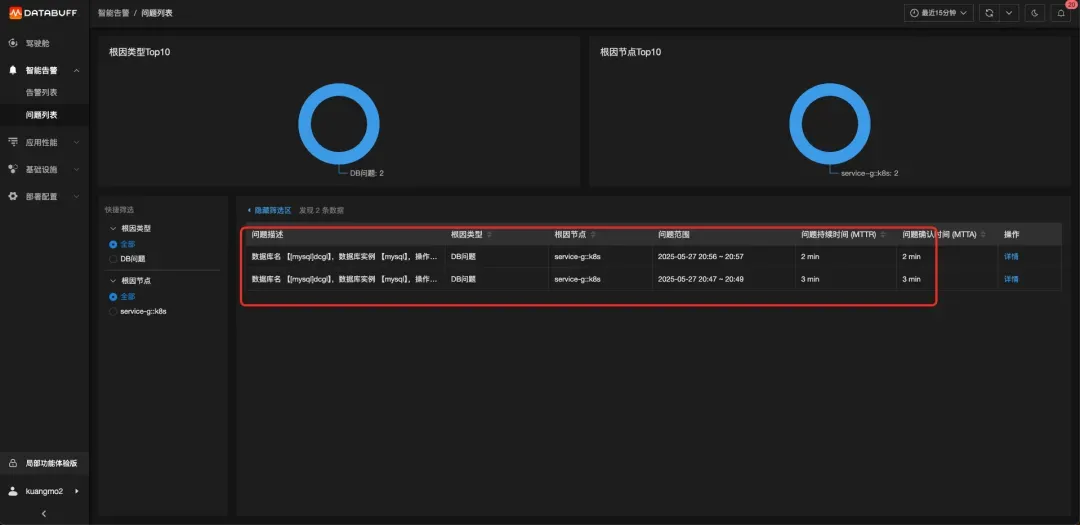
image.png

并且2次故障的波动幅度确实不一样。

image.png

但是最终都能准确定位到是某个SQL的故障。

image.png

image.png

相关文章
|
SQL 存储 监控
深入可观测底层:OpenTelemetry 链路传递核心原理
本文会系统讲解链路传递一些基本概念,同时结合案例讲解链路传递的过程。
3999 1
深入可观测底层:OpenTelemetry 链路传递核心原理
|
12月前
|
运维 监控 数据可视化
别让运维跪着查日志了!给老板看的“业务观测”大盘才是真香
深夜告警、业务暴跌、全员背锅?一次支付故障暴露传统监控盲区。我们通过业务观测,将技术指标转化为老板听得懂的“人话”,实现从被动救火到主动洞察的跨越。让技术团队不再跪着查日志,而是站着驱动业务增长。
别让运维跪着查日志了!给老板看的“业务观测”大盘才是真香
|
消息中间件 数据采集 监控
ELK搭建(五):linux系统日志监控平台搭建
现在的生产系统多使用linux系统,在实际生产过程中我们除了需要监控一些业务日志之外,有时也需要监控linux系统本身的日志,来帮助我们进行一些排错和判断。那么这一期,我们就针对linux系统日志监控平台的搭建来进行讲解 与往期一样,我们针对实际搭建教程更多是快速搭建为主,不做过多的原理性讲解,这一类讲解我们放到后期单独开几期博客来探讨。
1700 0
ELK搭建(五):linux系统日志监控平台搭建
|
12月前
|
存储 运维 监控
云原生NPM与传统NPM的差异
本文对比传统NPM与云原生NPM在部署、流量采集、资源影响等方面的差异,聚焦Packet处理,分析二者优劣。随着eBPF等新技术应用,云原生NPM正加速发展,助力高效网络监控与故障定位。
|
Kubernetes Java Go
Cloud Naive最佳开发实践
经过多年的工作,我们的精神导师John领悟了java那一套docker in docker的艺术并带到golang项目架构设计中。
657 49
|
存储 SQL Prometheus
图文解析带你精通时序PromQL语法
[阿里云SLS可观测团队发布] 本文通过图文解析深入讲解PromQL的计算原理,涵盖其与SQL的差异、时间线模型、选点机制、聚合函数、窗口函数及常见非预期场景,帮助用户掌握PromQL的核心语法与执行逻辑。
1499 10
|
存储 运维 开发工具
警惕日志采集失败的 6 大经典雷区:从本地管理反模式到 LoongCollector 标准实践
本文总结了日志管理中的六大反模式及优化建议,涵盖日志轮转、存储选择、并发写入等常见问题,帮助提升日志采集的完整性与系统可观测性,适用于运维及开发人员优化日志管理策略。
550 5
|
12月前
|
机器学习/深度学习 人工智能 前端开发
终端里的 AI 编程助手:OpenCode 使用指南
OpenCode 是开源的终端 AI 编码助手,支持 Claude、GPT-4 等模型,可在命令行完成代码编写、Bug 修复、项目重构。提供原生终端界面和上下文感知能力,适合全栈开发者和终端用户使用。
61597 11
|
存储 前端开发 数据可视化
Grafana Loki,轻量级日志系统
本文介绍了基于Grafana、Loki和Alloy构建的轻量级日志系统。Loki是一个由Grafana Labs开发的日志聚合系统,具备高可用性和多租户支持,专注于日志而非指标,通过标签索引而非内容索引实现高效存储。Alloy则是用于收集和转发日志至Loki的强大工具。文章详细描述了系统的架构、组件及其工作流程,并提供了快速搭建指南,包括准备步骤、部署命令及验证方法。此外,还展示了如何使用Grafana查看日志,以及一些基本的LogQL查询示例。最后,作者探讨了Loki架构的独特之处,提出了“巨型单体模块化”的概念,即一个应用既可单体部署也可分布式部署,整体协同实现全部功能。
6908 189
Grafana Loki,轻量级日志系统
|
Arthas 监控 Java
拥抱 OpenTelemetry:阿里云 Java Agent 演进实践
本文介绍了阿里云 Java Agent 4.x 版本在基于 OTel Java Agent 二次开发过程中的实践与思考,并重点从功能、性能、稳定性、兼容性四个方面介绍了所做的工作。同时也介绍了阿里云可观测团队积极参与开源建设取得的丰厚成果。
1740 139
拥抱 OpenTelemetry:阿里云 Java Agent 演进实践