【Azure Entra ID】当Entra ID中的用户所属Group数量超过200个之后的问题

简介: Azure Entra ID中,当用户所属组超过200个时,ID Token仅返回endpoint。通过配置组筛选(Group Filtering),可按应用需求过滤并直接返回指定组列表,避免获取全部组,提升效率。

问题描述

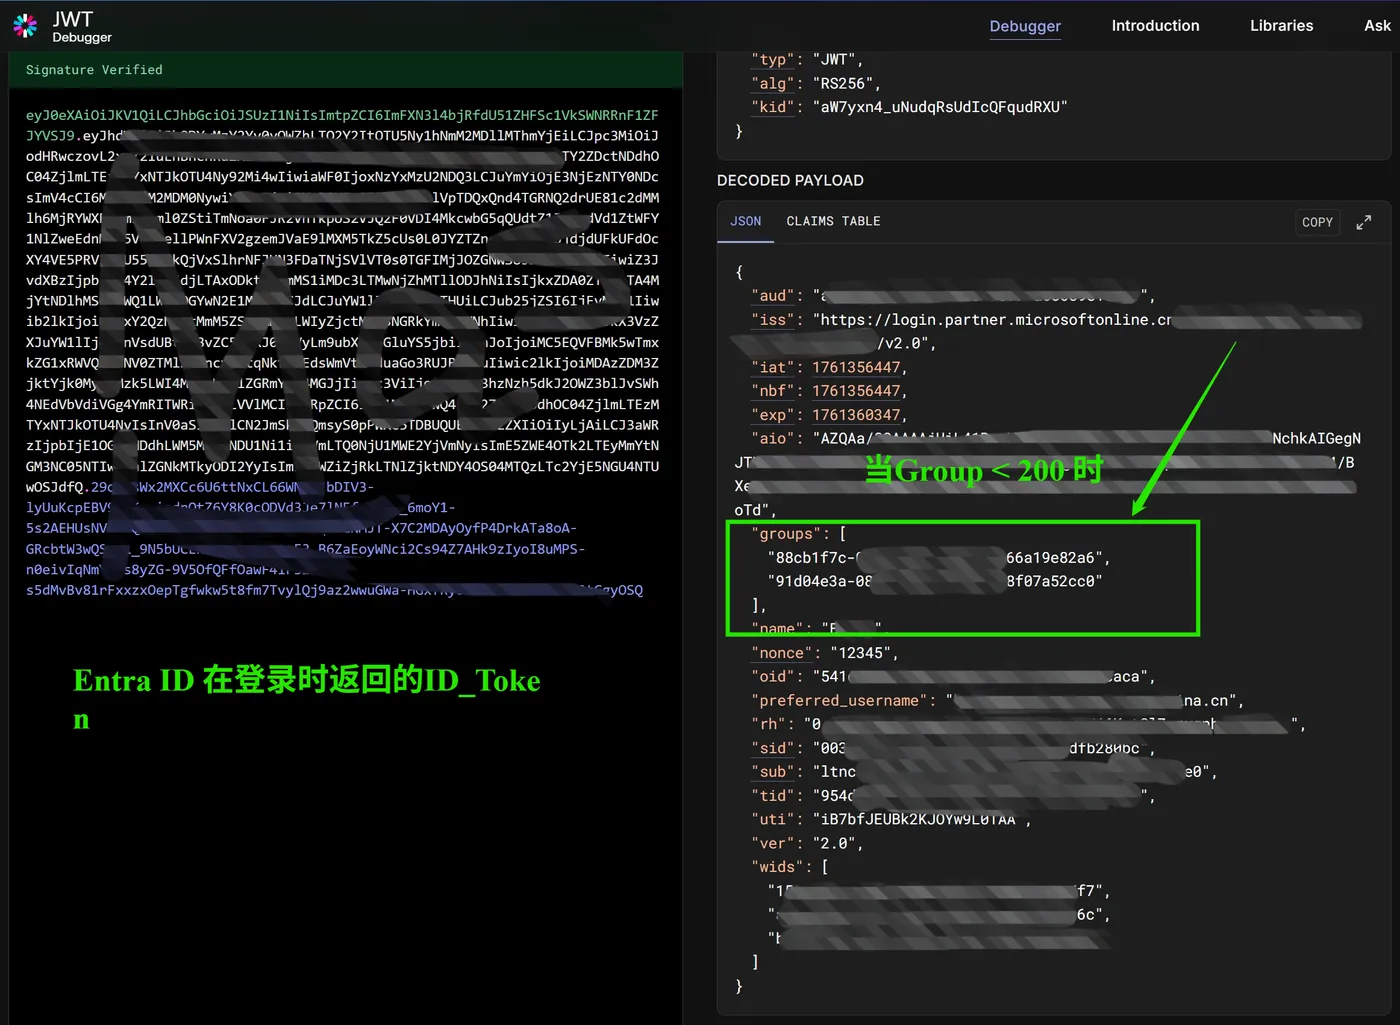
使用Azure Entra ID进行用户的登录授权管理,但是当这个用户所属的组(Group)超过200个之后,在ID Token中就无法全部包含,而是返回一个endpoint,需要再次通过这个Endpoint来获取完整的Group List。


例如:

## 在Group < = 200 的时候
 

## 在Group > 200 的时候
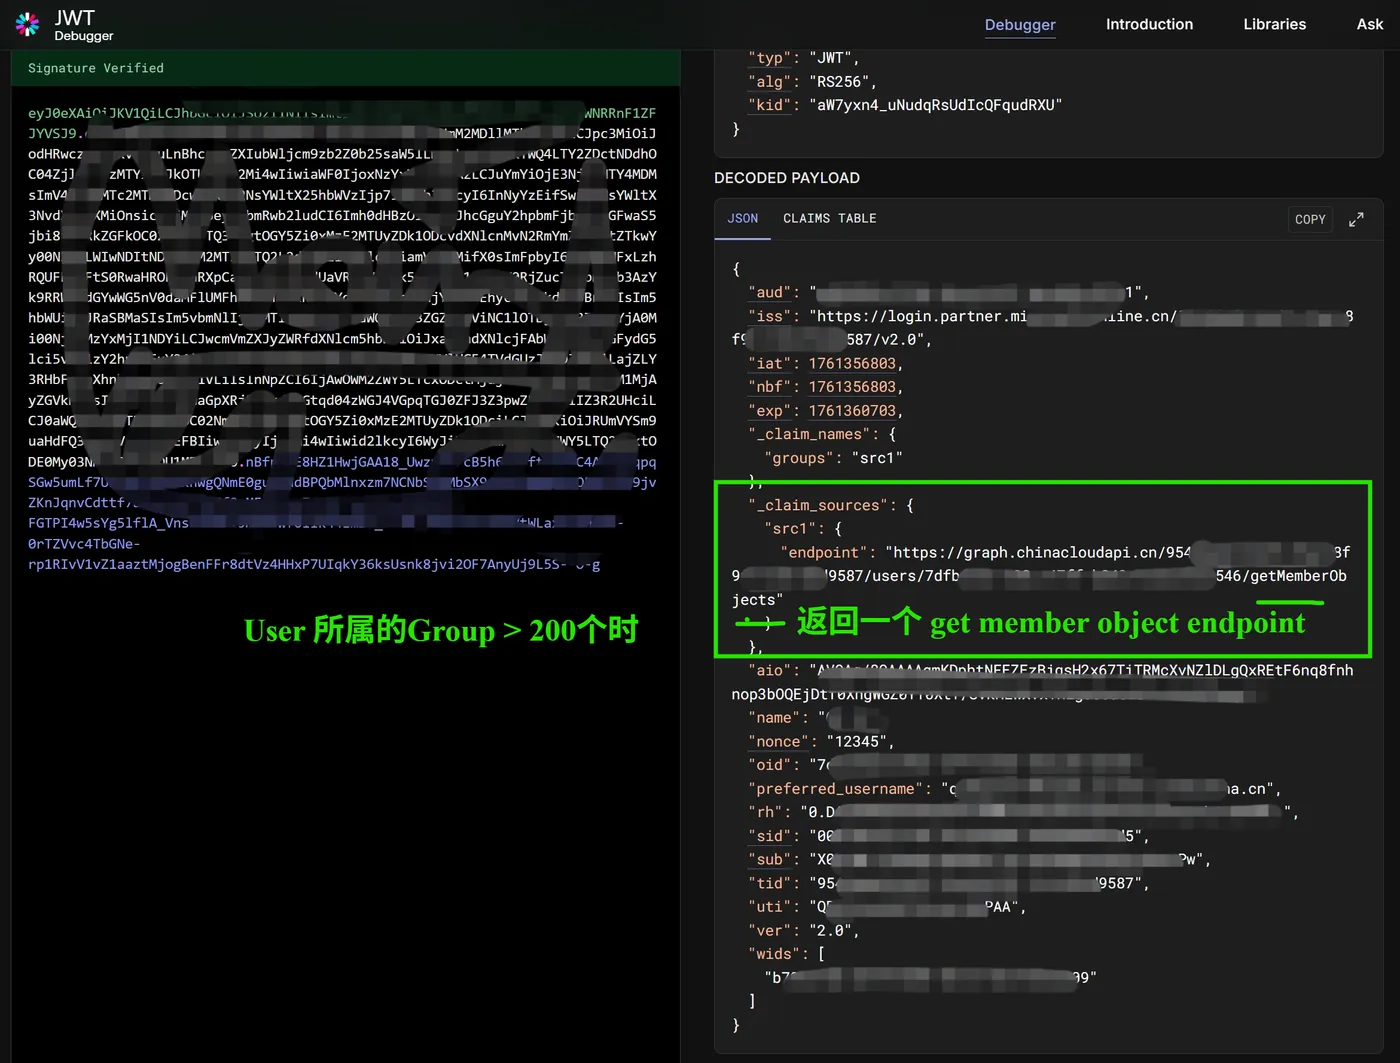
那么,是否有办法当Group 大于200的情况下,也可以直接返回所需要的Group list呢?在我们常规的请求中,根本不需要获取一个用户的全部组,只需要获取当前应用所使用的Group呢?


问题解答

可以的。 Entra ID提供了一个 Group Filtering 的功能来过滤用户的用户组(Group), 这样就可以有效的解决Group超过200个之后的ID Token中无法直接返回的问题。

Group filtering [Configure group claims for applications by using Microsoft Entra ID - Microsoft Entra ID | Microsoft Learn]

Group filtering allows for fine control of the list of groups that's included as part of the group claim. When a filter is configured, only groups that match the filter will be included in the group's claim that's sent to that application. The filter will be applied against all groups regardless of the group hierarchy.


具体的操作步骤如下:

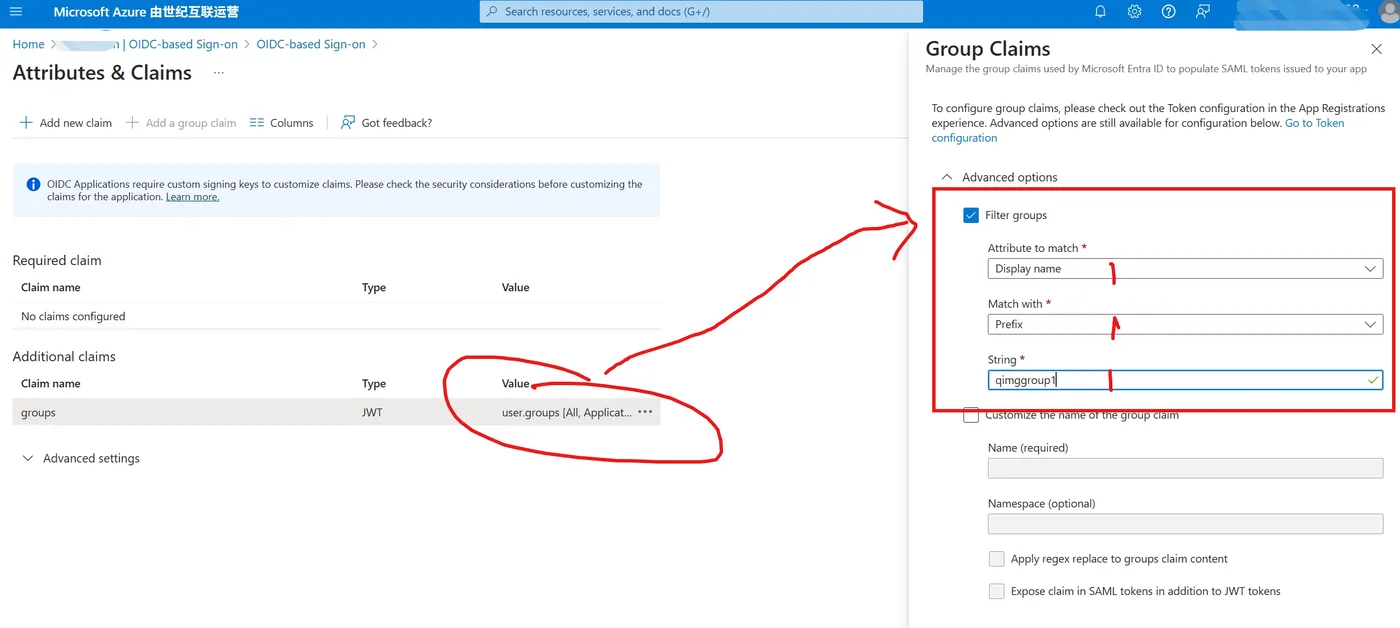
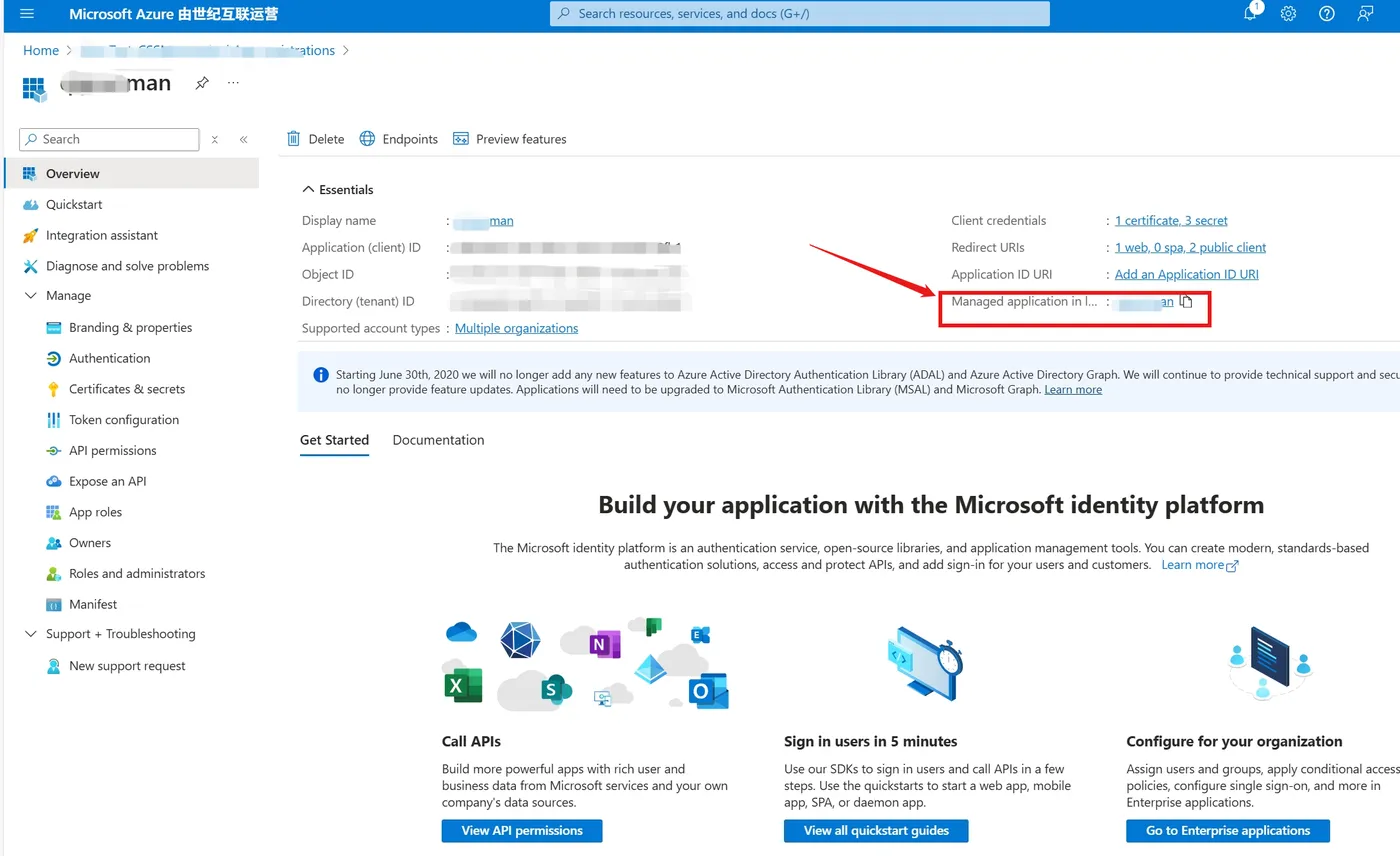
1) 进入Azure Entra ID页面,进入到“注册应用”页面,在 概述(overview)页面上点击“Managed Application in ....”,进入此应用的“企业应用”页面
2) 选择“Single sign-on”后,编辑group属性
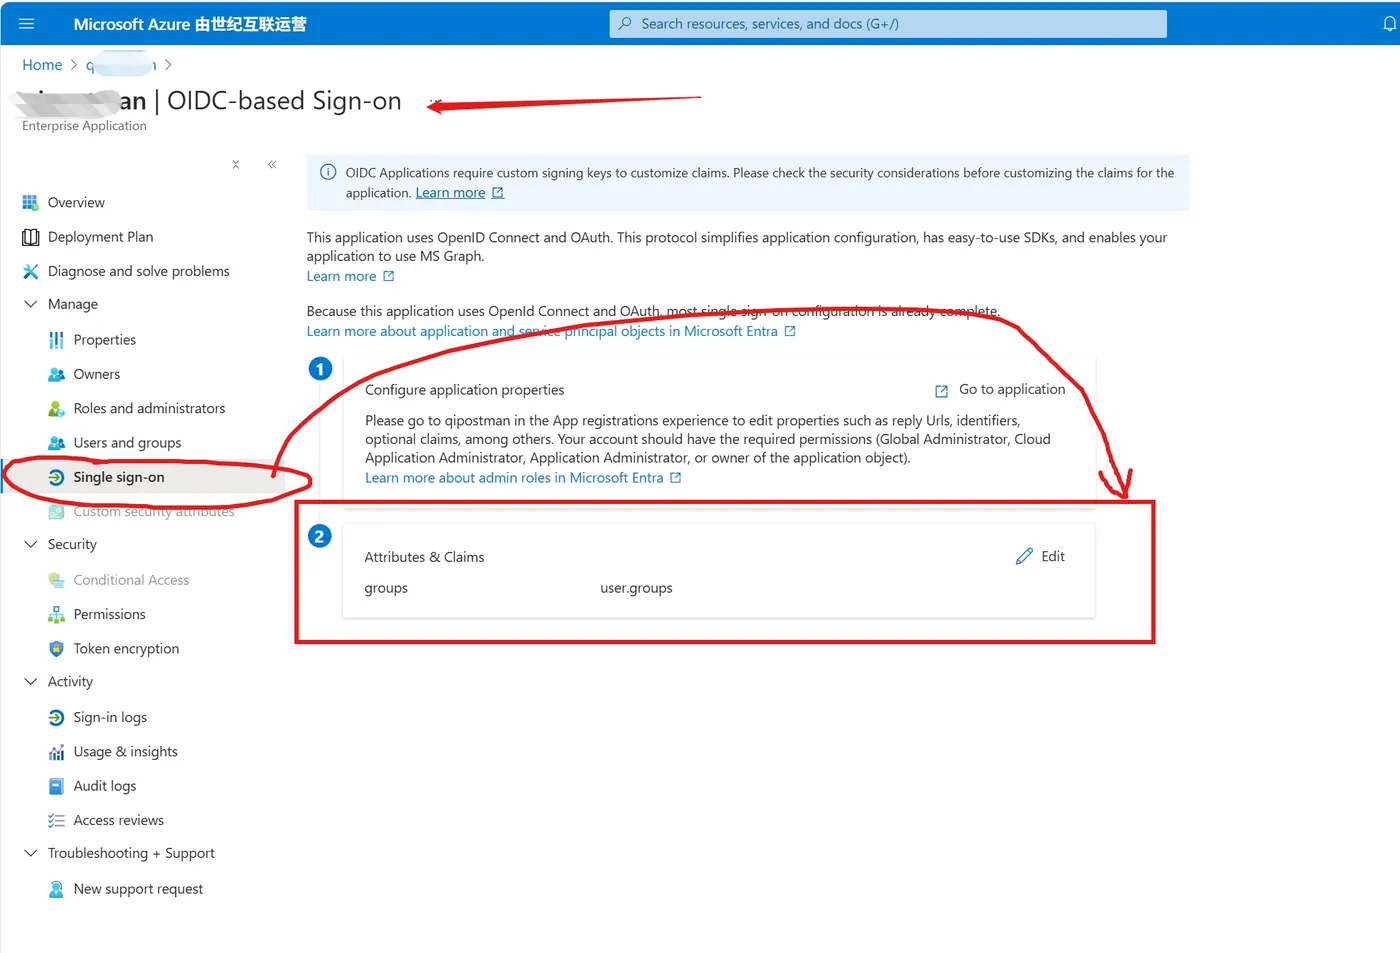
3)在Additional Claims 部分,选择groups,在右侧弹出页面中的 Advanced Options中,启用Filter Groups

  • Attribute to Match就选择Display name (注:display name就是group的name)
  • Match with 根据需求,可以选择前缀匹配(Prefix),后缀匹配(Suffix),包含(Contains)
  • String 就填写我们需要过滤组的名称的关键字

保存。


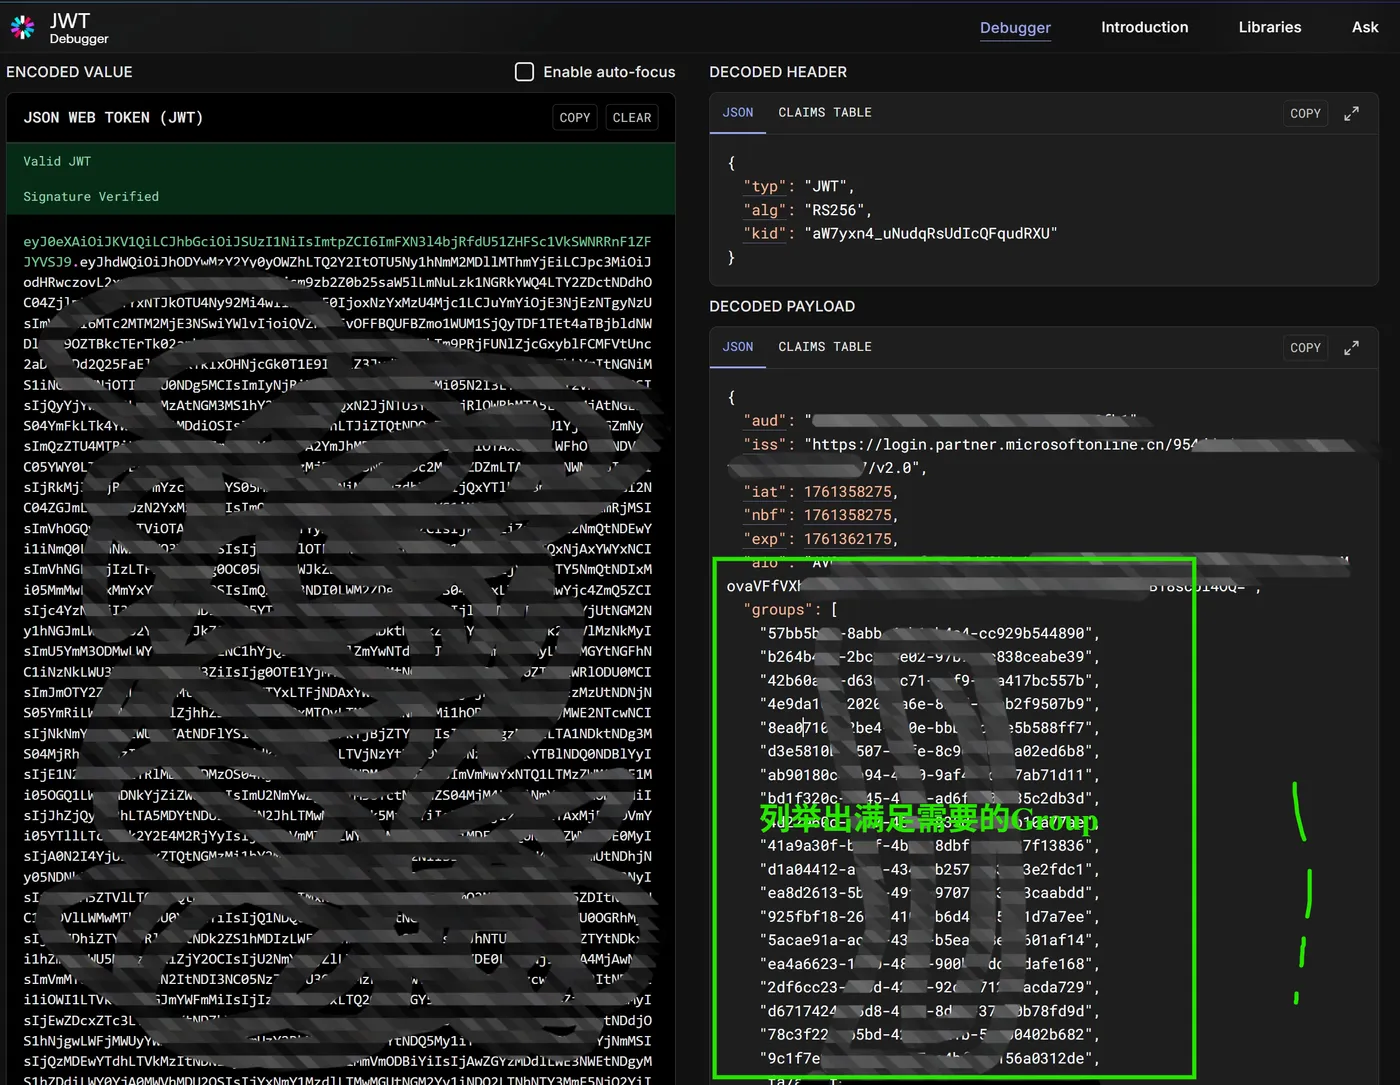
再次请求,就可以看见ID Token中的Group信息已经列举出所想要的Group List了。


参考资料

Configure group claims for applications by using Microsoft Entra ID : https://learn.microsoft.com/en-us/entra/identity/hybrid/connect/how-to-connect-fed-group-claims#group-filtering


当在复杂的环境中面临问题,格物之道需:浊而静之徐清,安以动之徐生。 云中,恰是如此!
相关文章
|
Kubernetes Java Go
Cloud Naive最佳开发实践
经过多年的工作,我们的精神导师John领悟了java那一套docker in docker的艺术并带到golang项目架构设计中。
657 49
|
12月前
|
存储 算法 Java
深入理解JVM:内存管理与垃圾回收机制探索
JVM是Java程序的运行核心,实现跨平台、自动内存管理与高效执行。其架构包括类加载、运行时数据区、执行引擎等模块。内存模型历经演变,JDK 8起以元空间替代永久代,优化GC性能。JVM通过分代回收机制,结合标记清除、复制、整理等算法,管理对象生命周期,提升系统稳定性与性能。
|
8月前
|
JSON 安全 算法
JWT基础详解
JWT(JSON Web Token)是一种开放标准(RFC 7519),用于安全传递声明。它通过Header.Payload.Signature三部分构成,支持签名/加密,实现无状态跨域认证,减轻服务器存储压力,广泛应用于现代Web和微服务鉴权场景。
876 0
|
12月前
|
数据采集 Cloud Native 网络协议
一篇文章带你了解云原生NPM数据采集和指标计算方法
本文介绍云原生NPM中如何采集TCP连接数据,计算网络指标,并关联应用进程。通过构建包含四元组、收发字节数、延迟等字段的数据结构,结合抓包与系统命令获取PID、UID等信息,实现网络与应用的联动分析,助力快速定位故障根源。
一篇文章带你了解云原生NPM数据采集和指标计算方法
|
存储 人工智能 Serverless
企业级 AI Agent 开发指南:基于函数计算 FC Sandbox 方案实现类 Chat Coding AI Agent
本文深入解析AI Agent系统架构,特别是以Sandbox为核心的落地实践。聚焦泛Chat模式下AI应用的挑战与解决方案,涵盖会话亲和性、隔离性、存储机制、会话恢复、资源弹性等关键技术点,阿里云函数计算(FC)为 AI Agent 系统在企业中的落地实践提供实际解决方案,展示了如何高效、安全地构建可扩展的 AI 应用系统。
1159 11
|
运维 监控 Cloud Native
设计与构建 FinOps 流程、团队、体系与目标
企业 FinOps 实施不是一蹴而就的项目,如果您正在推进企业云原生 FinOps 落地,除了选择合适的技术手段,企业内部的流程和体系建设也尤为重要。
165062 137
|
存储 安全 算法
从哈希到挑战响应,密码传输安全解析
本文解析从明文、哈希到挑战-响应等多种传输机制,揭示其优势与隐患,助你掌握安全本质,选对防护方案,让密码“传得安全,用得放心”。
638 0
|
存储 数据挖掘 数据处理
Apache Paimon 是一款高性能的数据湖框架,支持流式和批处理,适用于实时数据分析
【10月更文挑战第8天】随着数据湖技术的发展,越来越多企业开始利用这一技术优化数据处理。Apache Paimon 是一款高性能的数据湖框架,支持流式和批处理,适用于实时数据分析。本文分享了巴别时代在构建基于 Paimon 的 Streaming Lakehouse 的探索和实践经验,包括示例代码和实际应用中的优势与挑战。
1024 1
|
存储 分布式计算 Apache
官宣|Apache Paimon 毕业成为顶级项目,数据湖步入实时新篇章!
Apache Paimon 在构建实时数据湖与流批处理技术领域取得了重大突破,数据湖步入实时新篇章!
4829 6
官宣|Apache Paimon 毕业成为顶级项目,数据湖步入实时新篇章!
|
SQL 消息中间件 监控
实时计算 Flink版操作报错合集之TaskExecutor 如何解决ElasticsearchConnectorOptions类被废弃的问题
在使用实时计算Flink版过程中,可能会遇到各种错误,了解这些错误的原因及解决方法对于高效排错至关重要。针对具体问题,查看Flink的日志是关键,它们通常会提供更详细的错误信息和堆栈跟踪,有助于定位问题。此外,Flink社区文档和官方论坛也是寻求帮助的好去处。以下是一些常见的操作报错及其可能的原因与解决策略。