引言:一场关于流式存储的范式变革
欢迎阅读对 Apache Fluss(孵化中) 的深度解读——这是一项突破性的流式存储解决方案,旨在彻底重塑实时数据分析与人工智能(AI)基础设施的未来。
本文内容基于伍翀在 Flink Forward Asia 2025 新加坡大会上的主题演讲,旨在介绍 Fluss 作为下一代流式存储系统的核心理念与技术优势。我们将深入探讨 Fluss 如何弥合传统流处理系统与现代湖仓(Lakehouse)架构之间的鸿沟,显著提升机器学习特征工程、多模态 AI 数据摄入等前沿场景下的存储能力。
我们将一起了解:
为什么我们需要 Fluss?
它的架构优势是什么?
在真实生产环境中如何落地?
准备好,一起进入 Fluss 的世界。
传统数据架构的困境
在当今“数据驱动”的时代,Apache Kafka 已成为几乎所有流式数据架构的基石。它在微服务间的事件通信、高吞吐日志采集等方面表现出色。
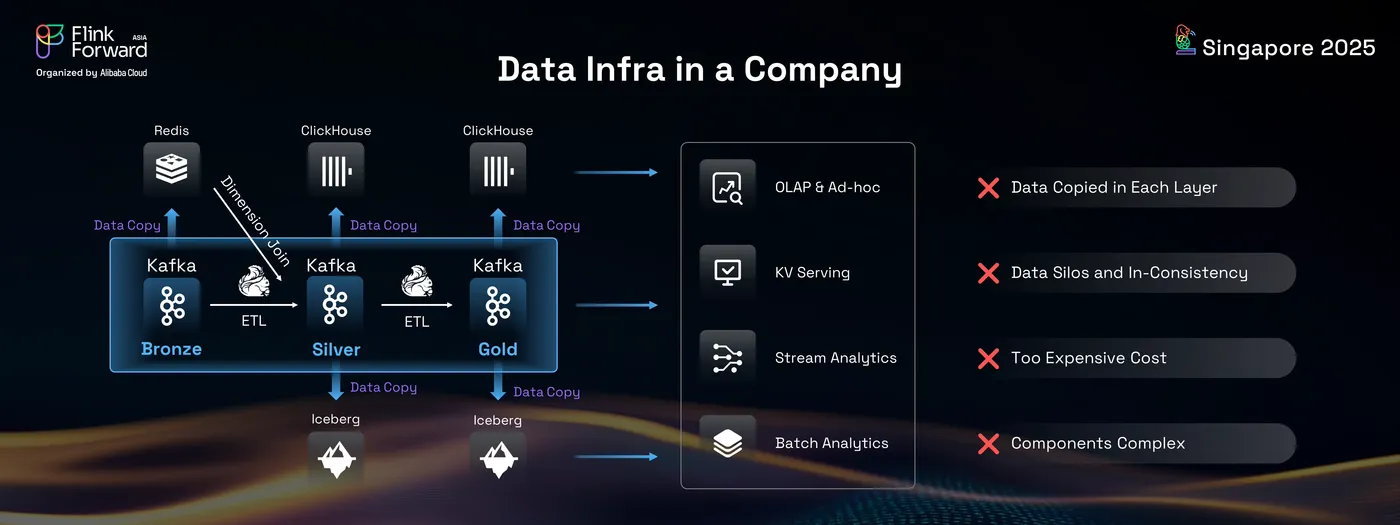
当我们需要从流数据中获取实时洞察时,通常会使用 Apache Flink 进行处理与转换。而为了实现分层建模,我们常将数据写回 Kafka 的多层主题(Topic)中:比如青铜层(bronze)、银层(silver)、金层(gold)——即所谓的“数据湖勋章架构(Medallion Architecture)”。
但问题来了:
当你要做一次 key-value 查询来丰富数据,该怎么办?
Kafka 本身不支持高效的 KV 查询。于是我们不得不把数据复制一份到 Redis 这类 KV 存储中,只为支持维度表关联。
当你想对 Kafka 主题进行数据探索或调试呢?
Kafka 并不是为“可查询”而设计的。你只能再次复制数据,导入 ClickHouse 等 OLAP 系统才能做交互式分析。
如果你想构建一个支持批处理的数据湖仓?
对不起,还得再复制一次——这次要转成 Iceberg、Paimon 等开放格式。
于是,同样的数据在 Kafka、Redis、ClickHouse、Iceberg 之间被反复复制,形成“数据影子系统”。
这带来了四大问题:
成本飙升:多份副本显著增加存储与网络开销;
架构复杂:运维多套系统,一致性难保障;
数据孤岛:各系统之间割裂,难以统一治理;
延迟累积:每次复制都引入额外延迟。
更关键的是,在这种架构下,Kafka 主题本身几乎没有任何业务价值。它既不能被查询,也不适合长期存储,更不支持更新——只是一个“黑盒中转站”。
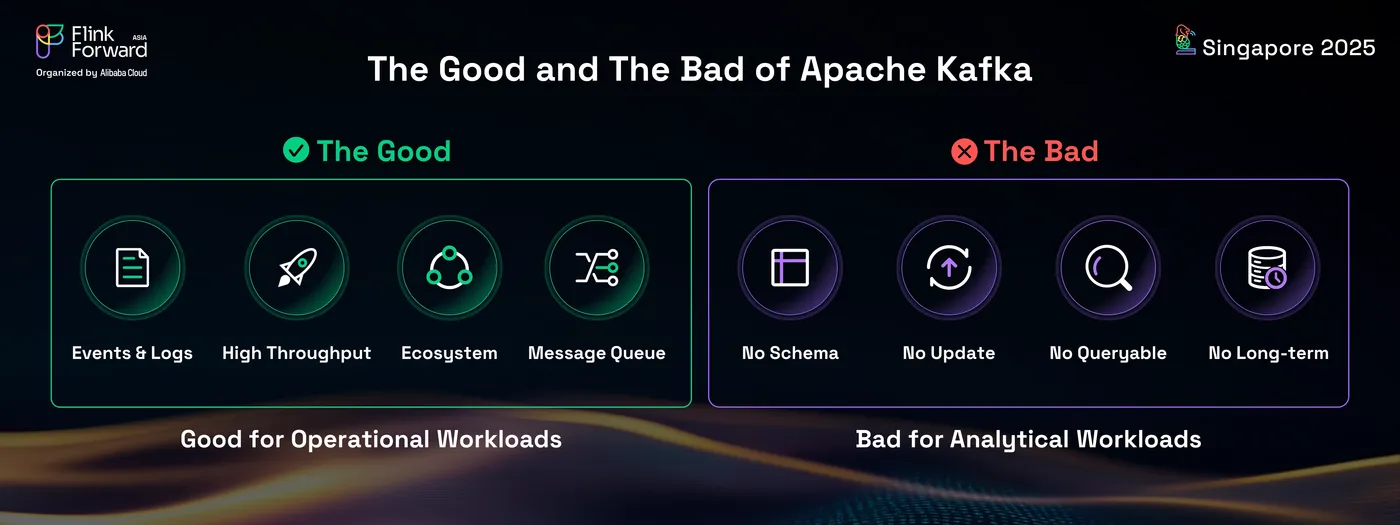
这并不是 Kafka 的错。Kafka 的设计初衷是高吞吐、低延迟的事件分发,而非分析或 AI 场景。它缺乏:
内置 Schema 管理
更新语义支持
面向长期存储的优化
因此,把它用在大数据场景本质是个误用。
正是基于这一深刻认知,Fluss 项目在两年前应运而生——一个从零构建、专为分析与 AI 场景优化的流式存储系统。它的目标很明确:终结数据重复复制,打造统一、高效、低成本的实时数据底座。
Fluss:流式存储的新范式
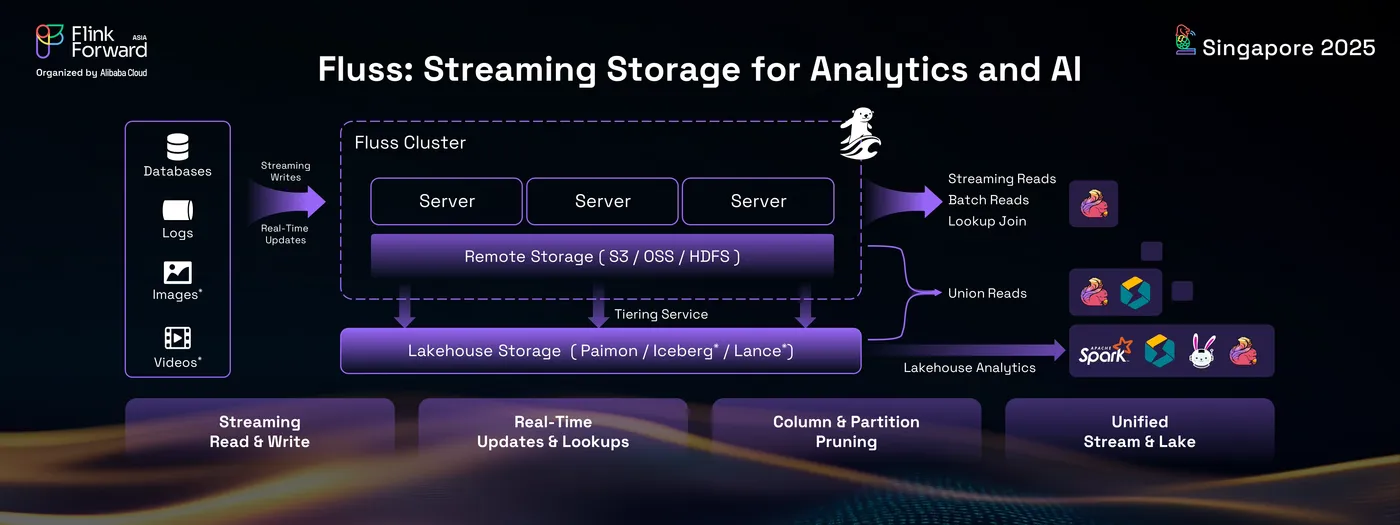
Fluss 代表了流式存储技术的一次重大跃迁。
它是一个支持亚秒级读写延迟的流式存储系统,底层基于 Apache Arrow 构建,采用列式日志结构(columnar log)。这一设计赋予了 Fluss 天然的分析优势。
核心优势一览
✅ 强大的分析能力
得益于 Arrow 的列式格式,Fluss 支持流式列裁剪与流式分区裁剪。查询时仅读取所需列与分区,大幅降低网络传输开销,提升分析效率。
✅ 高性能的实时更新与查询
Fluss 支持高并发、低延迟的 KV 查询与更新,可直接作为 Flink 的维度表进行 Lookup Join,无需再引入 Redis。
✅ 与湖仓无缝集成的分层存储
Fluss 支持将热数据保留在本地高速存储中,冷数据则自动归档至湖仓(如 Iceberg、Paimon),实现成本与性能的平衡。归档数据采用标准开放格式,可被 Spark、Trino、StarRocks 等引擎直接读取。
✅ 统一读取(Union Read):打通流与批
Fluss 引入了 Union Read 特性,智能合并热数据(Fluss)与冷数据(湖仓)。它先读取历史数据,再无缝衔接实时流,无重复、无遗漏。Flink 已原生支持 Union Read,StarRocks 集成也在推进中。
Fluss 构建真正的“实时流式湖仓”
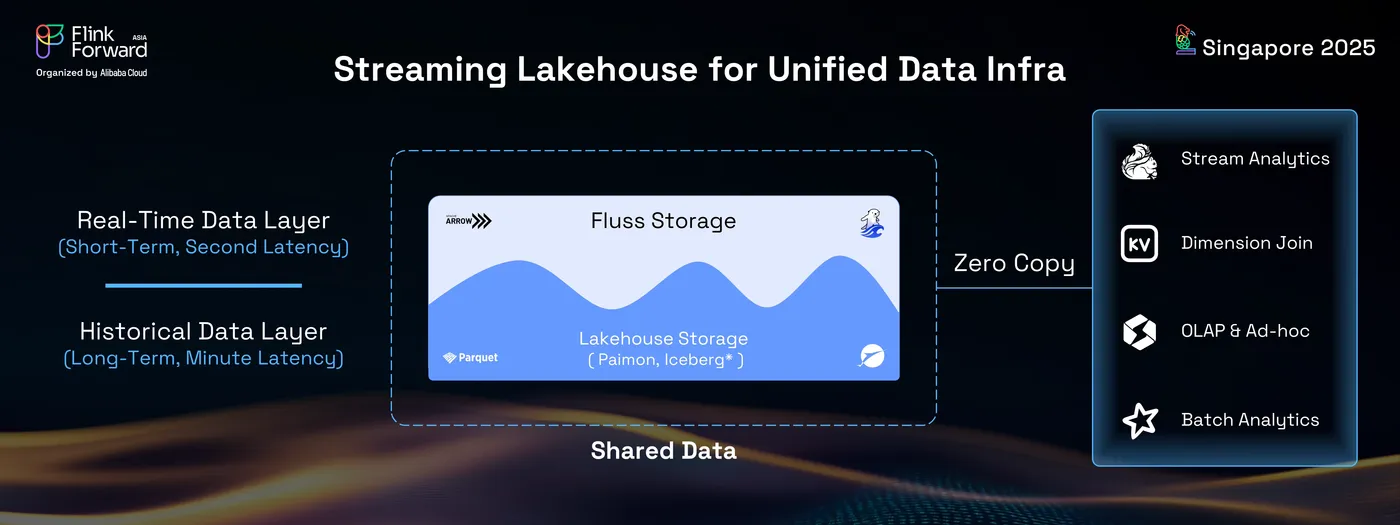
通过 Fluss,企业可以实现一个真正统一的实时湖仓架构——数据只存一份,却能同时满足:
Flink 流式分析:亚秒级读写
维度表 Join:KV 查询支持
OLAP 查询:Union Read 支持
批处理:开放湖格式兼容
需要强调的是,Fluss 并非要取代湖仓,而是为湖仓注入强大的流式能力。它让数据在“流”与“湖”之间自由流动,实现真正的数据融合。
如何实现数据共享?
Fluss 内置一个分层服务(tiering service),持续将 Fluss 中的数据转换为 Iceberg/Paimon 等格式,写入湖仓。这一机制类似于数据库的“冷热分层”策略,但 Fluss 将湖仓作为“冷层”,确保冷数据对整个生态开放可读。
Fluss = 实时数据层:存储短期、高时效性数据(亚秒级延迟)
湖仓 = 历史数据层:存储长期数据(分钟级延迟)
当流任务需要回溯历史数据时,湖仓提供快速“追赶”能力;当执行批分析时,Fluss 可将最近几分钟的最新数据补全至湖仓,确保批处理结果也是“实时的”。
Fluss 在生产环境的真实案例
Fluss 不是纸上谈兵。它已在阿里巴巴大规模落地,展现出强大的稳定性与性能。
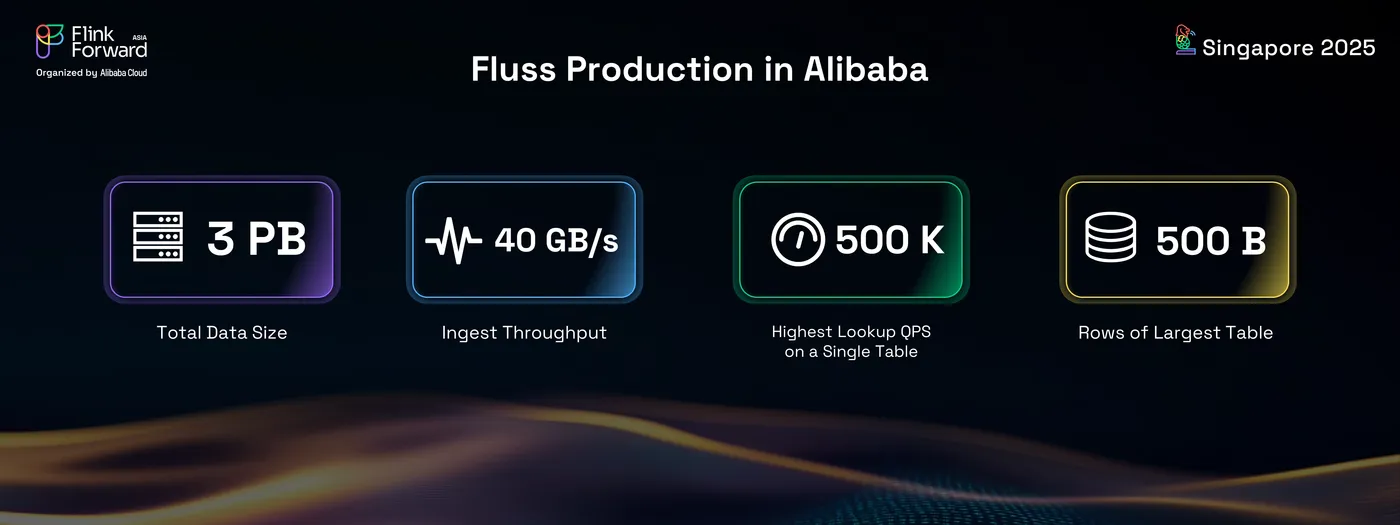
目前,Fluss 已管理 超 3 PB 数据,单集群写入吞吐高达 40 GB/s。支持单表 50 万 QPS 的 KV 查询,最大单表行数超 5000 亿。
让我们深入看看阿里巴巴生产环境中的几个典型应用场景。
案例一:淘宝日志采集与实时分析
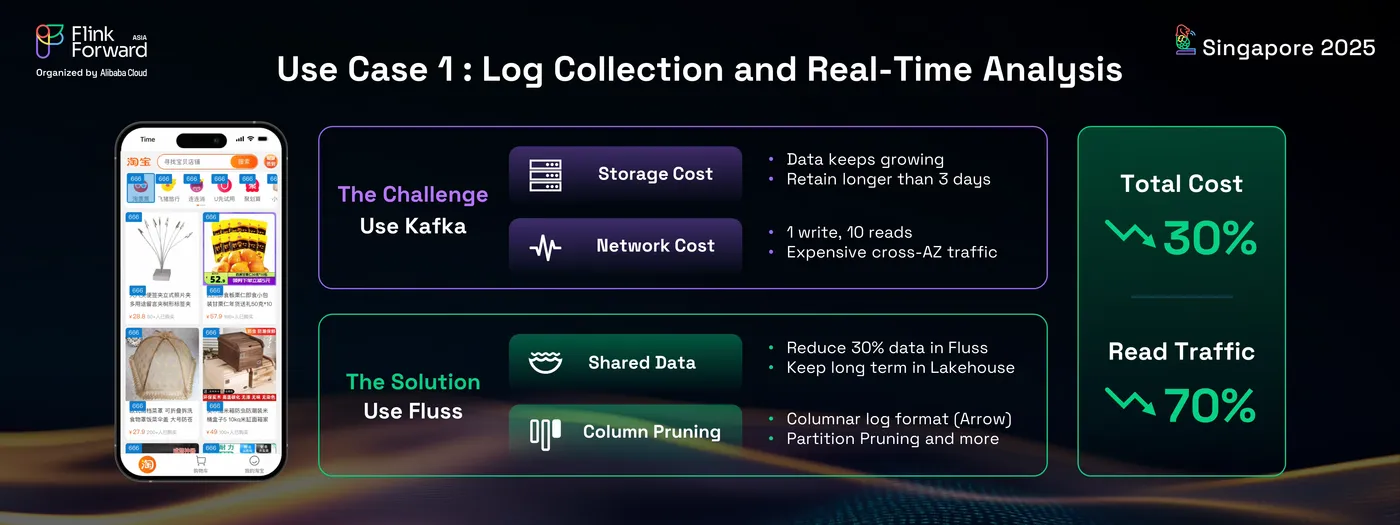
淘宝每天产生海量日志:点击流、用户行为、订单流等,是下游分析与 AI 模型的数据基础。
过去使用 Kafka 时,面临两大挑战:
存储成本高:日志量年年增长,但 Kafka 难以长期保留,用户想查一周前的数据?做不到。
读取成本高:日志常被“一写十读”,网络流量巨大。
切换至 Fluss 后,团队利用“流式湖仓”的共享能力:
长期数据归档至湖仓,Fluss 本地数据减少 30%
利用列裁剪与分区裁剪,读取流量降低 70%
整体成本下降 30%
真正实现了“低成本、高时效、可追溯”的日志分析。
案例二:Delta Join —— 超大规模流式 Join 的破局之道
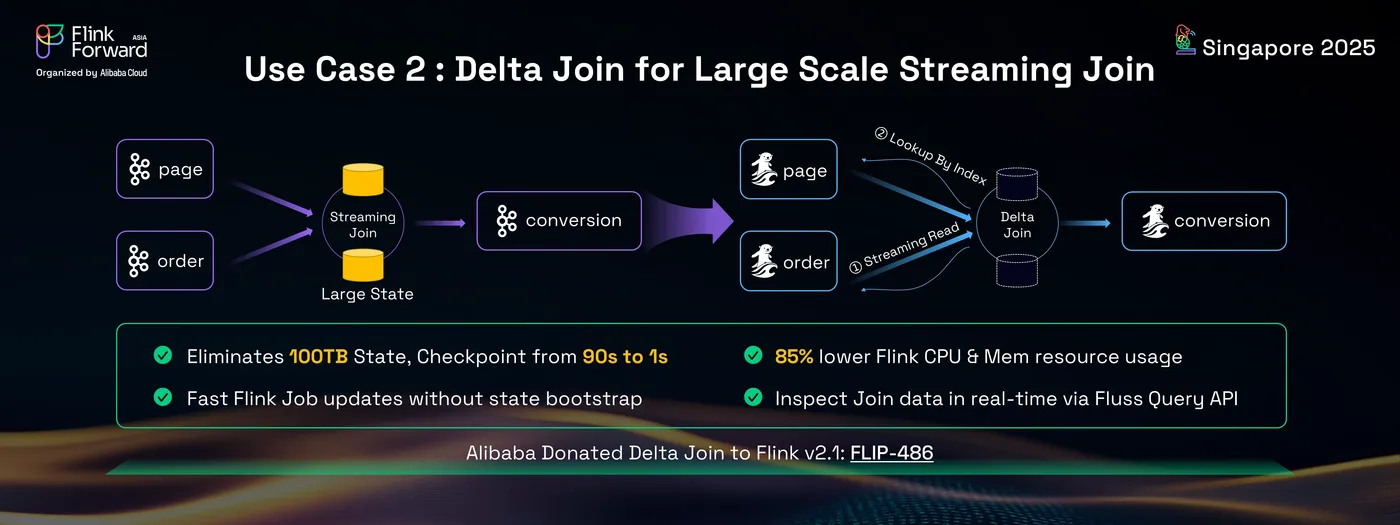
流式 Join 是 Flink 的核心能力,由于 Kafka 无法同时提供流读和索引点查的能力,所以在 Kafka+Flink 的架构下需将所有上游数据缓存在 Flink 状态中。例如,阿里搜索推荐团队需关联“页面点击流”与“订单流”做归因分析。两个流数据量巨大,在 Kafka+Flink 的架构下状态高达 100 TB,这导致作业不稳定、checkpoint超时、资源消耗巨大等问题。
通过引入 Delta Join(基于 Fluss),问题迎刃而解:
Delta Join 本质是一种双向 Lookup Join:
左流数据到来时,去 Fluss 中查右表;
右流数据到来时,去 Fluss 中查左表。
语义等价于传统 Join,但让 Flink 作业变得很轻量和灵活,同时在 Fluss 中的索引能被多个 Flink 作业复用。
实际效果:
减少100TB的状态大小
检查点时间从 90 秒降至 1 秒
Flink 资源消耗减少 85%
作业更新不再依赖状态重放,迭代速度大幅提升
更棒的是,Delta Join 已开源并捐赠至 Apache Flink,已在 Flink 2.1 版本中发布,标志着 Fluss 与 Flink 生态的深度整合。
Fluss 未来路线图:面向多模态 AI 与开放数据
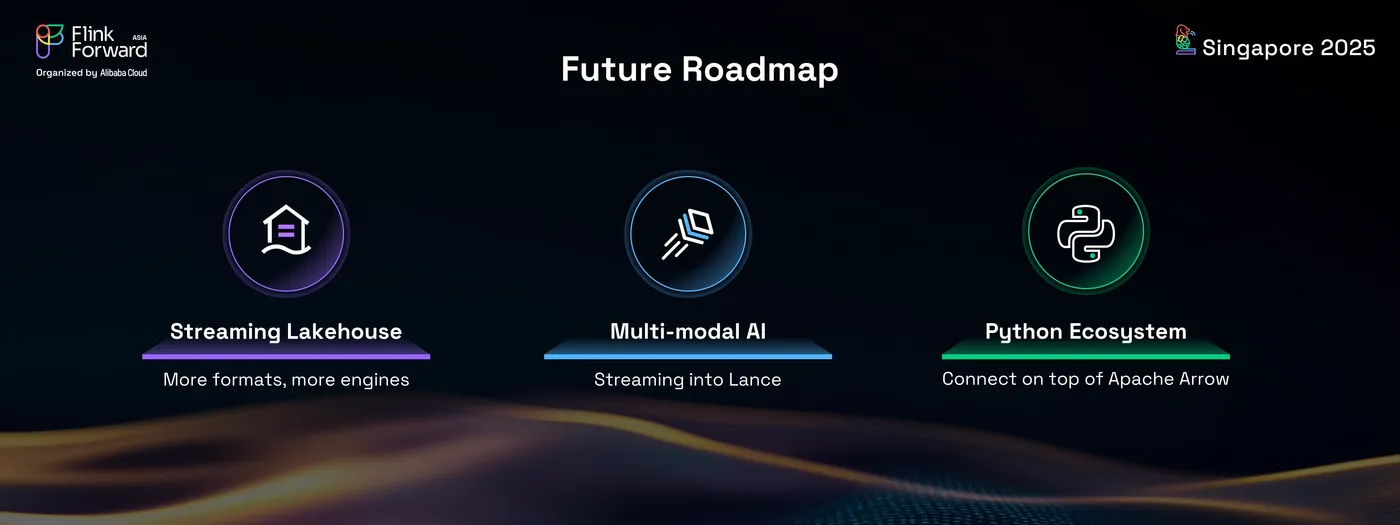
Fluss 的未来充满想象空间,聚焦三大方向:
增强流式湖仓能力 支持更多开放格式:Iceberg、Delta Lake 拓展查询引擎生态:Spark、Trino、StarRocks 全面兼容
多模态 AI 深度集成 支持文本、图像、音频、视频等多模态数据的实时摄入与存储 与 Lance(AI 开放格式)深度整合,构建“实时 AI 数据湖”
推出 Python 客户端(PyArrow 集成) 支持 Pandas、Polars、DuckDB 等 Python 数据工具 让数据科学家也能轻松接入 Fluss
在 AI 时代,数据基础设施面临三大核心挑战:

首先是多模态数据的崛起——与传统分析主要依赖结构化数据不同,AI 应用越来越多地处理文本、图像、音频、视频等非结构化数据,这对存储和处理系统提出了更高的灵活性要求。其次是流式数据的需求激增——AI 智能体(Agent)不再满足于基于历史数据的离线推理,而是需要实时感知、即时决策,要求数据管道具备低延迟、持续更新的能力。最后是开放数据的重要性日益凸显——为了实现跨系统、跨工具的协同,数据格式必须开放、标准、可互操作,就像分析领域依赖 Parquet、Iceberg 一样,AI 也需要属于自己的“通用语言”。Fluss 正是基于这样的洞察,致力于构建一个支持多模态、原生流式、拥抱开放生态的下一代数据底座。
未来的 Fluss 将不仅是分析引擎的底座,更是多模态 AI 实时流水线的核心:
- 实时摄入多模态数据 → 存储为流式格式 → 转换为 Lance → 接入 Ray、PyTorch 等 AI 框架
结合即将推出的 Python 客户端,Fluss 将解锁:
实时多模态智能体(Agent)
实时 AI 数据湖
实时特征工程平台
Fluss 的开源之路
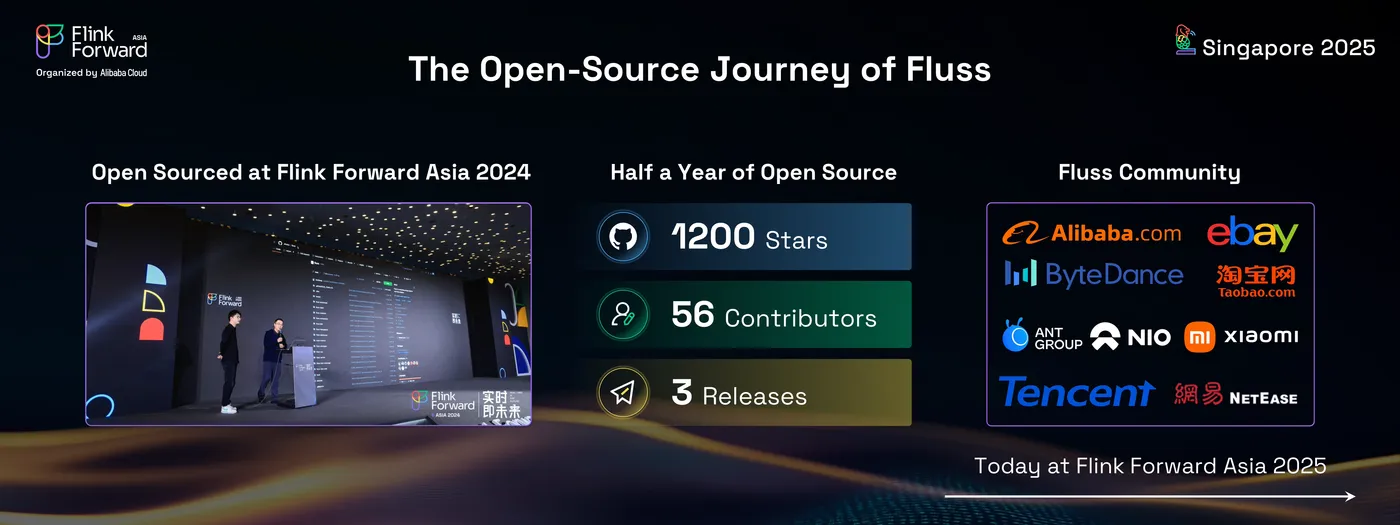
Fluss 的开源之旅始于 2024 年 Flink Forward Asia 上海大会,现场宣布开源。半年内:
GitHub Stars 超 1,200
贡献者超 50 人,来自阿里巴巴、字节跳动、eBay、小米、腾讯等全球领先企业
已发布 3 个版本,迭代迅速
2025 年 6 月,阿里巴巴正式将 Fluss 捐赠至 Apache 软件基金会(ASF),项目更名为 Apache Fluss(Incubating)。新仓库地址:https://github.com/apache/fluss/
加入 Apache 是 Fluss 社区的重要里程碑,标志着它迈向更开放、更中立、更可持续的未来。
邀测开启:适用于 Apache Fluss 的阿里云托管服务上线
现在,适用于 Apache Fluss 的阿里云托管服务已启动邀测,现已在北京、杭州、新加坡等区域开服。
开发者可扫描二维码申请试用,率先体验下一代流式存储的强大能力:
结语:Fluss 的使命
Fluss 正在重新定义实时数据基础设施的边界。
它不是 Kafka 的替代品,也不是湖仓的竞争对手,而是一个融合者:将流、批、分析、AI 统一在同一个高效、开放、实时的数据底座之上。
随着其在 Apache 社区的持续演进,Fluss 有望成为未来数据架构的“实时神经中枢”,助力企业真正释放数据与 AI 的全部潜能。
实时数据,不再分裂。
统一存储,就在 Fluss。
更多内容
活动推荐
阿里云基于 Apache Flink 构建的企业级产品-实时计算 Flink 版现开启活动:
新用户复制点击下方链接或者扫描二维码即可0元免费试用 Flink + Paimon
实时计算 Flink 版(3000CU*小时,3 个月内)
了解活动详情:https://free.aliyun.com/?utm_content=g_1000395379&productCode=sc