CLIPer:开创性框架提升CLIP空间表征,实现开放词汇语义分割突破

简介: 对比语言-图像预训练(CLIP)在多种图像级任务上表现出强大的零样本分类能力,促使研究行人尝试将CLIP应用于像素级开放词汇语义分割,而无需额外训练。关键在于提升图像级CLIP的空间表征能力,例如,用自-自注意力图或基于视觉基础模型的自注意力图替换最后一层的自注意力图。本文提出了一种新颖的分层框架CLIPer,该框架分层提升了CLIP的空间表征能力。

论文链接:

https://arxiv.org/abs/2411.13836

模型链接:

https://modelscope.cn/studios/sunlin449/CLIPer

01.论文解读

对比语言-图像预训练(CLIP)在多种图像级任务上表现出强大的零样本分类能力,促使研究行人尝试将CLIP应用于像素级开放词汇语义分割,而无需额外训练。关键在于提升图像级CLIP的空间表征能力,例如,用自-自注意力图或基于视觉基础模型的自注意力图替换最后一层的自注意力图。本文提出了一种新颖的分层框架CLIPer,该框架分层提升了CLIP的空间表征能力。

CLIPer包括浅层融合模块和精细补偿模块。浅层融合模块包括嵌入浅层特征和注意力图以保留空间结构信息,生成具有更好空间一致性的分割图。精细补偿模块利用扩散模型的自注意力图来补偿局部细节。本文在七个分割数据集上进行了实验,并在这些数据集上实现了最先进的性能。在不采用使用滑动窗口的策略下,使用ViT-L模型,CLIPer在VOC和COCO Object任务上的mIoU分别达到69.8%和43.3%,分别高出ProxyCLIP模型9.2%和4.1%。
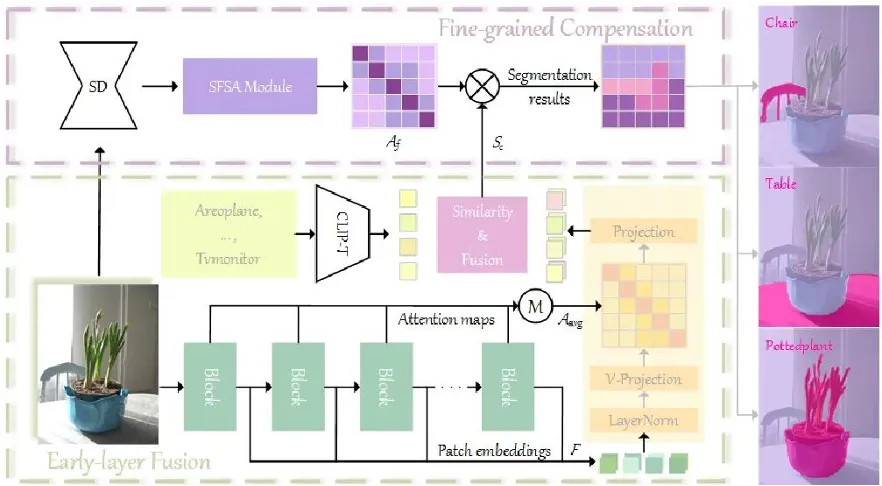
image.png

方法描述

CLIPer方法有以下几个关键步骤:

1.最后一层注意力机制的弥补:原始的CLIP图像编码器最后一层缺乏空间特性,CLIPer通过利用浅层空间连续性强的特性,将浅层的多头注意力图直接融合至最后一层中,并去掉了残差连接以及前向传播网络,以提高最终分割的连续性。

2.浅层特征的提取:在每次经过CLIP图像编码时,CLIPer会记录所有Transformer块的特征,并将这些特征送入到修改后的最后一层,并分别与文本特征计算相似度,得到分割结果。

3.精细补偿机制:CLIPer提出将扩散模型中的细节融入到分割中。该模块利用扩散模型中的多头自注意力头蕴含的细节信息,通过矩阵链乘法的形式去优化粗糙的分割结果。

论文实验

本文对CLIPer与一些最先进的方法在各种数据集上的表现进行了比较。当使用ViT-B和ViT-L两种框架时,CLIPer几乎在所有这些数据集上都达到了最佳性能。
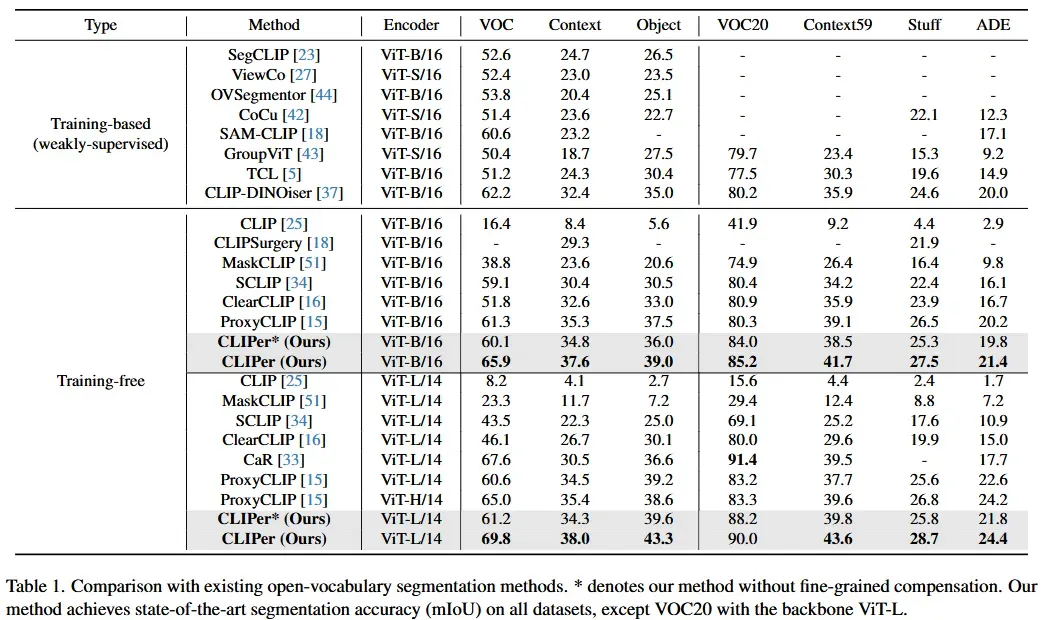
image.png

另外,本文还将开放词汇语义分割可以看作是两个方面:类别分类和掩码预测。为了深入展示CLIPer在这两个方面上的优势,本文通过两个实验与其他方法进行了更多比较。
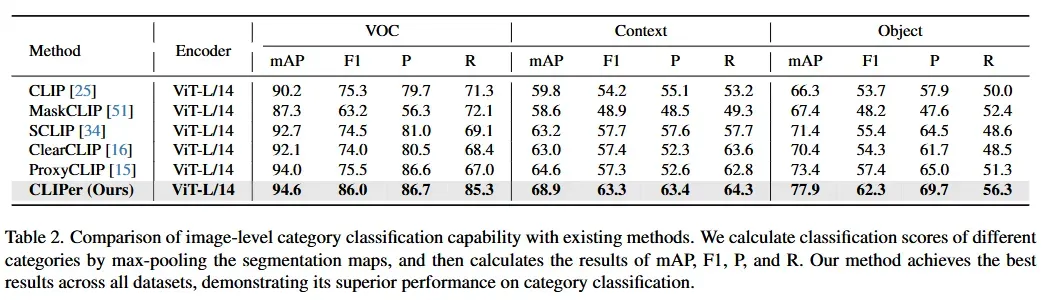
image.png

本文第一个实验结果的图像级分类的形式展示了CLIPer的分类能力,通过表二可以得出CLIPer取得更优的mAP、F1、P和R分数,表明在类别分类上表现更好,这对于开放词汇语义分割非常有用。

本文的第二个实验通过弱监督的设置展示了CLIPer的分割能力,通过表三可以得出,CLIPer在弱监督设置中较其他方式取得更优的mIoU分数,说明具备更好的分割能力。

对于推理时间,与ClearCLIP相比,CLIPer*具有更快的速度和更高的mIoU。与ProxyCLIP相比,CLIPer*具有更快的速度和可比的mIoU。此外,CLIPer通过细粒度补偿显著提升了CLIPer*的性能。

本文也有一系列的消融实验。具体包括:

1. 单独只使用浅层特征融合模块(CLIPer*),单独只使用精细补偿模块,以及两者同时具备(CLIPer)的情况,发现每一个模块均能单独提升分割结果,并且同时使用两者能更进一步的提升效果。

2. 进一步的消融浅层特征融合模块,展示了只融合浅层特征,只融合自注意力,以及同时融合两者同同条件下使用q-q,k-k,v-v的对比,得出这两种融合的有效性。

3. 在精细补偿中,本文也探讨了如何融合扩散模型自注意力图,包括选取其中一个自注意力图,平均所有自注意力图以及将所有自注意力图做矩阵链乘法,得出矩阵链乘法能显著的提升分割精度的结果。

02.最佳实践

CLIPer在魔搭社区上进行了部署,在魔搭社区免费提供的GPU免费算力上可体验CLIPer。

体验地址:

https://modelscope.cn/studios/sunlin449/CLIPer

运行结果:
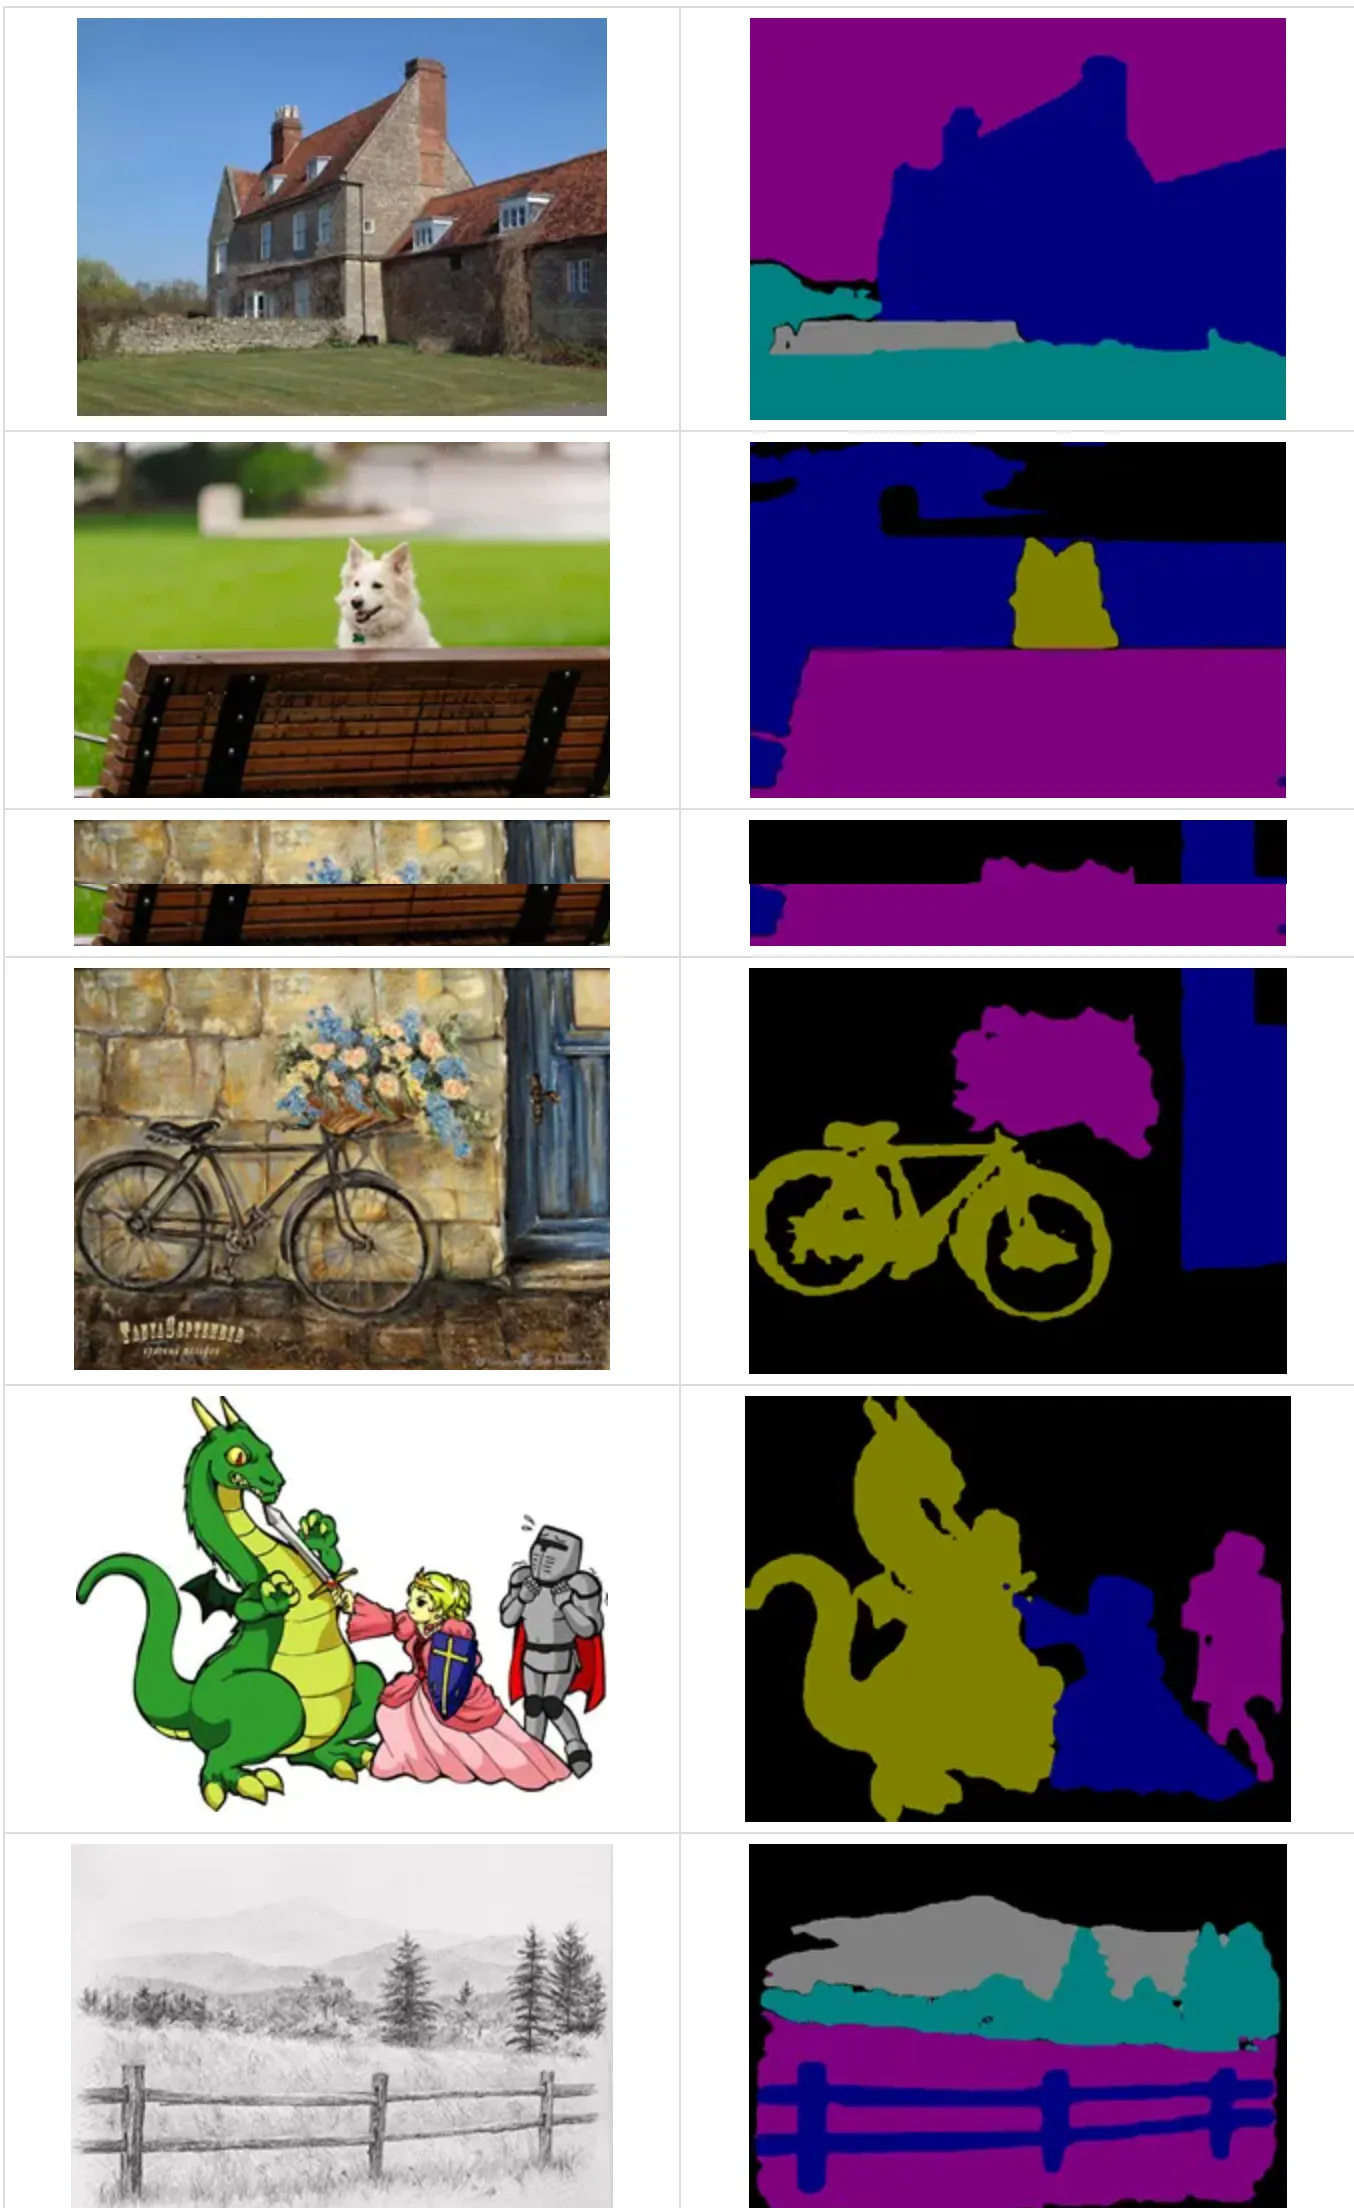
image.png

点击链接即可跳转模型~

https://modelscope.cn/studios/sunlin449/CLIPer

目录
相关文章
|
机器学习/深度学习 算法
【基础回顾】在回归任务中常见的损失函数比较(mse、mae、huber)
2528 0
【基础回顾】在回归任务中常见的损失函数比较(mse、mae、huber)
|
机器学习/深度学习 人工智能 并行计算
"震撼!CLIP模型:OpenAI的跨模态奇迹,让图像与文字共舞,解锁AI理解新纪元!"
【10月更文挑战第14天】CLIP是由OpenAI在2021年推出的一种图像和文本联合表示学习模型,通过对比学习方法预训练,能有效理解图像与文本的关系。该模型由图像编码器和文本编码器组成,分别处理图像和文本数据,通过共享向量空间实现信息融合。CLIP利用大规模图像-文本对数据集进行训练,能够实现zero-shot图像分类、文本-图像检索等多种任务,展现出强大的跨模态理解能力。
2082 2
|
存储 运维 数据安全/隐私保护
企业级备份软件Veritas NetBackup(NBU) 8.1.1服务端的安装部署
3629 0
企业级备份软件Veritas NetBackup(NBU) 8.1.1服务端的安装部署
|
计算机视觉 Python
OpenCV中拆分通道、合并通道、alpha通道的讲解及实战演示(附python源码 超详细)
1700 0
|
机器学习/深度学习 自然语言处理 PyTorch
LLM-Mixer: 融合多尺度时间序列分解与预训练模型,可以精准捕捉短期波动与长期趋势
近年来,大型语言模型(LLMs)在自然语言处理领域取得显著进展,研究人员开始探索将其应用于时间序列预测。Jin等人提出了LLM-Mixer框架,通过多尺度时间序列分解和预训练的LLMs,有效捕捉时间序列数据中的短期波动和长期趋势,提高了预测精度。实验结果显示,LLM-Mixer在多个基准数据集上优于现有方法,展示了其在时间序列预测任务中的巨大潜力。
692 3
LLM-Mixer: 融合多尺度时间序列分解与预训练模型,可以精准捕捉短期波动与长期趋势
|
数据采集 存储 JSON
使用Python获取1688商品详情的教程
本教程介绍如何使用Python爬取1688商品详情信息,涵盖环境配置、代码编写、数据处理及合法合规注意事项,助你快速掌握商品数据抓取与保存技巧。
|
Web App开发 前端开发 安全
2024年新一代WebOffice内嵌网页组件,Web网页在线编辑Word/Excel/PPT
WebOffice控件面临兼容性、用户体验和维护难题。随着浏览器更新,依赖插件的技术不再适用,如Chrome不再支持NPAPI和PPAPI。产品普遍不支持多版本Office并存,定制能力弱,升级复杂。猿大师办公助手提供了解决方案,它兼容多种浏览器,包括最新版和国产浏览器,不依赖插件,支持文档对比,具有丰富的功能和接口,兼容多种Office版本,允许源码级定制,提供终身技术支持,并实现静默在线升级。适用于多种行业和操作系统。
1726 129
|
Prometheus 监控 Cloud Native
基于Docker安装Grafana和Prometheus
Grafana 是一款用 Go 语言开发的开源数据可视化工具,支持数据监控和统计,并具备告警功能。通过 Docker 部署 Grafana 和 Prometheus,可实现系统数据的采集、展示和告警。默认登录用户名和密码均为 admin。配置 Prometheus 数据源后,可导入主机监控模板(ID 8919)进行数据展示。
1515 4
|
算法 数据可视化 PyTorch
IoU已经out了,试试这几个变体:GIoU、DIoU和CIoU介绍与对比分析
本文探讨了目标检测中常用的交并比(IoU)及其变体,包括广义交并比(GIoU)、距离交并比(DIoU)和完全交并比(CIoU)。这些指标不仅提高了模型在处理不重叠、距离较远或形状差异大的边界框时的表现,还为模型的学习过程提供了更深入的洞察。文章详细解释了各指标的计算方法及应用场景,并提供了相应的代码示例,帮助读者更好地理解和应用这些先进的评估指标。
1647 7
IoU已经out了,试试这几个变体:GIoU、DIoU和CIoU介绍与对比分析
|
程序员
VSCode变量命名转换插件(Var-Conv)
2740 0
VSCode变量命名转换插件(Var-Conv)

热门文章

最新文章