
❤️ 如果你也关注 AI 的发展现状,且对 AI 应用开发感兴趣,我会每日分享大模型与 AI 领域的开源项目和应用,提供运行实例和实用教程,帮助你快速上手AI技术!
🥦 AI 在线答疑 -> 智能检索历史文章和开源项目 -> 尽在微信公众号 -> 搜一搜:蚝油菜花 🥦
🎯 “告别机械检索!HippoRAG 2 用知识图谱+PageRank算法,让AI问答更接近人类记忆”
大家好,我是蚝油菜花。你是否也遇到过——
- 👉 复杂的问答任务中,AI总是给出不相关的答案
- 👉 多跳推理问题难以解决,知识片段分散无法整合
- 👉 传统RAG系统无法动态调整检索结果,导致信息过载...
今天揭秘的 HippoRAG 2,用知识图谱和个性化PageRank算法,彻底颠覆了传统RAG系统的局限性!这个由俄亥俄州立大学推出的框架,不仅能高效整合知识,还能进行多跳推理,处理复杂的问答任务。无论是智能问答、知识管理,还是教育辅助,HippoRAG 2 都能提供精准的解决方案。接下来,我们将深入解析它的核心功能和技术原理,带你一探究竟!
🚀 快速阅读
HippoRAG 2 是俄亥俄州立大学推出的检索增强生成框架,旨在解决现有RAG系统在模拟人类长期记忆动态性和关联性方面的局限性。
- 核心功能:高效的知识检索与整合、多跳关联推理、上下文感知检索、持续学习能力。
- 技术原理:基于个性化PageRank算法和知识图谱技术,结合深度段落整合和LLM过滤,实现精准的上下文感知检索。
HippoRAG 2 是什么
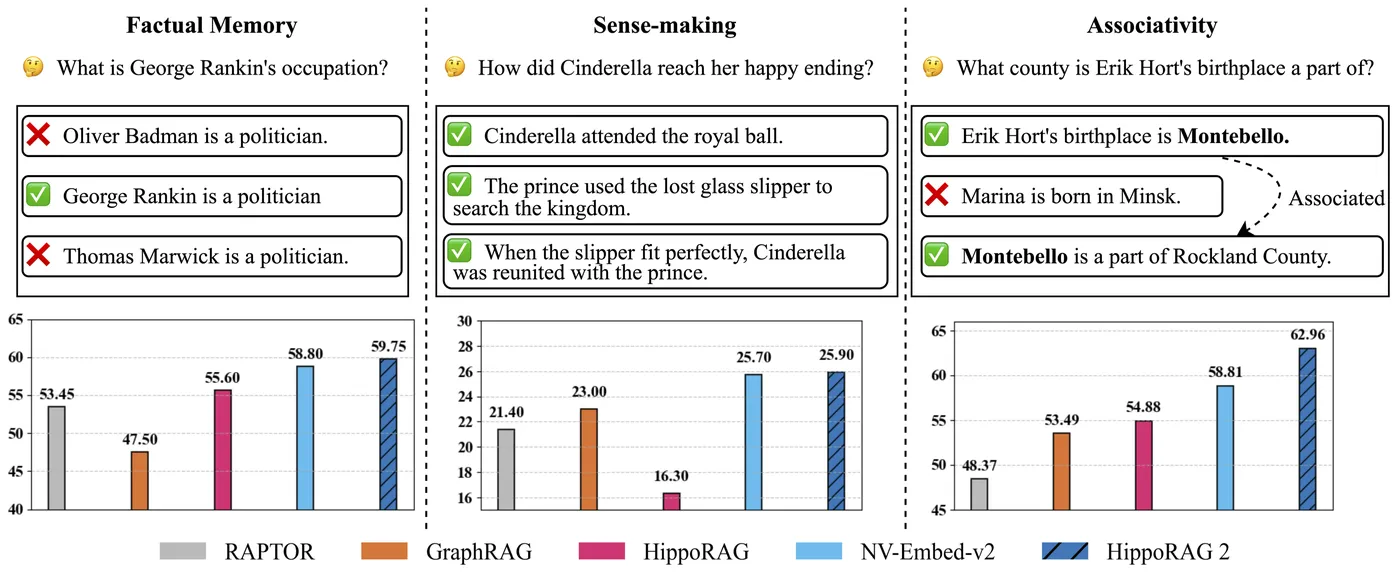
HippoRAG 2 是俄亥俄州立大学推出的检索增强生成(RAG)框架,旨在解决现有RAG系统在模拟人类长期记忆动态性和关联性方面的局限性。通过结合个性化PageRank算法和知识图谱技术,HippoRAG 2 能够更有效地整合知识,处理复杂的问答任务。
HippoRAG 2 在离线阶段使用大型语言模型(LLM)从段落中提取三元组,并构建开放知识图谱(KG)。同时,基于嵌入模型检测同义词并添加到KG中。在线检索时,系统结合查询与KG中的三元组和段落进行链接,基于LLM过滤无关信息,应用个性化PageRank算法进行上下文感知检索,最终为问答任务提供最相关的段落。
HippoRAG 2 的主要功能
- 高效的知识检索与整合:基于深度段落整合和知识图谱(KG)的构建,快速检索与查询相关的知识,整合到生成过程中。
- 多跳关联推理:借助个性化PageRank算法,系统进行多跳推理,连接分散的知识片段,处理复杂的问答任务。
- 上下文感知检索:基于查询与知识图谱的深度交互,根据上下文动态调整检索结果,提高检索的准确性和相关性。
- 持续学习能力:作为一种非参数化的持续学习框架,HippoRAG 2 能在不修改模型参数的情况下,实时吸收和利用新知识,增强系统的适应性。
HippoRAG 2 的技术原理
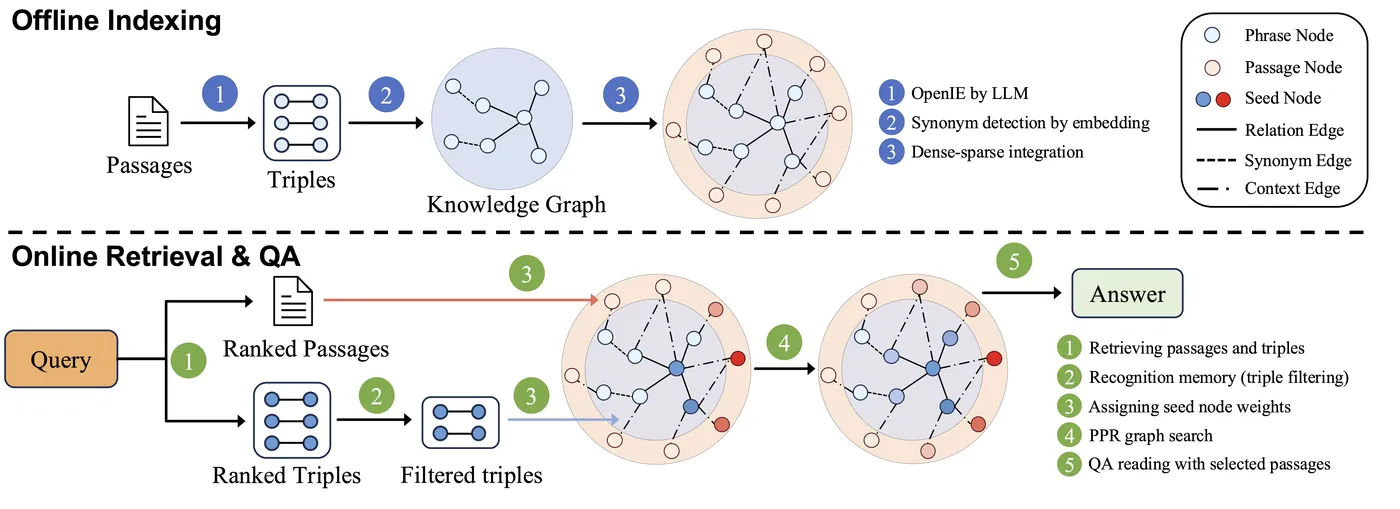
- 离线索引(Offline Indexing):用LLM从文本段落中提取结构化的三元组(主体、关系、宾语),将三元组整合到开放知识图谱(KG)中。基于嵌入模型检测同义词,在KG中添加同义词边,增强知识图谱的连接性。将原始段落与知识图谱结合,形成包含概念和上下文信息的复合知识图谱。
- 在线检索(Online Retrieval):
- 查询链接:用嵌入模型将查询与KG中的三元组和段落进行匹配,确定图搜索的种子节点。
- 三元组过滤:基于LLM对检索到的三元组进行过滤,去除无关信息,保留与查询高度相关的知识。
- 个性化PageRank算法:基于KG的结构,应用个性化PageRank算法进行上下文感知检索,动态调整检索结果的相关性。
- 段落排名与问答:根据PageRank得分对段落进行排名,将排名靠前的段落作为上下文输入到最终的问答模型中。
如何运行 HippoRAG 2
1. 安装
conda create -n hipporag python=3.10
conda activate hipporag
pip install hipporag
2. 初始化环境变量
export CUDA_VISIBLE_DEVICES=0,1,2,3
export HF_HOME=<path to Huggingface home directory>
export OPENAI_API_KEY=<your openai api key>   # if you want to use OpenAI model

conda activate hipporag
3. 快速开始
使用 OpenAI 模型
from hipporag import HippoRAG

# 准备数据集
docs = [
    "Oliver Badman is a politician.",
    "George Rankin is a politician.",
    "Thomas Marwick is a politician.",
    "Cinderella attended the royal ball.",
    "The prince used the lost glass slipper to search the kingdom.",
    "When the slipper fit perfectly, Cinderella was reunited with the prince.",
    "Erik Hort's birthplace is Montebello.",
    "Marina is bom in Minsk.",
    "Montebello is a part of Rockland County."
]

save_dir = 'outputs'
llm_model_name = 'gpt-4o-mini'
embedding_model_name = 'nvidia/NV-Embed-v2'

# 启动 HippoRAG 实例
hipporag = HippoRAG(save_dir=save_dir,
                    llm_model_name=llm_model_name,
                    embedding_model_name=embedding_model_name)

# 运行索引
hipporag.index(docs=docs)

# 检索与问答
queries = [
    "What is George Rankin's occupation?",
    "How did Cinderella reach her happy ending?",
    "What county is Erik Hort's birthplace a part of?"
]

retrieval_results = hipporag.retrieve(queries=queries, num_to_retrieve=2)
qa_results = hipporag.rag_qa(retrieval_results)
使用本地部署的 vLLM 模型
- 启动 vLLM 服务器:
```sh
export CUDA_VISIBLE_DEVICES=0,1
export VLLM_WORKER_MULTIPROC_METHOD=spawn
export HF_HOME=
conda activate hipporag
vllm serve meta-llama/Llama-3.3-70B-Instruct --tensor-parallel-size 2 --max_model_len 4096 --gpu-memory-utilization 0.95
2. 使用 HippoRAG:
```python
save_dir = 'outputs'
llm_model_name = 'meta-llama/Llama-3.3-70B-Instruct'
embedding_model_name = 'nvidia/NV-Embed-v2'
llm_base_url = 'http://localhost:8000/v1'

hipporag = HippoRAG(save_dir=save_dir,
                    llm_model_name=llm_model,
                    embedding_model_name=embedding_model_name,
                    llm_base_url=llm_base_url)

# 同样的索引、检索与问答操作
资源
❤️ 如果你也关注 AI 的发展现状,且对 AI 应用开发感兴趣,我会每日分享大模型与 AI 领域的开源项目和应用,提供运行实例和实用教程,帮助你快速上手AI技术!
🥦 AI 在线答疑 -> 智能检索历史文章和开源项目 -> 尽在微信公众号 -> 搜一搜:蚝油菜花 🥦

