云原生数据仓库AnalyticDB PostgreSQL同一个SQL可以实现向量索引、全文索引GIN、普通索引BTREE混合查询,简化业务实现逻辑、提升查询性能

简介: 本文档介绍了如何在AnalyticDB for PostgreSQL中创建表、向量索引及混合检索的实现步骤。主要内容包括:创建`articles`表并设置向量存储格式,创建ANN向量索引,为表增加`username`和`time`列,建立BTREE索引和GIN全文检索索引,并展示了查询结果。参考文档提供了详细的SQL语句和配置说明。

参考文档:https://help.aliyun.com/zh/analyticdb/analyticdb-for-postgresql/user-guide/fusion-search-use-guide?spm=a2c4g.11186623.help-menu-92664.d_2_8_3.4bf95fa2s3zEtw&scm=20140722.H_2528590._.OR_help-T_cn~zh-V_1


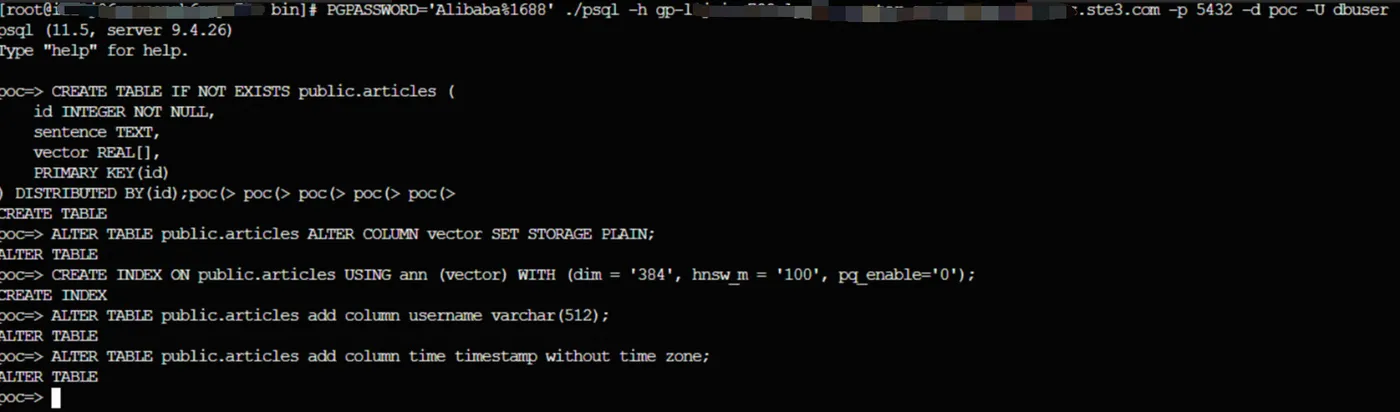
# 建表SQL,并修改向量列的存储格式为PLAN
CREATE TABLE IF NOT EXISTS public.articles (
    id INTEGER NOT NULL,
    sentence TEXT,
    vector REAL[],
    PRIMARY KEY(id)
) DISTRIBUTED BY(id);

ALTER TABLE public.articles ALTER COLUMN vector SET STORAGE PLAIN;

\d+ articles


# 创建向量索引
CREATE INDEX ON public.articles USING ann (vector) WITH (dim = '384', hnsw_m = '100', pq_enable='0');

# 为了实现混合检索,为原表增加2列
ALTER TABLE public.articles add column username varchar(512);
ALTER TABLE public.articles add column time timestamp without time zone;


改文件字符集
iconv -f GBK -t UTF-8 /usr/local/postgresql-11.5/sentences_vectors1.csv -o sentences_vectors.csv


# 将sentences_vectors.csv中处理好的数据导入到表中
PGPASSWORD='Alibaba%1688' ./psql -U dbuser -p 5432 -h gp-xxx.com -d poc -c "COPY public.articles (id, sentence, vector,username,time) FROM STDIN WITH (FORMAT CSV, HEADER true, DELIMITER ',');" < /usr/local/postgresql-11.5/sentences_vectors.csv

# 对混合查询关联的结构化与板结构化列建立索引
-- 对结构化字段建立BTREE索引
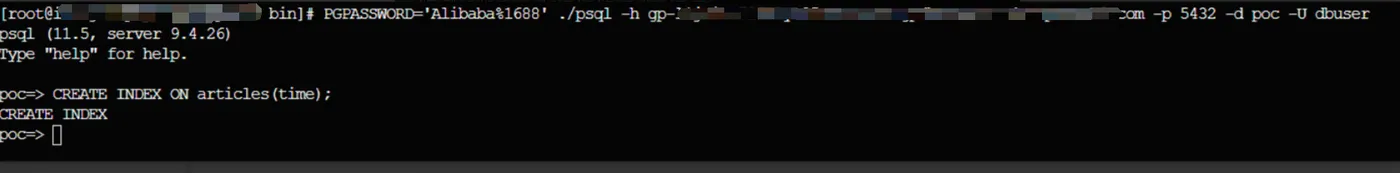
CREATE INDEX ON articles(time);

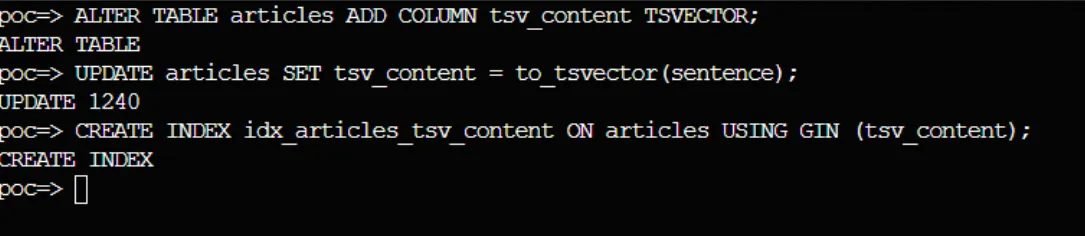
- 添加tsvector 列,为了支持全文检索,通常需要添加一个 tsvector 列,用于存储文本的向量化表示
ALTER TABLE articles ADD COLUMN tsv_content TSVECTOR;

- 更新 tsvector 列,使用 to_tsvector 函数将文本字段转换为 tsvector 格式,并更新到新列中
UPDATE articles SET tsv_content = to_tsvector(sentence);

- 在 tsvector 列上创建 GIN 索引以加速全文检索
CREATE INDEX idx_articles_tsv_content ON articles USING GIN (tsv_content);

- 查询全文索引
SELECT * FROM articles WHERE tsv_content @@ to_tsquery('make');

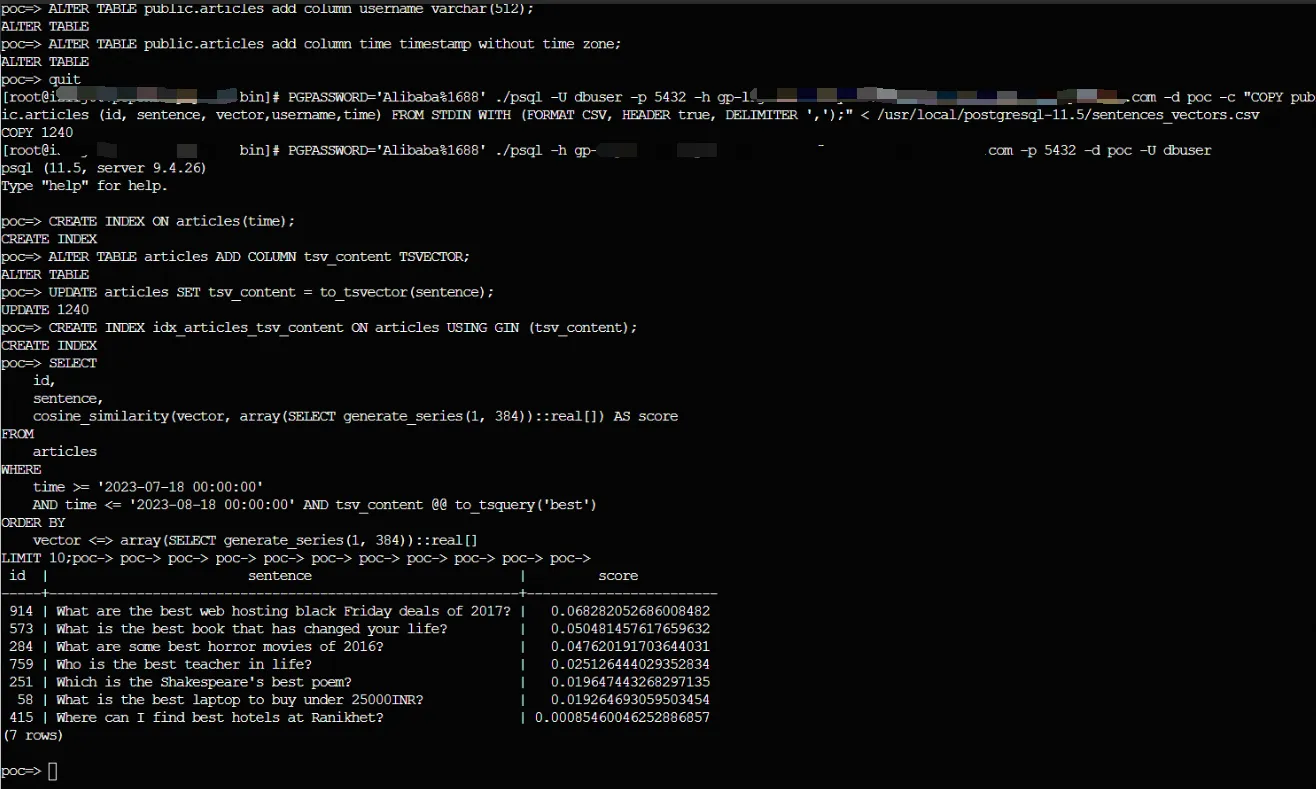
# 查询语句
SELECT 
    id,
    sentence, 
    cosine_similarity(vector, array(SELECT generate_series(1, 384))::real[]) AS score
FROM 
    articles
WHERE 
    time >= '2023-07-18 00:00:00' 
    AND time <= '2023-08-18 00:00:00' AND tsv_content @@ to_tsquery('best')
ORDER BY 
    vector <=> array(SELECT generate_series(1, 384))::real[]
LIMIT 10;

#创建表+向量索引
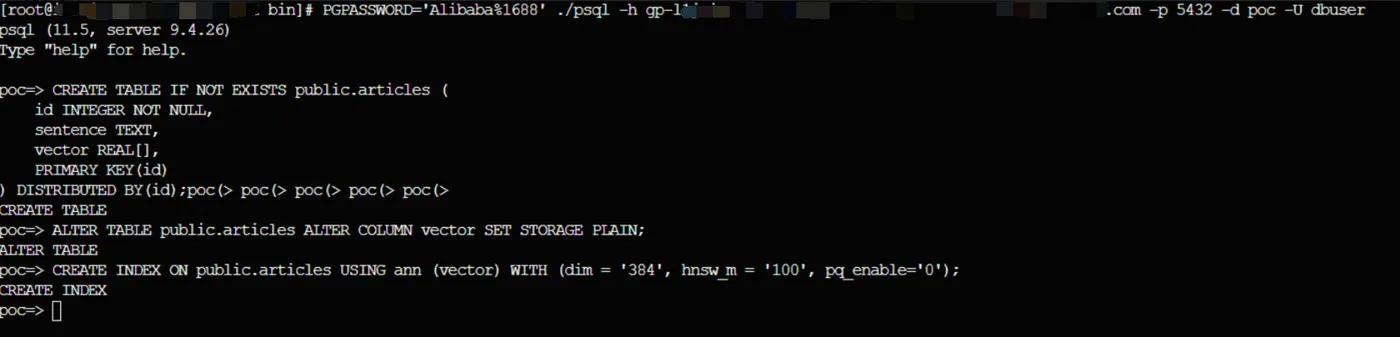
image.png

# 为了实现混合检索,为原表增加2列

image.png

#对结构化字段建立BTREE索引

image.png

#在 tsvector 列上创建 GIN 索引以加速全文检索

image.png

查询结果

image.png

相关实践学习
AnalyticDB PostgreSQL 企业智能数据中台:一站式管理数据服务资产
企业在数据仓库之上可构建丰富的数据服务用以支持数据应用及业务场景;ADB PG推出全新企业智能数据平台,用以帮助用户一站式的管理企业数据服务资产,包括创建, 管理,探索, 监控等; 助力企业在现有平台之上快速构建起数据服务资产体系
目录
相关文章
|
SQL 缓存 分布式计算
vivo 湖仓架构的性能提升之旅
聚焦 vivo 大数据多维分析面临的挑战、StarRocks 落地方案及应用收益。 在 **即席分析** 场景,StarRocks 使用占比达 70%,查询速度提升 3 倍,P50 耗时从 63.77 秒缩短至 22.30 秒,查询成功率接近 98%。 在 **敏捷 BI** 领域,StarRocks 已完成 25% 切换,月均查询成功数超 25 万,P90 查询时长缩短至 5 秒,相比 Presto 提升 75%。 在 **研发工具平台** 方面,StarRocks 支持准实时数据查询,数据可见性缩短至 3 分钟,查询加速使 P95 延迟降至 400 毫秒,开发效率提升 30%。
vivo 湖仓架构的性能提升之旅
|
存储 SQL 关系型数据库
拉卡拉 x Apache Doris:统一金融场景 OLAP 引擎,查询提速 15 倍,资源直降 52%
拉卡拉早期基于 Lambda 架构构建数据系统面临存储成本高、实时写入性能差、复杂查询耗时久、组件维护复杂等问题。为此,拉卡拉选择使用 Apache Doris 替换 Elasticsearch、Hive、Hbase、TiDB、Oracle / MySQL 等组件,实现了 OLAP 引擎的统一、查询性能提升 15 倍、资源减少 52% 的显著成效。
928 6
拉卡拉 x Apache Doris:统一金融场景 OLAP 引擎,查询提速 15 倍,资源直降 52%
|
关系型数据库 MySQL OLAP
无缝集成 MySQL,解锁秒级 OLAP 分析性能极限,完成任务可领取三合一数据线!
通过 AnalyticDB MySQL 版、DMS、DTS 和 RDS MySQL 版协同工作,解决大规模业务数据统计难题,参与活动完成任务即可领取三合一数据线(限量200个),还有机会抽取蓝牙音箱大奖!
|
监控 数据挖掘 OLAP
深入解析:AnalyticDB中的高级查询优化与性能调优
【10月更文挑战第22天】 AnalyticDB(ADB)是阿里云推出的一款实时OLAP数据库服务,它能够处理大规模的数据分析任务,提供亚秒级的查询响应时间。对于已经熟悉AnalyticDB基本操作的用户来说,如何通过查询优化和性能调优来提高数据处理效率,是进一步提升系统性能的关键。本文将从个人的角度出发,结合实际经验,深入探讨AnalyticDB中的高级查询优化与性能调优技巧。
951 4
|
SQL 监控 大数据
优化AnalyticDB性能:查询优化与资源管理
【10月更文挑战第25天】在大数据时代,实时分析和处理海量数据的能力成为了企业竞争力的重要组成部分。阿里云的AnalyticDB(ADB)是一款完全托管的实时数据仓库服务,支持PB级数据的秒级查询响应。作为一名已经有一定AnalyticDB使用经验的开发者,我发现通过合理的查询优化和资源管理可以显著提升ADB的性能。本文将从个人角度出发,分享我在实践中积累的经验,帮助读者更好地利用ADB的强大功能。
594 0
|
SQL 关系型数据库 网络安全
|
关系型数据库 MySQL 网络安全
5-10Can't connect to MySQL server on 'sh-cynosl-grp-fcs50xoa.sql.tencentcdb.com' (110)")
|
SQL 存储 监控
SQL Server的并行实施如何优化?
【7月更文挑战第23天】SQL Server的并行实施如何优化?
1099 13
解锁 SQL Server 2022的时间序列数据功能
【7月更文挑战第14天】要解锁SQL Server 2022的时间序列数据功能,可使用`generate_series`函数生成整数序列,例如:`SELECT value FROM generate_series(1, 10)。此外,`date_bucket`函数能按指定间隔(如周)对日期时间值分组,这些工具结合窗口函数和其他时间日期函数,能高效处理和分析时间序列数据。更多信息请参考官方文档和技术资料。
840 9
|
SQL 存储 网络安全
关系数据库SQLserver 安装 SQL Server
【7月更文挑战第26天】
498 6

相关产品

  • 云原生数据仓库AnalyticDB MySQL版
  • 云原生数据仓库 AnalyticDB PostgreSQL版
  • 推荐镜像

    更多