基于QLearning强化学习的机器人避障和路径规划matlab仿真

简介: 本文介绍了使用MATLAB 2022a进行强化学习算法仿真的效果,并详细阐述了Q-Learning原理及其在机器人避障和路径规划中的应用。通过Q-Learning算法,机器人能在未知环境中学习到达目标的最短路径并避开障碍物。仿真结果展示了算法的有效性,核心程序实现了Q表的更新和状态的可视化。未来研究可扩展至更复杂环境和高效算法。![](https://ucc.alicdn.com/pic/developer-ecology/nymobwrkkdwks_d3b95a2f4fd2492381e1742e5658c0bc.gif)等图像展示了具体仿真过程。

1.算法仿真效果
matlab2022a仿真结果如下(完整代码运行后无水印):
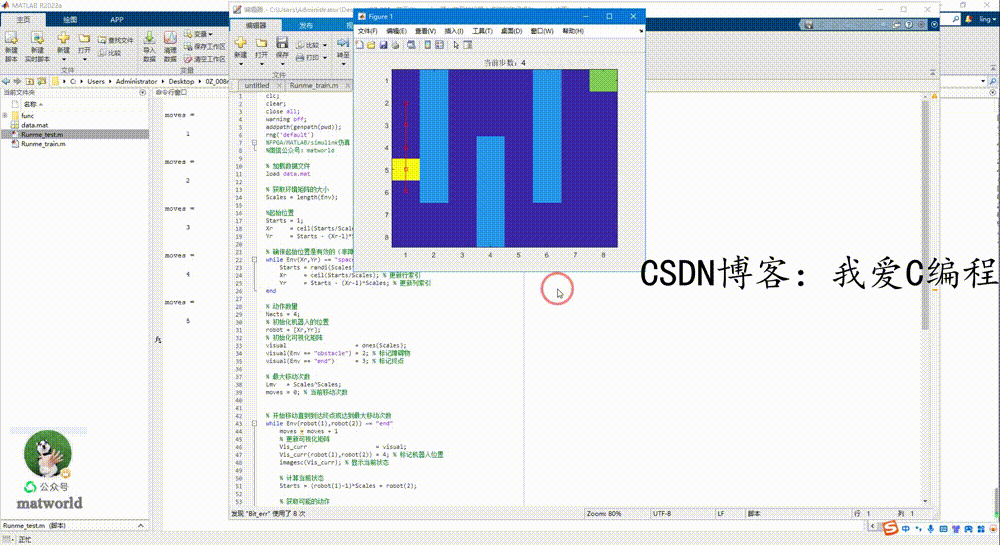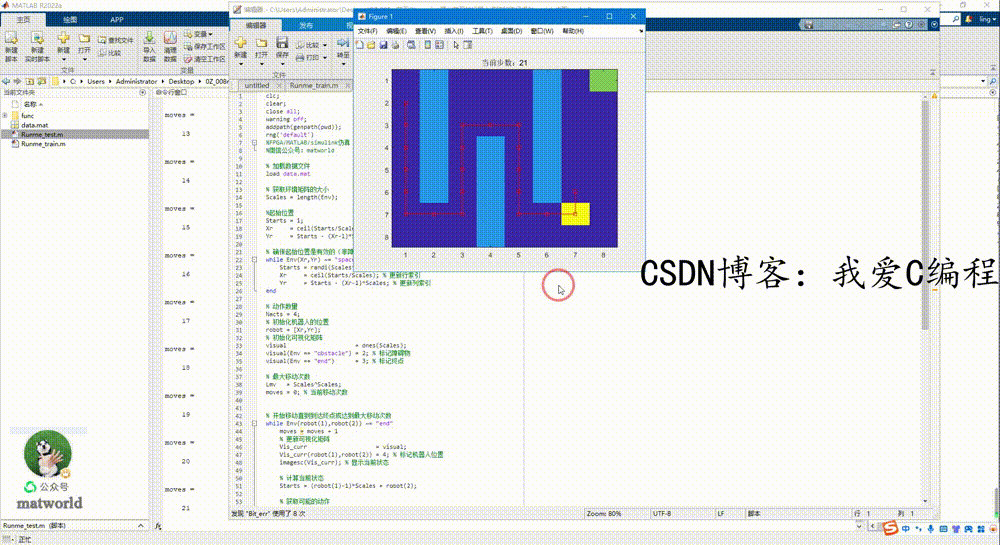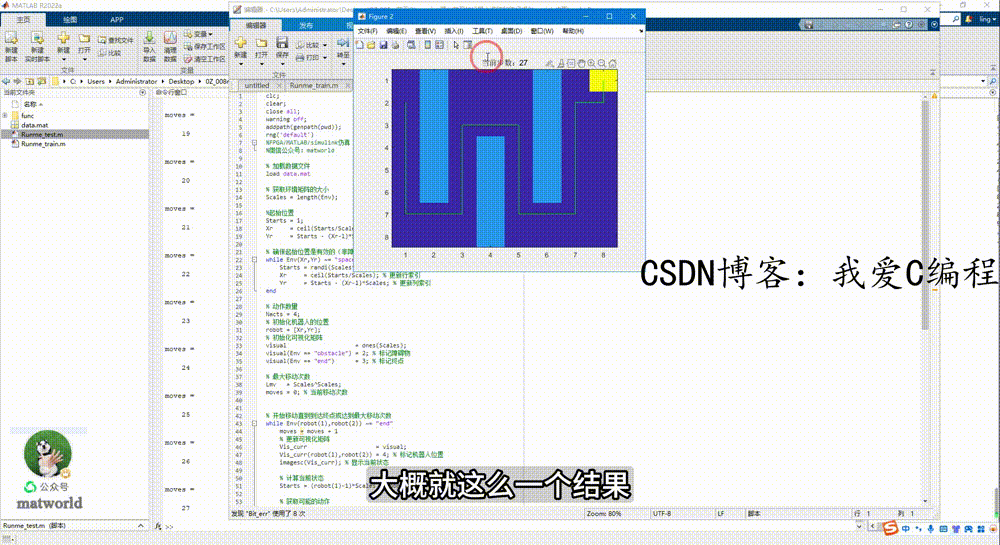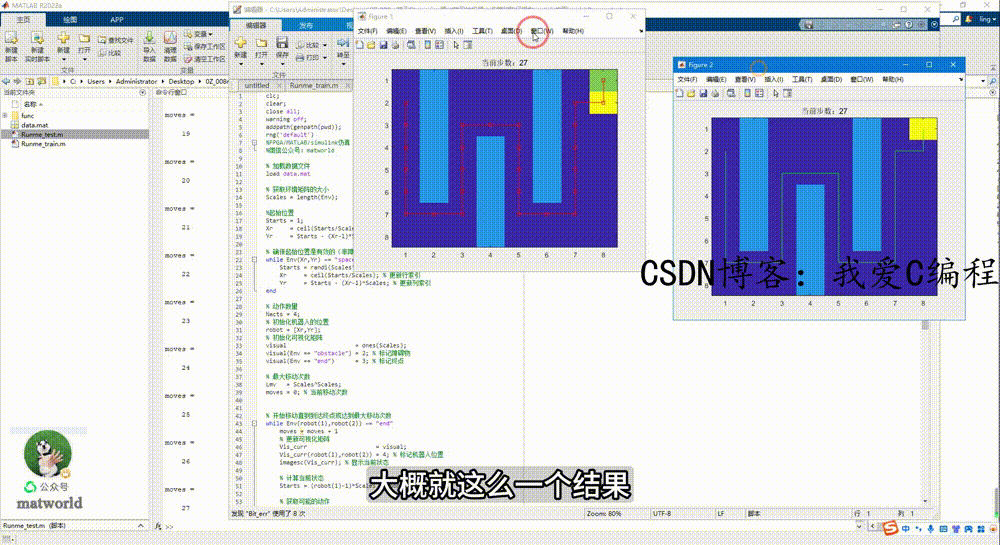
1.gif
2.jpeg
3.jpeg
4.jpeg
5.jpeg
6.jpeg
7.jpeg

2.算法涉及理论知识概要
强化学习是一种机器学习方法,它使智能体能够在与环境交互的过程中学习如何采取行动以最大化累积奖励。Q-Learning是一种无模型的强化学习算法,特别适合于离散动作空间的问题。在机器人避障和路径规划中,Q-Learning可以帮助机器人学习如何在未知环境中寻找到达目标的最短路径,同时避免碰撞障碍物。

2.1 Q-Learning原理
Q-Learning是一种基于价值迭代的算法,其目标是找到一个策略,使得在给定状态下选择的动作能够最大化未来累积奖励的期望值。该算法的核心在于更新Q表(也称为Q函数),Q表记录了在每个状态下采取不同动作所能获得的最大累积奖励的估计值。

   Q-Learning的基本更新规则如下:

0e25a8d0589debe03727fd7da4af7387_watermark,size_14,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_20,type_ZmFuZ3poZW5naGVpdGk=.png

   为了确保算法能够探索所有可行的策略,Q-Learning通常采用ε-greedy策略来进行探索与利用的平衡:

8fb16299dc83b59f34e87ce063f33cb5_watermark,size_14,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_20,type_ZmFuZ3poZW5naGVpdGk=.png

2.2 机器人避障和路径规划
状态可以定义为机器人相对于目标和障碍物的位置。例如,如果机器人在一个二维网格世界中移动,那么状态可以由机器人当前位置的坐标表示:

a9da981ec8b42636ef9ec96e8ceeea18_watermark,size_14,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_20,type_ZmFuZ3poZW5naGVpdGk=.png

   动作可以定义为机器人可以采取的不同移动方向。例如,在二维网格中,机器人可以有四个基本动作:上、下、左、右。

1b68f9e39d6fa5a74f6ed214ef3711a3_watermark,size_14,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_20,type_ZmFuZ3poZW5naGVpdGk=.png

奖励函数的设计对于引导机器人学习正确的行为至关重要。一种简单的奖励函数设计如下:

1518b6faab6fc255a580db0eb7f902b3_watermark,size_14,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_20,type_ZmFuZ3poZW5naGVpdGk=.png

接下来,机器人开始在一个虚拟环境中学习。在每个时间步骤 t:

观测状态:机器人观测当前状态st​。
选择动作:根据ε-greedy策略选择动作 at​。
执行动作:机器人执行动作 at​,进入新的状态 st+1​ 并获得奖励rt​。
更新Q表:根据Q-Learning更新规则更新Q表。
重复:回到步骤1,直到达到终止条件。
基于Q-Learning的机器人避障和路径规划是一种有效的解决方案。通过不断学习和更新Q表,机器人可以学会如何在复杂环境中规划路径并避免碰撞障碍物。未来的研究方向可以包括引入更多的状态特征、使用连续动作空间的强化学习算法(如DQN或DDPG)等,以应对更加复杂的环境和更高的计算效率需求。

3.MATLAB核心程序``` % 更新Q表
Qtab(Start_randm,Acts_temp) = (1-Lrr)Qtab(Start_randm,Acts_temp) + Lrr(Rwd + gamma * Nmax);

    % 更新状态
    Start_randm = s_n;

    % 可视化新状态
    xx             = ceil(Start_randm/Scales);
    yy             = Start_randm - (xx-1)*Scales;
    Env_cur        = Map_mat;
    Env_cur(xx,yy) = 4;

    if mod(m,100)==1
        imagesc(Env_cur);
    end

    m = m + 1;
    if m > Lmv
       flager2 = 0;
    end
    if Start_randm == Goal
       flager2 = 0;
    end
end

% 绘制Q表均值变化图
figure;
plot(epsilon2);
xlabel('训练迭代次数');
ylabel('Q收敛值');
% 保存数据
save data.mat Env Qtab Start0
0Z_008m

```
相关文章
|
算法 机器人 Serverless
【机器人路径规划】基于6种算法(黑翅鸢优化算法BKA、SSA、MSA、RTH、TROA、COA)求解机器人路径规划研究(Matlab代码实现)
944 2
|
机器学习/深度学习 编解码 算法
【机器人路径规划】基于迪杰斯特拉算法(Dijkstra)的机器人路径规划(Python代码实现)
823 4
|
机器学习/深度学习 算法 机器人
【机器人路径规划】基于A*算法的机器人路径规划研究(Python代码实现)
1274 4
|
算法 机器人 定位技术
【机器人路径规划】基于流场寻路算法(Flow Field Pathfinding)的机器人路径规划(Python代码实现)
636 4
|
机器学习/深度学习 算法 机器人
【机器人路径规划】基于深度优先搜索(Depth-First-Search,DFS)算法的机器人路径规划(Python代码实现)
509 3
|
机器学习/深度学习 算法 机器人
基于Qlearning强化学习的2DoF机械臂运动控制系统matlab仿真
本项目基于Q-learning强化学习算法,实现对二自由度机械臂的运动控制仿真。通过MATLAB 2022a平台,验证了算法在状态、动作与奖励机制下的学习效果,展示了机械臂自主学习达到目标位置的能力。内容涵盖理论模型、算法原理与核心代码实现。
346 7
|
机器学习/深度学习 存储 算法
【水下机器人建模】基于QLearning自适应强化学习PID控制器在AUV中的应用研究(Matlab代码实现)
602 0
|
机器学习/深度学习 算法 机器人
【机器人路径规划】基于D*算法的机器人路径规划(Python代码实现)
473 0
|
机器学习/深度学习 算法 机器人
【机器人路径规划】基于改进型A*算法的机器人路径规划(Python代码实现)
710 0
|
机器学习/深度学习 算法 机器人
基于类似Kiva的移动机器人的路径规划(Matlab代码实现)
333 0

热门文章

最新文章