Apache Flink 实践问题之原生TM UI日志问题如何解决

简介: Apache Flink 实践问题之原生TM UI日志问题如何解决

问题一:实时任务日志检索功能是如何解决原生TM UI日志问题的?


实时任务日志检索功能是如何解决原生TM UI日志问题的?


参考回答:

实时任务日志检索功能解决了原生TM UI日志打不开、容易卡死以及不支持检索的问题。该功能允许用户通过日志检索来验证流程的复杂逻辑,提供了比Flink UI更强大的日志检索功能。


关于本问题的更多问答可点击原文查看:

https://developer.aliyun.com/ask/674882


问题二:实时任务日志检索设计中,如何采集作业程序日志并将TM分布在不同机器上的日志集中处理?


实时任务日志检索设计中,如何采集作业程序日志并将TM分布在不同机器上的日志集中处理?


参考回答:

在实时任务日志检索的设计中,我们采用了push模式来采集作业程序日志,并通过在TaskManager下加入AOP层来实现对分布在不同机器上日志的集中处理。日志首先通过TaskManager发送task,然后经过AOP层进行日志的捕获和发送,最终通过Sender发送到Kafka进行统一处理。


关于本问题的更多问答可点击原文查看:

https://developer.aliyun.com/ask/674883


问题三:如何在不侵入作业程序的情况下采集日志?


如何在不侵入作业程序的情况下采集日志?


参考回答:

为了在不侵入作业程序的情况下采集日志,我们参考了Spring中的AOP机制,使用AspectJWeaver来创建切面。切入点设置在log4j的input或event上,这样可以在日志产生时自动捕获,而不需要修改作业程序的代码。


关于本问题的更多问答可点击原文查看:

https://developer.aliyun.com/ask/674884


问题四:如何限制作业打印大量无用日志,防止存储瓶颈?


如何限制作业打印大量无用日志,防止存储瓶颈?


参考回答:

为了限制作业打印大量无用日志,我们采用了RateLimiter进行限流。RateLimiter在日志发送到Kafka之前进行流量控制,确保日志的生成速率不会超过设定的阈值,从而防止了存储瓶颈的发生。


关于本问题的更多问答可点击原文查看:

https://developer.aliyun.com/ask/674886


问题五:中国移动信令业务的主要目的是什么?


中国移动信令业务的主要目的是什么?


参考回答:

中国移动信令业务的主要目的是为了解决各级政府部门对移动用户资源数据的需求,包括旅游部门、应急部门、交通行业等。通过对移动用户信令数据的统计和分析,为城市规划、交通规划、管理、资源配置、外来人口管理、政策制定等政府管理行为提供决策数据支持。


关于本问题的更多问答可点击原文查看:

https://developer.aliyun.com/ask/674888

相关实践学习
【涂鸦即艺术】基于云应用开发平台CAP部署AI实时生图绘板
相关文章
|
11月前
|
人工智能 数据处理 API
阿里云、Ververica、Confluent 与 LinkedIn 携手推进流式创新,共筑基于 Apache Flink Agents 的智能体 AI 未来
Apache Flink Agents 是由阿里云、Ververica、Confluent 与 LinkedIn 联合推出的开源子项目,旨在基于 Flink 构建可扩展、事件驱动的生产级 AI 智能体框架,实现数据与智能的实时融合。
1659 6
阿里云、Ververica、Confluent 与 LinkedIn 携手推进流式创新,共筑基于 Apache Flink Agents 的智能体 AI 未来
|
存储 Cloud Native 数据处理
从嵌入式状态管理到云原生架构:Apache Flink 的演进与下一代增量计算范式
本文整理自阿里云资深技术专家、Apache Flink PMC 成员梅源在 Flink Forward Asia 新加坡 2025上的分享,深入解析 Flink 状态管理系统的发展历程,从核心设计到 Flink 2.0 存算分离架构,并展望未来基于流批一体的通用增量计算方向。
792 0
从嵌入式状态管理到云原生架构:Apache Flink 的演进与下一代增量计算范式
|
SQL 人工智能 数据挖掘
Apache Flink:从实时数据分析到实时AI
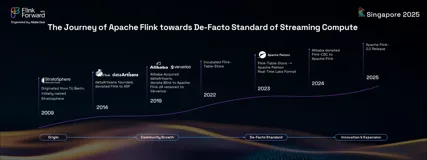
Apache Flink 是实时数据处理领域的核心技术,历经十年发展,已从学术项目成长为实时计算的事实标准。它在现代数据架构中发挥着关键作用,支持实时数据分析、湖仓集成及实时 AI 应用。随着 Flink 2.0 的发布,其在流式湖仓、AI 驱动决策等方面展现出强大潜力,正推动企业迈向智能化、实时化的新阶段。
1366 9
Apache Flink:从实时数据分析到实时AI
|
SQL 人工智能 API
Apache Flink 2.1.0: 面向实时 Data + AI 全面升级,开启智能流处理新纪元
Apache Flink 2.1.0 正式发布,标志着实时数据处理引擎向统一 Data + AI 平台迈进。新版本强化了实时 AI 能力,支持通过 Flink SQL 和 Table API 创建及调用 AI 模型,新增 Model DDL、ML_PREDICT 表值函数等功能,实现端到端的实时 AI 工作流。同时增强了 Flink SQL 的流处理能力,引入 Process Table Functions(PTFs)、Variant 数据类型,优化流式 Join 及状态管理,显著提升作业稳定性与资源利用率。
1049 0
|
存储 监控 数据挖掘
京东物流基于Flink & StarRocks的湖仓建设实践
本文整理自京东物流高级数据开发工程师梁宝彬在Flink Forward Asia 2024的分享,聚焦实时湖仓的探索与建设、应用实践、问题思考及未来展望。内容涵盖京东物流通过Flink和Paimon等技术构建实时湖仓体系的过程,解决复杂业务场景下的数据分析挑战,如多维OLAP分析、大屏监控等。同时,文章详细介绍了基于StarRocks的湖仓一体方案,优化存储成本并提升查询效率,以及存算分离的应用实践。最后,对未来数据服务的发展方向进行了展望,计划推广长周期数据存储服务和原生数据湖建设,进一步提升数据分析能力。
1568 1
京东物流基于Flink & StarRocks的湖仓建设实践
|
人工智能 运维 Java
Flink Agents:基于Apache Flink的事件驱动AI智能体框架
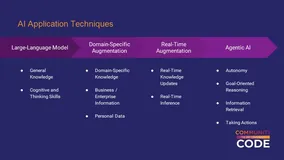
本文基于Apache Flink PMC成员宋辛童在Community Over Code Asia 2025的演讲,深入解析Flink Agents项目的技术背景、架构设计与应用场景。该项目聚焦事件驱动型AI智能体,结合Flink的实时处理能力,推动AI在工业场景中的工程化落地,涵盖智能运维、直播分析等典型应用,展现其在AI发展第四层次——智能体AI中的重要意义。
3716 27
Flink Agents:基于Apache Flink的事件驱动AI智能体框架
|
SQL 存储 运维
Apache Doris 在菜鸟的大规模湖仓业务场景落地实践
本文介绍了 Apache Doris 在菜鸟的大规模落地的实践经验,菜鸟为什么选择 Doris,以及 Doris 如何在菜鸟从 0 开始,一步步的验证、落地,到如今上万核的规模,服务于各个业务线,Doris 已然成为菜鸟 OLAP 数据分析的最优选型。
797 2
Apache Doris 在菜鸟的大规模湖仓业务场景落地实践
|
12月前
|
SQL 人工智能 数据挖掘
Apache Doris 4.0 AI 能力揭秘(二):为企业级应用而生的 AI 函数设计与实践
Apache Doris 4.0 原生集成 LLM 函数,将大语言模型能力深度融入 SQL 引擎,实现文本处理智能化与数据分析一体化。通过十大函数,支持智能客服、内容分析、金融风控等场景,提升实时决策效率。采用资源池化管理,保障数据一致性,降低传输开销,毫秒级完成 AI 分析。结合缓存复用、并行执行与权限控制,兼顾性能、成本与安全,推动数据库向 AI 原生演进。
1147 0
Apache Doris 4.0 AI 能力揭秘(二):为企业级应用而生的 AI 函数设计与实践
|
存储 人工智能 数据处理
对话王峰:Apache Flink 在 AI 时代的“剑锋”所向
Flink 2.0 架构升级实现存算分离,迈向彻底云原生化,支持更大规模状态管理、提升资源效率、增强容灾能力。通过流批一体与 AI 场景融合,推动实时计算向智能化演进。生态项目如 Paimon、Fluss 和 Flink CDC 构建湖流一体架构,实现分钟级时效性与低成本平衡。未来,Flink 将深化 AI Agents 框架,引领事件驱动的智能数据处理新方向。
1210 6
|
消息中间件 存储 Kafka
Apache Flink错误处理实战手册:2年生产环境调试经验总结
本文由 Ververica 客户成功经理 Naci Simsek 撰写,基于其在多个行业 Flink 项目中的实战经验,总结了 Apache Flink 生产环境中常见的三大典型问题及其解决方案。内容涵盖 Kafka 连接器迁移导致的状态管理问题、任务槽负载不均问题以及 Kryo 序列化引发的性能陷阱,旨在帮助企业开发者避免常见误区,提升实时流处理系统的稳定性与性能。
970 0
Apache Flink错误处理实战手册:2年生产环境调试经验总结

推荐镜像

更多