阿里云DataWorks-部署自定义python项目问题

简介: 阿里云DataWorks-多种方式部署自定义python项目并进行调度

1. 问题描述

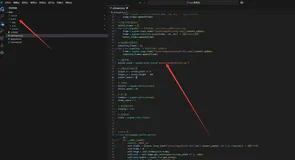
如下图所示项目结构,项目下存在main.py主文件,有自定义的python package(config以及utils两个module),希望能在dataworks上部署并调度、运行起来。

image.png image.png

2. 解决方案

2.1. 方案1

参考dataworks官方文档:

https://help.aliyun.com/zh/dataworks/use-cases/use-a-pyodps-node-to-reference-a-third-party-package?spm=a2c4g.11186623.0.i19#section-zvo-alt-b9q

如上图所示project结构,将time_config.py,local_vars.py通过【资源->新建资源->python】创建资源 image.png

将项目中的main.py的主文件,创建pyodps3的节点,并将代码复制进去,使用

##@resource_reference{"local_vars.py"}
sys.path.append(os.path.dirname(os.path.abspath('local_vars.py'))) #引入资源至工作空间。
# from utils.local_vars import ali_name
# 修改引用代码 如下
from local_vars import ali_name

的方式引用该python脚本并添加到sys path中确保可以后续进行import

image.png

2.2. 方案2

直接将project通过zip打包,通过【资源->新建资源->archive】 上传zip资源并提交到生产环境,这时候dataworks也会将这个zip包传到对应的odps的项目。

dataworks界面:

image.png

odps界面看下resource:

image.png

代码:需要把项目中的main方法复制出来,创建一个pyodps3的节点,并做一些代码改造,详细的看下面这段代码的注释

'''PyODPS 3
请确保不要使用从 MaxCompute下载数据来处理。下载数据操作常包括Table/Instance的open_reader以及 DataFrame的to_pandas方法。 
推荐使用 PyODPS DataFrame(从 MaxCompute 表创建)和MaxCompute SQL来处理数据。
更详细的内容可以参考:https://help.aliyun.com/document_detail/90481.html
'''
# This is a sample Python script.
# Press ⌃R to execute it or replace it with your code.
# Press Double ⇧ to search everywhere for classes, files, tool windows, actions, and settings.
# 这里要引入odps,从odps读这个archive的zip包,即自己写的package
from odps import ODPS
o = ODPS('ak','sk','<project_name>')
# 这里通过get resource方法读到这个zip包
r = o.get_resource("dataworks_test01.zip")
import sys, zipfile
from odps.lib.importer import CompressImporter
# append到sys path中
sys.meta_path.append(CompressImporter(zipfile.ZipFile(r.open("rb"))))
# 这会引用的代码不需要方案1中的修改,zip文件解压后会保留这个文件的层级
from utils.local_vars import ali_name
from config.time_config import time_zone
def print_hi(name):
    # Use a breakpoint in the code line below to debug your script.
    print(f'Hi, {name}')  # Press ⌘F8 to toggle the breakpoint.
# Press the green button in the gutter to run the script.
if __name__ == '__main__':
    print_hi(ali_name + 'time zone is ' + time_zone)
# See PyCharm help at https://www.jetbrains.com/help/pycharm/

执行成功的结果见dataworks的那个页面。

2.3. 方案3

这个方案仅在打包的时候有所不同,如果客户除了自定义的package还借助了开源的package需要打包到zip里,可以参考下:https://pyodps.readthedocs.io/zh-cn/stable/pyodps-pack.html 用toml的方式指定,不过强烈建议客户使用独享资源组的运维助手通过pip直接安装开源包到资源组上。

除打包外其他操作过程同方案2

相关实践学习
基于Hologres轻量实时的高性能OLAP分析
本教程基于GitHub Archive公开数据集,通过DataWorks将GitHub中的项⽬、行为等20多种事件类型数据实时采集至Hologres进行分析,同时使用DataV内置模板,快速搭建实时可视化数据大屏,从开发者、项⽬、编程语⾔等多个维度了解GitHub实时数据变化情况。
相关文章
|
12月前
|
异构计算 Python
ERROR: pip’s dependency resolver does not currently take into 报错-Python项目依赖冲突的解决方案-优雅草优雅草卓伊凡
895 1
|
API 语音技术 开发者
Python 项目打包,并上传到 PyPI,分享项目
本文介绍了如何使用 Poetry 打包并发布一个 Python 项目至 PyPI。内容包括:项目创建、配置 `pyproject.toml` 文件、构建软件包、上传至 PyPI、安装与使用。通过实例 iGTTS 展示了从开发到发布的完整流程,帮助开发者快速分享自己的 Python 工具。
|
JavaScript 前端开发 机器人
【Azure Bot Service】在中国区Azure上部署机器人的 Python 版配置
本文介绍了在中国区Azure上使用Python SDK配置Azure Bot Service时遇到的问题及解决方案,涵盖参数设置与适配器配置,适用于希望在Azure中国区部署Python机器人的开发者。
337 9
|
12月前
|
人工智能 Shell Python
ERROR: pip’s dependency resolver does not currently take into 报错-Python项目依赖冲突的解决方案-优雅草优雅草卓伊凡
442 0
|
监控 大数据 API
Python 技术员实践指南:从项目落地到技术优化
本内容涵盖Python开发的实战项目、技术攻关与工程化实践,包括自动化脚本(日志分析系统)和Web后端(轻量化API服务)两大项目类型。通过使用正则表达式、Flask框架等技术,解决日志分析效率低与API服务性能优化等问题。同时深入探讨内存泄漏排查、CPU瓶颈优化,并提供团队协作规范与代码审查流程。延伸至AI、大数据及DevOps领域,如商品推荐系统、PySpark数据处理和Airflow任务编排,助力开发者全面提升从编码到架构的能力,积累高并发与大数据场景下的实战经验。
Python 技术员实践指南:从项目落地到技术优化
|
程序员 测试技术 开发工具
怎么开发Python第三方库?手把手教你参与开源项目!
大家好,我是程序员晚枫。本文将分享如何开发Python第三方库,并以我维护的开源项目 **popdf** 为例,指导参与开源贡献。Popdf是一个PDF操作库,支持PDF转Word、转图片、合并与加密等功能。文章涵盖从fork项目、本地开发、单元测试到提交PR的全流程,适合想了解开源贡献的开发者。欢迎访问[popdf](https://gitcode.com/python4office/popdf),一起交流学习!
505 21
怎么开发Python第三方库?手把手教你参与开源项目!
|
人工智能 安全 Shell
Jupyter MCP服务器部署实战:AI模型与Python环境无缝集成教程
Jupyter MCP服务器基于模型上下文协议(MCP),实现大型语言模型与Jupyter环境的无缝集成。它通过标准化接口,让AI模型安全访问和操作Jupyter核心组件,如内核、文件系统和终端。本文深入解析其技术架构、功能特性及部署方法。MCP服务器解决了传统AI模型缺乏实时上下文感知的问题,支持代码执行、变量状态获取、文件管理等功能,提升编程效率。同时,严格的权限控制确保了安全性。作为智能化交互工具,Jupyter MCP为动态计算环境与AI模型之间搭建了高效桥梁。
970 2
Jupyter MCP服务器部署实战:AI模型与Python环境无缝集成教程
|
测试技术 Python
【03】做一个精美的打飞机小游戏,规划游戏项目目录-分门别类所有的资源-库-类-逻辑-打包为可玩的exe-练习python打包为可执行exe-优雅草卓伊凡-持续更新-分享源代码和游戏包供游玩-1.0.2版本
901 31
【03】做一个精美的打飞机小游戏,规划游戏项目目录-分门别类所有的资源-库-类-逻辑-打包为可玩的exe-练习python打包为可执行exe-优雅草卓伊凡-持续更新-分享源代码和游戏包供游玩-1.0.2版本
|
机器学习/深度学习 人工智能 分布式计算
我的阿里云社区年度总结报告:Python、人工智能与大数据领域的探索之旅
553 35

相关产品

  • 大数据开发治理平台 DataWorks
  • 推荐镜像

    更多