问题一:flink cdc3.0,如果修改表结构导致作业失败了应该怎么处理?怎么样忽略这个错误?
flink cdc3.0,如果修改表结构导致作业失败了应该怎么处理?怎么样忽略这个错误?要增加表应该怎么处理?
参考回答:
参考这个:
https://github.com/ververica/flink-cdc-connectors/pull/2986
关于本问题的更多回答可点击原文查看:
https://developer.aliyun.com/ask/596188?spm=a2c6h.13066369.question.36.283f3f33q1oBh6
问题二:Flink CDC我们的tidb一个表大概200-300个字段,增删改都有。这种cdc是否可以支持?
Flink CDC里我们的tidb一个表大概200-300个字段,增删改都有。这种cdc是否可以支持?
参考回答:
Flink CDC可以支持具有200-300个字段的TiDB表的增删改操作。
Flink CDC(Change Data Capture)是一个用于捕获和处理数据库变更记录的技术,它能够监控数据库的日志文件,实时捕捉数据的变化。对于包含大量字段的表,Flink CDC理论上是可以支持的,但实际应用中可能会遇到一些挑战:
性能影响:表的字段数量增加可能会导致处理变更记录时的性能下降。这是因为更多的数据需要被序列化、传输和处理。因此,在实施之前,建议进行性能测试,以确保CDC能够满足您的性能要求。
稳定性考虑:复杂的表结构可能会对CDC的稳定性造成影响。在生产环境中使用CDC时,应该密切关注其运行状态,并准备好相应的监控和故障恢复机制。
资源需求:处理大型表的变更可能需要更多的计算和内存资源。在部署CDC之前,应该评估现有的硬件资源是否足够,以及是否需要进行扩展。
版本兼容性:确保使用的Flink CDC版本与TiDB的版本兼容,以及是否支持您所需的所有数据变更类型。
实际测试:在决定使用Flink CDC之前,最好在实际的生产环境中进行彻底的测试,以确保它能够符合您的业务需求和技术预期。
文档参考:查阅Flink和TiDB的官方文档,了解有关CDC的最新信息和最佳实践,这可以帮助您更好地规划和实施CDC解决方案。
社区支持:如果可能,寻求来自Flink和TiDB社区的支持和建议,特别是在处理大型和复杂表结构时。
总之,虽然Flink CDC可以支持具有大量字段的表,但在实际操作中,您需要考虑多方面的因素,并进行充分的测试和准备,以确保CDC的实施既高效又稳定。
关于本问题的更多回答可点击原文查看:
https://developer.aliyun.com/ask/595564?spm=a2c6h.13066369.question.37.283f3f337iizGK
问题三:Flink CDC里我们的tidb版本是6.5,社区有计划大概什么时候支持吗?
Flink CDC里我们的tidb版本是6.5,我看cdc最新2.3.0支持6.0.0。对于6.5版本,社区有计划大概什么时候支持吗?
参考回答:
目前社区还没有明确的计划支持TiDB 6.5版本。
Flink CDC是一个不断更新和发展的项目,它对不同版本的数据库支持可能会随着时间而改变。对于您提到的TiDB 6.5版本,虽然目前的Flink CDC 2.3.0版本还没有官方支持,但社区可能会在未来的版本中加入对该版本的支持。为了获取最新的信息和动态,建议您:
关注Flink CDC的官方网站和社区论坛:这些平台会发布最新的版本更新和路线图,包括对新版本数据库的支持情况。
订阅相关的邮件列表或RSS源:这样您可以及时收到更新通知,了解社区的最新讨论和开发进展。
参与社区讨论:如果可能,您可以在社区中表达对TiDB 6.5支持的需求,这有助于提高问题的可见性,并可能加速支持计划的实施。
此外,如果您有紧急的需求或者想要为TiDB 6.5版本的支持做出贡献,您也可以考虑与社区开发者联系,探讨合作的可能性。同时,您还可以探索其他第三方工具或自行开发解决方案,以桥接当前版本与TiDB之间的兼容性问题。
关于本问题的更多回答可点击原文查看:
https://developer.aliyun.com/ask/595562?spm=a2c6h.13066369.question.38.283f3f333rRLXz
问题四:Flink CDC里pipeline方式是自动进行端到端的表结构变更,SQL方式就不支持了吧?
Flink CDC里pipeline方式是自动进行端到端的表结构变更,datastream方式需要手动处理,SQL方式就不支持了,对吧?
参考回答:
Flink CDC的pipeline方式支持表结构变更,而DataStream API需要手动处理,SQL方式不支持。具体如下:
Pipeline方式:Flink CDC提供了端到端的表结构变更自动同步功能。这意味着,当数据库中的表结构发生变化时,Flink CDC可以自动捕捉这些变更,并在数据处理流程中反映出来。这大大简化了数据流的处理过程,因为用户不需要编写额外的代码来处理这些变更。
DataStream API:在使用DataStream API时,表结构的变更需要开发者手动处理。这是因为DataStream API提供了更多的控制和灵活性,允许开发者精确地定义如何处理数据流和状态。因此,对于表结构的变更,开发者需要自己编写逻辑来适应这些变化。
SQL方式:Flink CDC在SQL方式下不支持表结构变更。这意味着如果使用SQL来定义数据处理逻辑,那么当底层数据库表结构发生变化时,可能需要手动更新SQL查询语句以保持一致性。
综上所述,Flink CDC在不同的使用方式下对表结构变更的支持程度不同。Pipeline方式提供了自动化的变更同步,而DataStream API则需要手动处理,SQL方式则不支持表结构变更。在选择使用哪种方式时,需要根据具体的应用场景和需求来决定。
关于本问题的更多回答可点击原文查看:
https://developer.aliyun.com/ask/595561?spm=a2c6h.13066369.question.39.283f3f33xgr5J9
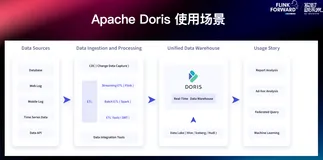
问题五:flink cdc中,我们用的还是4.x ,现在想把数据同步到doris,不知道咋整了?
flink cdc中,我们用的还是4.x ,现在想把数据同步到doris,不知道咋整了
参考回答:
要将Flink CDC 4.x中的数据同步到Doris,你可以按照以下步骤进行操作:
1. 首先,确保你已经安装并配置了Flink CDC 4.x和Doris。如果还没有安装,请参考官方文档进行安装和配置。
1. 在Flink CDC中,创建一个数据源来读取CDC数据。你可以使用Flink CDC Connector提供的API来连接CDC数据源。例如,如果你使用的是MySQL数据库,可以使用如下代码创建数据源:
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;
import org.apache.flink.table.api.bridge.java.internal.StreamTableEnvironmentImpl;
// 创建Flink流处理环境
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
// 创建Flink Table API环境
StreamTableEnvironment tableEnv = StreamTableEnvironmentImpl.create(env);
// 定义CDC数据源
String sourceDDL = "CREATE TABLE my_cdc_source (" +
                   " id INT NOT NULL," +
                   " name STRING," +
                   " age INT" +
                   ") WITH (" +
                   " 'connector' = 'mysql-cdc'," +
                   " 'hostname' = 'localhost'," +
                   " 'port' = '3306'," +
                   " 'username' = 'root'," +
                   " 'password' = 'password'," +
                   " 'database-name' = 'mydb'," +
                   " 'table-name' = 'users'" +
                   ")";
// 执行DDL语句创建表
tableEnv.executeSql(sourceDDL);
1. 在Doris中创建一个目标表,用于接收同步过来的数据。你可以使用Doris提供的SQL语句创建目标表,例如:
CREATE TABLE my_doris_sink (
  id INT,
  name VARCHAR,
  age INT
) ENGINE=OLAP
AGGREGATE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 10;
1. 在Flink CDC中,创建一个数据汇来将数据写入Doris。你可以使用Flink SQL或Table API来实现数据的写入。例如,使用Flink SQL可以实现如下:
// 定义数据汇的DDL语句
String sinkDDL = "CREATE TABLE my_doris_sink (" +
                " id INT NOT NULL," +
                " name STRING," +
                " age INT" +
                ") WITH (" +
                " 'connector' = 'jdbc'," +
                " 'url' = 'jdbc:mysql://localhost:9030/mydb'," +
                " 'table-name' = 'my_doris_sink'," +
                " 'username' = 'root'," +
                " 'password' = 'password'" +
                ")";
// 执行DDL语句创建表
tableEnv.executeSql(sinkDDL);
// 定义数据同步的SQL语句
String syncSQL = "INSERT INTO my_doris_sink SELECT * FROM my_cdc_source";
// 执行数据同步的SQL语句
tableEnv.executeSql(syncSQL);
1. 最后,启动Flink作业并等待数据同步完成。你可以在Flink的Web界面或日志中查看作业的状态和进度。
这样,你就可以将Flink CDC 4.x中的数据同步到Doris了。请注意,上述代码示例仅供参考,实际使用时需要根据你的环境和需求进行相应的修改和调整。
关于本问题的更多回答可点击原文查看:
https://developer.aliyun.com/ask/595440?spm=a2c6h.13066369.question.40.283f3f33bsQjxe