目录
ELK日志收集系统是一种集中式日志管理系统,由Elasticsearch(搜索和分析引擎)、Logstash(数据收集、过滤、转换工具)和Kibana(可视化和分析工具)组成。ELK系统可以帮助用户收集、存储、搜索、分析和可视化大量的日志数据。
ELK日志收集系统的工作流程如下:
- Logstash从各种来源(如文件、网络、数据库)收集日志数据。
- Logstash将收集到的数据进行过滤和转换,然后将其发送给Elasticsearch进行存储和索引。
- Elasticsearch对接收到的日志数据建立索引,以便快速搜索和分析。
- Kibana作为可视化和分析工具,可以通过Web界面连接到Elasticsearch,提供丰富的搜索、过滤、分析和可视化功能。
ELK日志收集系统的优点包括:
- 高可扩展性:ELK系统可以处理TB级别的日志数据,并能够水平扩展以应对日志数据量的增长。
- 实时性:ELK系统能够实时收集、存储和分析日志数据,使用户可以及时监控系统运行状态和处理潜在问题。
- 多样化的数据源支持:Logstash支持从各种来源收集数据,包括文件、网络、数据库等。
- 强大的搜索和分析功能:Elasticsearch提供了全文搜索、聚合分析、实时监控等功能,帮助用户快速定位和解决问题。
- 可视化界面:Kibana提供了直观易用的可视化界面,用户可以通过简单的拖拽操作创建仪表盘、图表和报告。
总的来说,ELK日志收集系统是一种功能强大的日志管理工具,可以帮助用户实时收集、存储、搜索、分析和可视化大量的日志数据,提高系统监控和故障排查的效率。
一、概述
1、ELK由三个组件构成
2、作用
日志收集
日志分析
日志可视化
3、为什么使用?
日志对于分析系统、应用的状态十分重要,但一般日志的量会比较大,并且比较分散。
如果管理的服务器或者程序比较少的情况我们还可以逐一登录到各个服务器去查看、分析。但如果服务器或者程序的数量比较多了之后这种方法就显得力不从心。基于此,一些集中式的日志系统也就应用而生。目前比较有名成熟的有,Splunk(商业)、FaceBook 的Scribe、Apache的Chukwa Cloudera的Fluentd、还有ELK等等。
二、组件
1、elasticsearch
日志分析
开源的日志收集、分析、存储程序
特点
分布式
零配置
自动发现
索引自动分片
索引副本机制
Restful风格接口
多数据源
自动搜索负载
2、logstash
日志收集
搜集、分析、过滤日志的工具
工作过程
一般工作方式为c/s架构,Client端安装在需要收集日志的服务器上,Server端负责将收到的节点日志进行过滤、修改等操作,再一并发往Elasticsearch上去
Inputs → Filters → Outputs
输入-->过滤-->输出
INPUT
File:从文件系统的文件中读取,类似于tail -f命令
Syslog:在514端口上监听系统日志消息,并根据RFC3164标准进行解析
Redis:从redis service中读取
Beats:从filebeat中读取
FILETER
Grok:解析任意文本数据,Grok 是 Logstash 最重要的插件。它的主要作用就是将文本格式的字符串,转换成为具体的结构化的数据,配合正则表达式使用。
官方提供的grok表达式:logstash-patterns-core/patterns at main · logstash-
plugins/logstash-patterns-core · GitHub
Grok在线调试:Grok Debugger
Mutate:对字段进行转换。例如对字段进行删除、替换、修改、重命名等。
Drop:丢弃一部分Events不进行处理。
Clone:拷贝Event,这个过程中也可以添加或移除字段。
Geoip:添加地理信息(为前台kibana图形化展示使用)
OUTPUTS
Elasticsearch:可以高效的保存数据,并且能够方便和简单的进行查询。
File:将Event数据保存到文件中。
Graphite:将Event数据发送到图形化组件中,踏实一个当前较流行的开源存储图形化展示的组件。
3、kibana
日志可视化
为Logstash和ElasticSearch在收集、存储的日志基础上进行分析时友好的Web界面,可以帮助汇总、分析和搜索重要数据日志。
三、架构类型
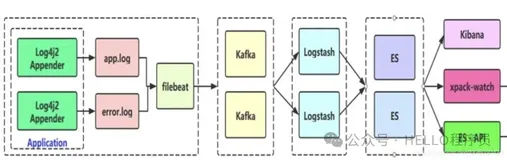
1、ELK
es
logstash
kibana
2、ELKK
es
logstash
kafka
kibana
3、ELFK
es
logstash
重量级
占用系统资源较多
filebeat
轻量级
占用系统资源较少
kibana
4、ELFKK
es
logstash
filebeat
kafka
kibana
四、ELK日志收集系统集群实验
1、实验拓扑
机子必须是4核4g

2、环境配置
设置各个主机的IP地址为拓扑中的静态IP,在两个节点中修改主机名为node1和node2并设置hosts文件
node1:
hostnamectl set-hostname node1
vim /etc/hosts
192.168.1.1 node1
192.168.1.2 node2

node2:
hostnamectl set-hostname node2
vim /etc/hosts
192.168.1.1 node1
192.168.1.2 node2

3、 安装node1与node2节点的elasticsearch
3.1.安装
mv elk软件包 elk
cd elk
rpm -ivh elasticsearch-5.5.0.rpm

3.2配置
node1:
vim /etc/elasticsearch/elasticsearch.yml
cluster.name:my-elk-cluster //集群名称
node.name:node1 //节点名字
path.data:/var/lib/elasticsearch //数据存放路径
path.logs: /var/log/elasticsearch/ //日志存放路径
bootstrap.memory_lock:false //在启动的时候不锁定内存
network.host:0.0.0.0 //提供服务绑定的IP地址,0.0.0.0代表所有地址
http.port:9200 //侦听端口为9200
discovery.zen.ping.unicast.hosts:【"node1","node2"】 //群集发现通过单播实现
systemctl daemon-reload
systemctl restart elasticsearch.service
node2:
vim /etc/elasticsearch/elasticsearch.yml
cluster.name:my-elk-cluster //集群名称
node.name:node2 //节点名字
path.data:/var/lib/elasticsearch //数据存放路径
path.logs: /var/log/elasticsearch/ //日志存放路径
bootstrap.memory_lock:false //在启动的时候不锁定内存
network.host:0.0.0.0 //提供服务绑定的IP地址,0.0.0.0代表所有地址
http.port:9200 //侦听端口为9200
discovery.zen.ping.unicast.hosts:【"node1","node2"】 //群集发现通过单播实现
4、启动elasticsearch服务
node1和node2
systemctl start elasticsearch
4.1查看节点信息


5、在node1安装elasticsearch-head插件
5.1安装node
cd elk
tar xf node-v8.2.1.tar.gz
cd node-v8.2.1
./configure && make -j4 && make install
等待安装完毕。

5.2拷贝命令
cd elk
tar xf phantomjs-2.1.1-linux-x86_64.tar.bz2
cd phantomjs-2.1.1-linux-x86_64/bin
cp phantomjs  /usr/local/bin

5.3安装elasticsearch-head
cd elk
tar xf elasticsearch-head.tar.gz
cd elasticsearch-head
npm install

5.4修改elasticsearch配置文件
vim /etc/elasticsearch/elasticsearch.yml
# Require explicit names when deleting indices:
#
#action.destructive_requires_name:true
http.cors.enabled: true //开启跨域访问支持,默认为false
http.cors.allow-origin:"*" //跨域访问允许的域名地址

重启服务: systemctl restart elasticsearch
systemctl restart elasticsearch

5.5启动elasticsearch-head
cd /root/elk/elasticsearch-head
npm run start &

查看监听: netstat -anput | grep :9100

访问:

5.6测试
在node1的终端中输入:
curl -XPUT '192.168.28.3:9200/index-demo/test/1?pretty&pretty' -H 'Content-Type: application/json' -d '{"user":"zhangsan","mesg":"hello world"}'

刷新浏览器可以看到对应信息即可


6、node1服务器安装logstash
cd  elk
rpm -ivh logstash-5.5.1.rpm
systemctl start logstash.service
ln -s /usr/share/logstash/bin/logstash  /usr/local/bin/

测试1: 标准输入与输出
logstash -e 'input{ stdin{} }output { stdout{} }'

测试2: 使用rubydebug解码
logstash -e 'input { stdin{} } output { stdout{ codec=>rubydebug }}'

测试3:输出到elasticsearch
logstash -e 'input { stdin{} } output { elasticsearch{ hosts=>["192.168.28.3:9200"]} }'

查看结果:
若看不到,请刷新!!!

7、logstash日志收集文件格式(默认存储在/etc/logstash/conf.d)
Logstash配置文件基本由三部分组成:input、output以及 filter(根据需要)。标准的配置文件格式如下:
input (...) 输入
filter {...} 过滤
output {...} 输出
在每个部分中,也可以指定多个访问方式。例如,若要指定两个日志来源文件,则格式如下:
input {
file{path =>"/var/log/messages" type =>"syslog"}
file { path =>"/var/log/apache/access.log" type =>"apache"}
}
7.1案例:通过logstash收集系统信息日志
chmod o+r /var/log/messages
vim /etc/logstash/conf.d/system.conf

input {
file{
path =>"/var/log/messages"
type => "system"
start_position => "beginning"
}
}
output {
elasticsearch{
hosts =>["192.168.28.3:9200"]
index => "system-%{+YYYY.MM.dd}"
}
}

重启日志服务: systemctl restart logstash
systemctl restart logstash
查看日志: http://192.168.28.3:9100

8、node1节点安装kibana
cd elk
rpm -ivh kibana-5.5.1-x86_64.rpm
配置kibana
vim /etc/kibana/kibana.yml

server.port:5601 //Kibana打开的端口
server.host:"0.0.0.0" //Kibana侦听的地址
elasticsearch.url: "http://192.168.8.134:9200"
//和Elasticsearch 建立连接
kibana.index:".kibana" //在Elasticsearch中添加.kibana索引

启动kibana
systemctl start kibana

访问一下端口192.168.28.3:9100

访问kibana :
首次访问需要添加索引,我们添加前面已经添加过的索引:system-* 

9、企业案例:
收集httpd访问日志信息
在httpd服务器上安装logstash,参数上述安装过程,可以不进行测试
logstash在httpd服务器上作为agent(代理),不需要启动

编写httpd日志收集配置文件
vim /etc/logstash/conf.d/httpd.conf


input {
file{
path =>"/var/log/httpd/access_log"
type => "access"
start_position => "beginning"
}
}
output {
elasticsearch{
hosts =>["192.168.28.3:9200"]
index => "httpd_access-%{+YYYY.MM.dd}"
}
}
使用logstash命令导入配置:
/usr/share/logstash/bin/logstash -f /etc/logstash/conf.d/httpd.conf