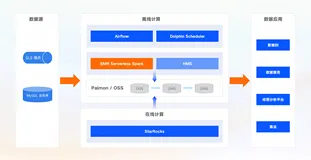
EMR Serverless StarRocks 是开源 StarRocks 在阿里云上的全托管服务,您可以通过 EMR Serverless StarRocks 灵活的创建和管理 StarRocks 实例以及数据。StarRocks 作为一款兼容 MySQL 协议的 OLAP 分析引擎,提供了极致的性能和丰富的 OLAP 场景模型,包括 OLAP 多维分析、数据湖分析、高并发查询以及实时数据分析。
EMR Serverless StarRocks 5000CU*H 计算资源,48000GB*H存储资源免费试用,前往试用>>
产品核心优势:
1、全托管免运维,降低运维成本及使用复杂度
2、可视化、高效率的实例管理、监控告警及配置管理能力
3、专业的StarRocks Manager,提供便捷、可视化的元数据管理、诊断与优化、以及用户管理和授权能力。
EMR Serverless StarRocks 使用教程简介
基于历史世界杯数据集,在阿里云EMR Serverless StarRocks上创建StarRocks的数据库、数据表,并使用StarRocks进行数据查询,帮助您快速体验EMR Serverless StarRocks。
准备环境和资源
开始教程前,请按以下步骤准备环境和资源:
- 访问阿里云免费试用。单击页面右上方的登录/注册按钮,并根据页面提示完成账号登录(已有阿里云账号)、账号注册(尚无阿里云账号)或实名认证(根据试用产品要求完成个人实名认证或企业实名认证)。
- 成功登录后,在产品类别下选择大数据计算>数据湖,在EMR Serverless StarRocks卡片上,单击立即试用。
- 如果您第一次访问该服务,可能需要进行角色授权。请在弹出的授权请求页面,单击前往RAM进行授权后,单击同意授权,完成自动化角色授权。授权成功后,需返回立即试用页面。
- 配置教程参数。完成本教程需要的配置如表格所示,未提及的配置保持默认或按需修改。
配置项 |
说明 |
地域 |
华北2(北京) |
可用区 |
可用区G |
专有网络 |
选择您已创建的专有网络。如果没有创建,请参见创建和管理专有网络创建。 |
交换机 |
选择您已创建的虚拟交换机。如果没有创建,请参见创建和管理交换机创建。 |
EMR ServerLess StarRocks资源包 |
5000 CU*时计算资源,100 GB 20天存储资源。目前仅支持抵扣华北2(北京)、华东2(上海)、华南1(深圳)和华东1(杭州)地域的按量付费资源。EMR资源抵扣包计费说明请参见计费概述。 |
监控服务 |
3个月的免费资源抵扣包。 |
负载均衡 |
3个月的免费资源抵扣包。 |
实例名称 |
实例名称,长度限制为1~64个字符,仅可使用中文、字母、数字、短划线(-)和下划线(_)。例如,test-emr。 |
登录密码和确认密码 |
自定义密码。 |
服务协议 |
选中 |
- 单击立即试用。
- 在弹出的EMR Serverless StarRocks面板中,单击任意行操作列的控制台,随后进入开源大数据平台E-MapReduce控制台。实例创建需要约3~5分钟,请耐心等待。
通过 SQL Editor 连接 StarRocks 实例
- 在开源大数据平台E-MapReduce控制台,选择左侧导航栏中的EMR Serverless > StarRocks。
- 在StarRocks页面,单击右上角的StarRocks Manager。
- 在弹出的新建连接对话框中,配置以下信息。
参数 |
说明 |
地域 |
本教程为华北2(北京)。 |
实例 |
选择EMR ServerLess StarRocks试用为您创建好的实例。 |
连接名称 |
会自动获取到实例名称。 |
用户名 |
默认初始用户名admin。 |
密码 |
admin用户的密码。 |
- 单击确定。
- 在左侧导航栏,单击SQL Editor。
创建表并导入数据
- 执行以下命令,创建数据库和表。
create database sr_db;createtable if not exists sr_db.world_cup_summary(yearvarchar(20), HostCountry varchar(20), Winner varchar(50), Second varchar(50), Third varchar(50), Fourth varchar(50), GoalsScored bigint, QualifiedTeams bigint, MatchesPlayed bigint, Attendance bigint, HostContinent varchar(50), WinnerContinent varchar(50))distributed by hash(Attendance) buckets 2properties("replication_num"="1");
world_cup_summary表包含了所有21届世界杯赛事(1930-2018)的比赛主办国、前四名队伍、总参赛队伍、总进球数、现场观众人数等汇总信息,包括如下字段:
- Year: 举办年份
- HostCountry: 举办国家
- Winner: 冠军队伍
- Second: 亚军队伍
- Third: 季军队伍
- Fourth: 第四名队伍
- GoalsScored: 总进球数
- QualifiedTeams: 总参赛队伍数
- MatchesPlayed: 总比赛场数
- Attendance: 现场观众总人数
- HostContinent: 举办国所在洲
- WinnerContinent: 冠军国家队所在洲
- 单击上方的运行。单击数据库区域右上角的
 图标,即可看到创建的库表信息。
- 执行以下命令,写入数据到StarRocks。
insertinto sr_db.world_cup_summaryvalues('1938','France','Italy','Hungary','Brazil','Sweden',84,15,18,375700,'Europe','Europe');insertinto sr_db.world_cup_summaryvalues('1958','Sweden','Brazil','Sweden','France','Germany',126,16,35,819810,'Europe','America');insertinto sr_db.world_cup_summaryvalues('1962','Chile','Brazil','Czechoslovakia','Chile','Yugoslavia',89,16,32,893172,'America','America');insertinto sr_db.world_cup_summaryvalues('1974','Germany','Germany','Netherlands','Poland','Brazil',97,16,38,1865753,'Europe','Europe');insertinto sr_db.world_cup_summaryvalues('1978','Argentina','Argentina','Netherlands','Brazil','Italy',102,16,38,1545791,'America','America');insertinto sr_db.world_cup_summaryvalues('1986','Mexico','Argentina','Germany','France','Belgium',132,24,52,2394031,'America','America');insertinto sr_db.world_cup_summaryvalues('1990','Italy','Germany','Argentina','Italy','England',115,24,52,2516215,'Europe','Europe');insertinto sr_db.world_cup_summaryvalues('1998','France','France','Brazil','Croatia','Netherlands',171,32,64,2785100,'Europe','Europe');insertinto sr_db.world_cup_summaryvalues('2002','Korea/Japan','Brazil','Germany','Turkey','Korea Republic',161,32,64,2705197,'Asia','America');insertinto sr_db.world_cup_summaryvalues('2006','Germany','Italy','France','Germany','Portugal',147,32,64,3359439,'Europe','Europe');insertinto sr_db.world_cup_summaryvalues('2014','Brazil','Germany','Argentina','Netherlands','Brazil',171,32,64,3386810,'America','Europe');insertinto sr_db.world_cup_summaryvalues('1930','Uruguay','Uruguay','Argentina','USA','Yugoslavia',70,13,18,590549,'America','America');insertinto sr_db.world_cup_summaryvalues('1934','Italy','Italy','Czechoslovakia','Germany','Austria',70,16,17,363000,'Europe','Europe');insertinto sr_db.world_cup_summaryvalues('1950','Brazil','Uruguay','Brazil','Sweden','Spain',88,13,22,1045246,'America','America');insertinto sr_db.world_cup_summaryvalues('1954','Switzerland','Germany','Hungary','Austria','Uruguay',140,16,26,768607,'Europe','Europe');insertinto sr_db.world_cup_summaryvalues('1966','England','England','Germany','Portugal','Soviet Union',89,16,32,1563135,'Europe','Europe');insertinto sr_db.world_cup_summaryvalues('1970','Mexico','Brazil','Italy','Germany','Uruguay',95,16,32,1603975,'America','America');insertinto sr_db.world_cup_summaryvalues('1982','Spain','Italy','Germany','Poland','France',146,24,52,2109723,'Europe','Europe');insertinto sr_db.world_cup_summaryvalues('1994','USA','Brazil','Italy','Sweden','Bulgaria',141,24,52,3587538,'America','America');insertinto sr_db.world_cup_summaryvalues('2010','South Africa','Spain','Netherlands','Germany','Uruguay',145,32,64,3178856,'Africa','Europe');
- 单击上方的运行。
OLAP 分析数据
- 分析国家的夺冠次数的前5名,单击上方的运行,查看展示结果。
select Winner ,count('Winner') as Winner_count from sr_db.world_cup_summary group by Winner order by Winner_count desc limit 5;

- 分析东道主进入半决赛(4强)概率,单击上方的运行,查看展示结果。
select '进半决赛' as '主办方进半决赛圈', count(1) as count from (select year ,HostCountry, Winner , Second,Third,Fourth from sr_db.world_cup_summary where Winner=HostCountry or Second=HostCountry or Third=HostCountry or Fourth=HostCountry) a
union
select '没进半决赛' as '主办方进半决赛圈', count(1) as count  from (select year ,HostCountry, Winner , Second,Third,Fourth from sr_db.world_cup_summary where Winner!=HostCountry and Second!=HostCountry and Third!=HostCountry and Fourth!=HostCountry) b;

- 分析东道主进入决赛概率,单击上方的运行,查看展示结果。
select '进决赛' as '主办方进决赛圈', count(1) as '历史次数'   from (select year ,HostCountry, Winner , Second,Third,Fourth from sr_db.world_cup_summary where Winner=HostCountry or Second=HostCountry ) a
union
select '没进决赛' as '主办方进决赛圈', count(1) as '历史次数' from (select year ,HostCountry, Winner , Second,Third,Fourth from sr_db.world_cup_summary where Winner!=HostCountry and Second!=HostCountry ) b;

- 分析东道主夺得世界杯冠军的概率,单击上方的运行,查看展示结果。
select '夺得冠军' as 'host_top', count(1) as count  ,'夺得冠军' as 'color' from (select year ,HostCountry, Winner , Second,Third,Fourth from sr_db.world_cup_summary where Winner=HostCountry  ) a
 union
 select '没夺冠军' as 'host_top', count(1) as count,'没夺冠军' as 'color' from (select year ,HostCountry, Winner , Second,Third,Fourth from sr_db.world_cup_summary where Winner!=HostCountry  ) b;

完成
通过简单的数据实时分析示例,您已完成了创建StarRocks实例,并使用StarRocks进行数据查询,帮助您快速体验EMR Serverless StarRocks。
- EMR Serverless StarRocks 5000CU*H 计算资源,48000GB*H存储资源免费试用,前往试用>>
- EMR Serverless StarRocks 钉钉交流群:24010016636