一、预计算与Hologres的关系

作为一个查询加速团队,我们的愿景是致力于打造低成本、高性能的普惠查询加速引擎,能够支持 A+流量分析、生意参谋、黄金策、友盟、 FBI/QBI等具有海量数据交互分析的产品。在成本可控情况下,使用AQP、FastMap 预计算等技术,大幅提升海量数据的查询性能,将响应时间降低至秒级或毫秒级。
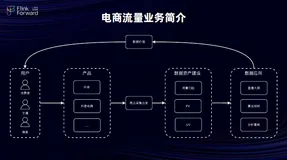
上图最上层的数据产品侧支持了比如A+采集流量分析平台、黄金策(阿里内部对于精细化人群的运营平台)、圈人(对人群特征的分析)、生意参谋(对商家和店铺商业型数据的分析产品)、FBI/QBI(阿里内部 BI 产品与云上 BI 产品)以及友盟数据分析平台。中间层为加速层,底下的存储、计算都由Hologres实现。

预计算往上即为OLAP 在线分析处理。 而OLAP 按引擎大致可以分为两类:关系模型——没有数据冗余和预处理机制,比较适合大数据量分析比如 Spark、 Presto 等;多维模型——提前按照维度与度量构成Cbube模型达到加速目的,比较适合超大数据量和对性能要求较高的OLAP 场景。

查询双 11 当天天猫销量最高的商品,传统的方式需要以下几个步骤:首先要将双 11 这一天的数据找出;第二步,按照数据进行商品聚合,如果数据有 10 亿条,则需要按照 10 亿聚合,查询时间根与数据量呈线性关系。
而如果可以按照时间和商品维度将销售量算出,则查询将不再与数据量有关。预计算的核心在于打破查询时间随着数据量呈线性增长的规律。
预计算的结果数据需要载体来存储和计算,因为预计算本身仍然是数据模型的维度。而Hologres是数据库维度,主要做数据分布、数据存储方式、索引以及查询执行计划。

预计算与Hologres是不同维度的优化,并不冲突。预计算也需要强大的运行载体做存储和计算,且它天然的Cube模型更能发挥 Hologres的作用。

从查询加速平台的角度考虑,选择Hologres有以下三个原因:
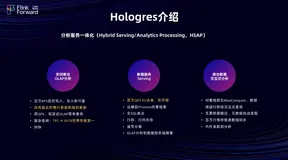
第一,算子能力。预计算中会将很多数据变成 bitmap ,因此需要强劲的 bitmap 引擎。其次, bitmap 无法解决所有问题,比如分钟内转化周期的漏斗、金额频次高基场景,但是 Hologres为其提供了特殊的解法。
第二,统一查询。分析平台不仅有自助分析,也有看板等高QPS、需要毫秒级返回的场景。我们希望可以用一套架构实现不同的分析场景。
第三,基于成本的一体化架构。Hologres提供了热存、冷存、外表等方案,帮助企业降本提效。
二、A+流量分析介绍

A+流量分析平台是阿里集团统一的全域流量分析平台,以页面、小站活动、 App 等作为切入点,经过埋点采集计算,构建出宏观概览数据,比如坑位效果、类目转化、成交路径分析、用户细分等,致力于打造流量数据分析闭环,帮助业务发现流量问题,提升流量转化。
比如想分析左下 App页面的流量情况,能够查看其 PV、UV、平均停留时长、直接引导界面、全引导 PV 指标等。
为了与预计算模型更好地结合,我们将指标转化成预计算度量形式,比如UV 相当于去重,平均停留时长相当于 abg,直接引导界面相当于四则运算。

针对流量分析领域的需求产生的分析模型分别是事件分析、留存分析、漏斗分析、转化分析、路径分析。
事件分析是流量分析解决领域最重要、最广泛的分析方法,核心为围绕事件进行多维度分析。事件指用户在产品使用过程中触发的一系列行为,原则上分为几类与比如浏览、点击、曝光。阿里集团用四段式 SPM模型,能够唯一定位到用户在哪个站点、哪个页面、哪个区块和哪个位置触发了该事件。
事件报表界面也比较简单,比如最上是浏览事件用户数,用户 UV 分组、品牌、时间等。为了与预计算结合,我们将指标与预计算模型进行对应。用户数即求去重,页面和时间即group by ,品牌过滤即筛选维度。

留存本质上有初始行为和后续行为。界面上的分析主体是登录用户或设备,定义留存时要定义两种行为,根据时间计算。而对应到预计算,登录用户对应去重指标,筛选维度对应不同行为的聚合维度等。
三、重点业务Hologres解决方案

当前,我们能够支持的数据量级为每天新增小于 1t ,分析粒度可以查询周、天、月。该背景下,产生的问题主要有以下几个:其一,性能问题,去重指标平均需要几分钟,用户体验不佳;其二,数据误差。无法满足客户对数据的精确度要求。
事件分析即对条件内的user ID 求基数,留存即对两个行为集合做交再求基数。两个集合做交并求基数很容易联想到数据结构 bitmap ,bitmap的0 或 1 分别对应人存在或不存在。其次,bitmap是由 0 与 1 组成的序列,可代表某一类条件的人的集合。
因此,可以用 bitmap 的高性能计算解决问题。但其中依然存在两个问题:第一,原始 bitmap 虽然只有 1bit,但如果有 10 亿人,数据量依然很大;第二,有了 bitmap ,还需要有存储以进行计算。
因此,我们引入了Hologres Roaring Bitmap。Roaring bitmap可以理解为带压缩的bitmap特殊结构,Hologres Roaring bitmap是分布式的Roaring bitmap实现。
在存储上, Hologres实现了 Roaring bitmap数据类型。建表时,可以建 bigint 类型,也可以建 varchar、 bitmap 类型。在单节上实现了bitmap 级别的交并差操作。此外,Hologres实现了一套基于分布式的 bitmap 执行计划,因此也有了高性能的bitmap 指引擎。

如上图所示,用颜色区别出不同维度,但是颜色内维度一致。比如黄色代表在 9 月 1 号浏览了 AB 页面的人,绿色代表在 9 月 2 号曝光了 AC 页面的人。如果将该结构变为Bitmap ,应该进行哪些操作?
首先要使 user ID 在bitmap有唯一下标,比如 1001为0,1004 为4。最后生成的 bitmap 结构如上图下方所示。同一个维度具有天然的聚合。绿色代表在 9 月2 号访问了 AC 页面的曝光。

上图为基于Hologres Roaring Bitmap的架构。
左边为云上 DataWorks,负责调度,每天调度到查询加速引擎系统。引擎内存储了元数据。maxCompute负责将业务数据变为 Bitmap 数据,导入到 Hologres,Hologres下的盘古策略拥有极快的导入性能。Hologres是 MPP 结构,需要按 bitmap 本身分组,某一段内保持自增,这也意味着人在组内的序号是永远固定的。
上图右侧为存储的逻辑视图,不同分组但维度完全一样。

假设想要查询 9 月1号所有 UV 值,首先,业务层发 SQL 到 Hologres前端节点生成执行计划。Hologres内按组分段,因此组内是并行的。 9 月 1 号有两个数据,首先是Hologres索引,将两个数据索引出来后做 rb_or_agg,将 Bitmap 做并操作,再调 rb_cardinality函数求基数,求到第一组的基数。第六组同理。所有组都为并行,且只需要merge big int 值,速度非常快。

留存的计算逻辑只需增加一步,因为需要与 2 号数据做交留存。首先,作并,然后做rb_and_cardinality操作,参数为两个 bitmap ,最后求出 count 。
改进之后的查询,几十T量级的UV类指标自助分析平均RT仅需 5s。

圈人也是Hologres Roaring Bitmap的应用场景,本质上也是 bitmap 之间的交并差,但其结果并非单个数,而是bitmap。而Hologres能够支持 SQL ,因此可以对bitmap进行insert 、select 操作,计算完成后天然地将人圈进Hologres。后续的画像本质上也是 bitmap 。
分析型场景 QPS 不高,但是阿里的生意参谋场景,有一个需求是简单的交并差,它需要进行分析,但不能做成 KV 。因此我们巧妙地利用了非 bitmap 分组,利用业务素材分组加Hologres实现了简单分析场景的1000+QPS 。
Hologres提供了实时生成 bitmap 的能力,可以将明细表导入到 Hologres。查询时实时生成 bitmap 以及进行交并差。

构建统一查询,主要源于以下几个场景的需求:
① 非加速表和预计算表异库。预计算无法解决客户 100% 的问题,只能解决痛点问题。因此,我们还需要非常快的 OLAP 引擎做支撑。
② 预计算对比宽表能更充分发挥 Hologres性能。将宽表直接置于 OLAP 引擎,如果上层查询非常自由,则分布无法确定,索引也无法确定。而预计算天然的cuboid会变成分表形式,与Hologres结合打造出更高性能。
③ 分析型场景不仅有自助分析、看板分析,高 QPS 高性等场景也希望可以通过 Hologres实现点查。
④ 预计算范畴问题。实时更新场景,比如维度表要实时更新,原维度表无法导入,则可能会出现跨库问题,因此需要在一个库里。

上图从左到右是数据的生产过程。左边是原始表,中间平台是 model cube 维度。表维度分别是城市、事件、页面和日期。如果需要求一个pv,Cuboid是 2n。Cuboid 生成后,到 Hologres逻辑结构做聚合,一个Cuboid 对应一张表,天然分开。

Cuboid天然地将维度减少了,在做分布时,可以将常用查询作为分布键。该层决定了查询时完全的分布式。第二步,利用 Hologres segment key 字段,通常为时序字段,一般会带日期,而日期决定了 shard内文件的快速搜索。然后将Cluster key 配置上高频filter索引,能够快速找到 block。最后通过bitmap columns 将非高频 filter 配置上,能够在每个块中利用 bitmap 索引快速找到数据。
以上查询在在预计算类的自助分析平台平均RT小于 1 秒, KV 类指标RT约10ms,可支撑百万QPS。

成本是企业的重点关注。作为一个查询加速平台,我们维护的表种类非常多,比如最底层的明细表、分表、抽样表等。业务系统会自己做分表,但是通用产品比如 BI 产品不会帮助业务做分表。分表也属于 OLAP 查询加速领域的需求,可能会做近实时计算进行抽样。
多种表的查询种类和使用周期不一样,与成本息息相关。Hologres提供了热存、冷存、外表等存储介质,性能依次降低,成本依次升高。可根据实际业务表的分析需求和时间周期的查询需求自由选择。
Q&A
Q:bitmap分组,假设是五百万一组,如果在第一组里的人是浏览,第二组是预付款,两组之间的人如何对应上?
A:bitmap 存储位与表的维度没有任何关系,比如在第六组第五个的人永远都是在第五个。
Q:冷数据是通过在 Hologres建外表的形式存在 MaxComputer 里吗?
A:不是。冷数据与外表的区别在于外表还是外部存储,比如存到 MC ,但是冷数据是 Hologres自己的,只不过通过OSS 实现。
Q:通过什么方式使用冷热数据?
A:直接使用。冷存数据由Hologres管理,但是存在 Hologres内部的 OSS里。热存用SSD,存储格式依然是Hologres自己内部的格式,带索引。使用方式上,有一张分区表,在分区表上定策略,可以指定保留 7 天或14 天,14 天以上的数据分区会整体转移到冷存。
Q:Hologres里什么时候建议建分区表?
A:预计算场景不需要建分区表。如果没有实现预计算,首先小数据量不建议建分区,因为小分区多会导致碎片比较多、文件比较多。另外每天固定查分区数据或整日替换等场景建议建分区。一般情况下,大于 1 亿则建议建分区。