导读
本文详细介绍了阿里云 EMR Serverless Spark AI Function 在多模态处理能力上的最佳实践。特别聚焦于自动驾驶(智驾)场景,通过真实的智驾数据预处理案例,演示了如何利用多模态 AI Function 自动识别复杂路况(如环岛)及长尾特种车辆(如警车、吊车)。该方案将传统依赖人工标注的高成本流程转化为高效的自动化 ETL 流水线,不仅实现了秒级的高分辨率图片分析,还通过结构化输出验证了其在处理非标准视觉特征时的准确性,为智驾研发中的数据闭环提供了极具价值的智能清洗引擎参考。
1. AI Function 全面拓展多模态能力
EMR Serverless Spark AI Function 通过将大模型推理能力以 SQL 函数的形式原生集成到计算引擎中,极大地降低了用户使用大模型的门槛。在最新的 esr-4.7.0 及以上版本(Spark 3.5.2)中,AI Function 全面拓展了对多模态输入的支持。主要体现在 ai_query 的多模态用法和全新的 ai_embedding_multimodal 函数上。
1.1 ai_query:图片理解的几种模式
模式一:从 DLF Blob 字段读取图片内容
适用于将图片二进制数据直接存储在表中的场景。
CREATE DATABASE ai_dataset;
CREATE TABLE ai_dataset.test_blob (
    path STRING,
    data BINARY
) TBLPROPERTIES (
    'row-tracking.enabled' = 'true',
    'data-evolution.enabled' = 'true',
    'blob-field' = 'data'
);

INSERT INTO ai_dataset.test_blob
SELECT path, content FROM read_files("oss://bucket_name/images/ccpd_1m_100/", suffix => "jpg");

SELECT path,
  ai_query(
  '请描述图片中的主要内容',
  service_name => 'qwen3.6-plus',
  data => data
  )
  FROM ai_dataset.test_blob;
模式二:路径列 + URI 读取
当图片存储在 OSS、OSS-HDFS 或其他 Hadoop 兼容文件系统中,且表中只保存路径时,通过指定 data_type => 'uri',函数将在内部按路径读取文件并进行推理。这种模式适合已有图片路径表的存量数据场景。
-- 车牌识别:从路径表批量推理
SELECT
  path,
  ai_query(
    '返回图中车牌号。IMPORTANT:只回复车牌信息;如果图片模糊无法辨认,回复''无法识别''。',
    service_name => 'qwen3.6-plus',
    data => path, -- oss://bucket/path/to/image
    data_type => 'uri',
    options => '{"enable_thinking": false}'
  ) AS plate_number
FROM (
  SELECT /*+ REPARTITION(10) */ path
  FROM ccpd_1m_1000
) t;
data => path传入的是路径列data_type => 'uri'表示函数内部按路径读取文件,支持 oss 以及 file 的方式。使用 file 的方式,需要配合 Spark 的纳管挂载功能。(如 file:///mnt/data/images/xxx.jpg)- 如 data_type => 'binary',则接受图片的 binary 内容以及 http(s)
- 分区数建议在内层子查询里通过
REPARTITIONhint 控制,而不是直接写在包含 AI 函数的外层投影上 - 如果不传
options.enable_thinking,默认就是false
模式三:read_files + 二进制读取
结合 read_files 函数,可以直接从目录批量读取图片内容,将二进制内容(BINARY 类型)作为多模态输入,无需预先建立路径表,适合新增数据的批量处理场景。
-- 直接从 OSS 目录批量读取图片并推理
SELECT
  path,
  ai_query(
    '请描述图片中的主要内容',
    service_name => 'qwen3.6-plus',
    data => content
  ) AS description
FROM read_files(
  'oss://bucket/path/to/images/',
  suffix => 'jpg,jpeg,png'
);
提示:read_files 支持 suffix 参数进行后缀过滤,过滤会下推到文件扫描阶段,避免先把目录中的其他大文件读出来,显著减少无关文件扫描和下游 AI 请求量。如需递归读取子目录,可添加 recursive => true 参数。
1.2 ai_embedding_multimodal:图片向量化
对于需要进行以图搜图、多模态检索的场景,ai_embedding_multimodal 函数可以高效地将图片转换为向量(Embedding),为后续的向量检索和相似度计算提供基础。
方式一:路径列 + URI 读取
SELECT
  path,
  ai_embedding_multimodal(
    path,
    service_name => 'tongyi-embedding-vision-plus',
    data_type => 'uri'
  ) AS embedding
FROM image_paths_table;
方式二:二进制列直接传入并把向量写入 DLF Paimon
create table embedding_result(
  path string,
  embedding array<double>)
using paimon;

insert overwrite embedding_result
SELECT
  path,
  ai_embedding_multimodal(
    content,
    service_name => 'tongyi-embedding-vision-plus'
  ) AS embedding
FROM read_files('oss://bucket/path/to/images/', suffix => 'jpg,png');
通过 ai_embedding_multimodal 生成的图片向量,可以直接写入向量数据库(如 Milvus),构建多模态检索系统,支持图文跨模态搜索等高级应用场景。
2. 支持主流模型:开放生态,灵活接入
EMR Serverless Spark 的 AI Function 不仅内置了 Qwen(通义千问)系列模型,还通过统一的模型服务注册机制,支持接入外部主流模型,包括 PAI-EAS、DeepSeek、KIMI、GLM、MiniMax 等系列,覆盖了当前市场上最主流的大模型生态。
在接入模式上,产品提供了两种核心路径,覆盖从快速验证到企业级生产的全场景需求:
- 快速验证:对接阿里云百炼(开箱即用)
对于希望快速验证业务场景、进行 PoC 验证或数据探索的团队,阿里云百炼是最高效的选择。用户无需关心模型的部署、扩缩容或 API 鉴权细节,只需在百炼控制台获取密钥,即可在 SQL 中直接调用云端大模型。这种"零代码、零运维"的体验,将 PoC 的时间从数周缩短至数小时。 - 企业级定制:对接 PAI-EAS(安全可控)
对于金融、医疗等对数据隐私极其敏感,或拥有自研微调模型的企业,PAI-EAS(模型在线服务)提供了坚实的底座。用户可以将私有模型部署在 PAI-EAS 上,并通过 VPC 内网与 EMR Serverless Spark 打通。数据无需离开安全的 VPC 环境,直接在湖仓内部完成推理,既满足了严格的合规要求,又享受了 Serverless Spark 弹性计算带来的极致性能。
模型接入列表
Serverless Spark 已内置下述模型,可以直接配合 AI Function 调用模型能力,无需额外注册:
| 模型服务名称 | 模型名称 |
|---|---|
| qwen3.6-plus | qwen3.6-plus |
| qwen3.5-plus | qwen3.5-plus |
| qwen-plus | qwen-plus |
| text-embedding-v4 | text-embedding-v4 |
| tongyi-embedding-vision-plus | tongyi-embedding-vision-plus |
4. 实践案例:智驾多模态数据的图片理解
4.1 场景背景
在自动驾驶和智能交通系统的研发与测试中,路测车每天会产生记录仪视频数据。传统的处理流程往往依赖人工标注团队对视频帧进行逐帧打标,不仅成本高昂、周期长,而且难以应对长尾场景(如罕见的特种车辆、复杂的道路结构)。
本案例需求:
某智驾团队需要快速分析一批前置摄像头(Camera Front)采集的原始图像,旨在自动识别其中是否包含以下关键要素:
- 特殊路况:环岛(Roundabout),考验感知算法对非直线车道的理解。
- 特种车辆:警车(Police Car)、皮卡车(Pickup Truck)、吊车/升降作业车(Crane/Lift Truck)。
4.2 基于 Spark AI Functions 的多模态方案
我们利用 EMR Serverless Spark 集成的 ai_query 函数,调用千问(Qwen3.6-plus)多模态大模型能力。整个流程被简化为标准的 ETL 流水线:读取 OSS 文件 -> SQL 定义 Prompt -> 调用 AI 函数 -> 输出结构化结果。
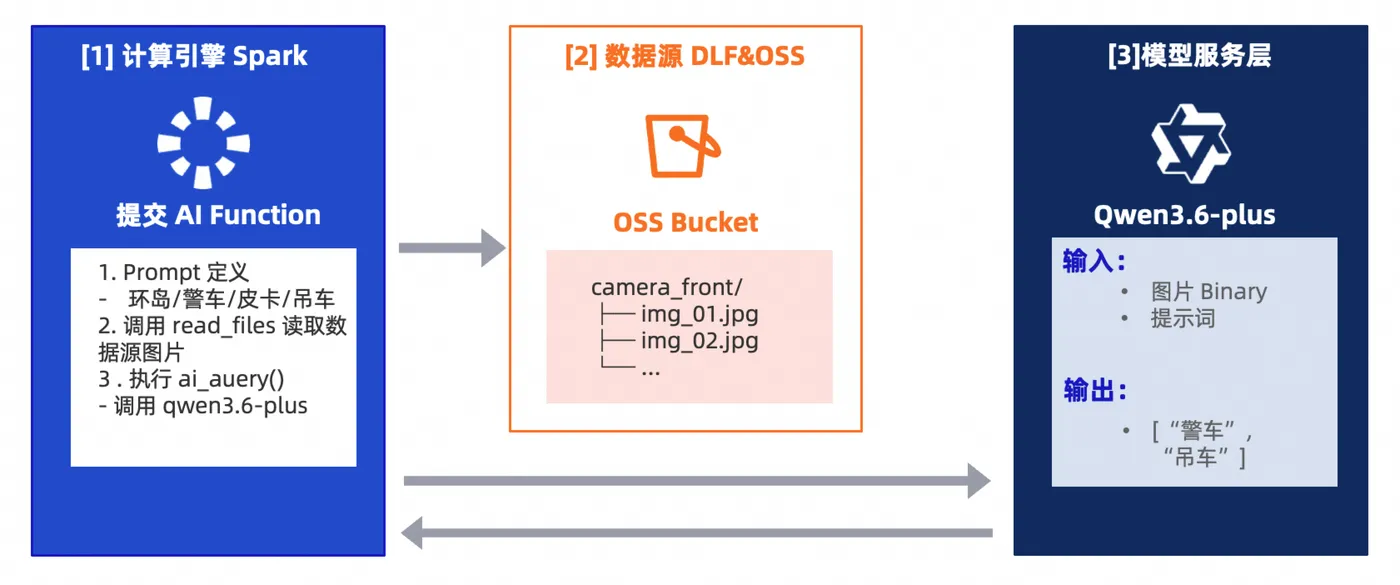
代码实现:
-- 定义包含详细视觉特征描述的 Prompt 变量
WITH vars AS (
  SELECT '''
# 请判断图片都属于下列哪类标签:环岛 | 警车 | 皮卡车 | 吊车/升降作业车 | 都不是

* 环岛
视觉特征:车辆正前方是一个圆形路口,地面或路旁有白色导向箭头。

* 警车
视觉特征:车身有明确的“公安”、“警察”、"POLICE"等字样或官方警用徽章,车身涂装为制式警车样式(如黑白、蓝白等)。

* 皮卡车
视觉特征:车头独立、后方带开放式货斗的轻型货车。

* 吊车/升降作业车
视觉特征:底盘背负巨大折叠吊臂或高耸伸缩云梯的重型特种工程车。

# 输出不要包含任何解释性文字。格式为:["标签 1", "标签 2", ...]
''' AS prompt
)

-- 执行视觉推理
SELECT
  t.path,
  ai_query(
    v.prompt,
    data => t.content,        -- 自动传入图片二进制流
    service_name => "qwen3.6-plus" -- 指定调用的多模态模型服务
  ) as result
FROM read_files('oss://baobao-wlcb/camera_front/', 'jpg,png') t
CROSS JOIN vars v;
4.3 运行效果与案例分析
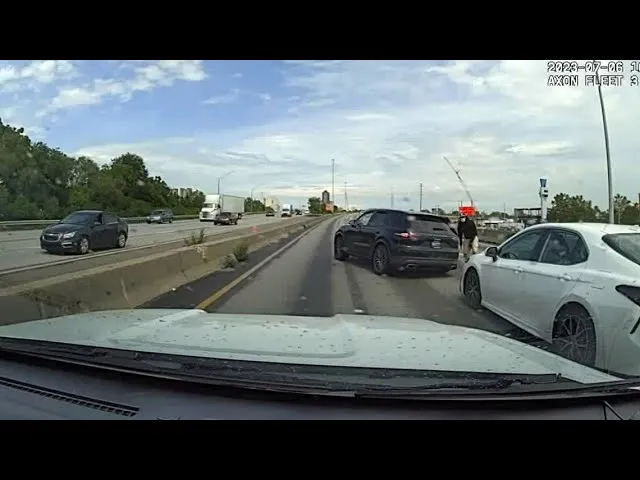
任务提交后,EMR Serverless Spark 自动弹性扩容计算资源,在数秒内完成了 5 张高分辨率智驾图片的分析。
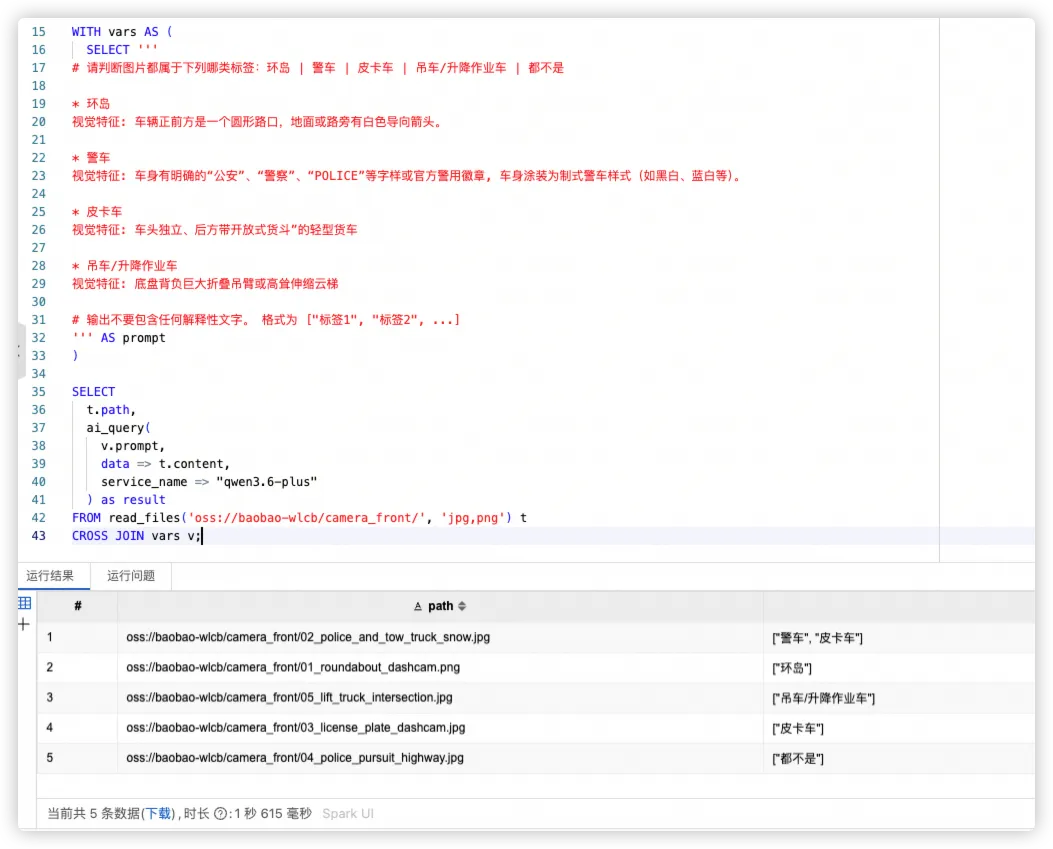
输入数据概览:
我们在 oss://baobao-wlcb/camera_front/ 目录下准备了 5 张典型测试图片,涵盖不同难度场景:
- 图1:输出标签:
["警车", "皮卡车"]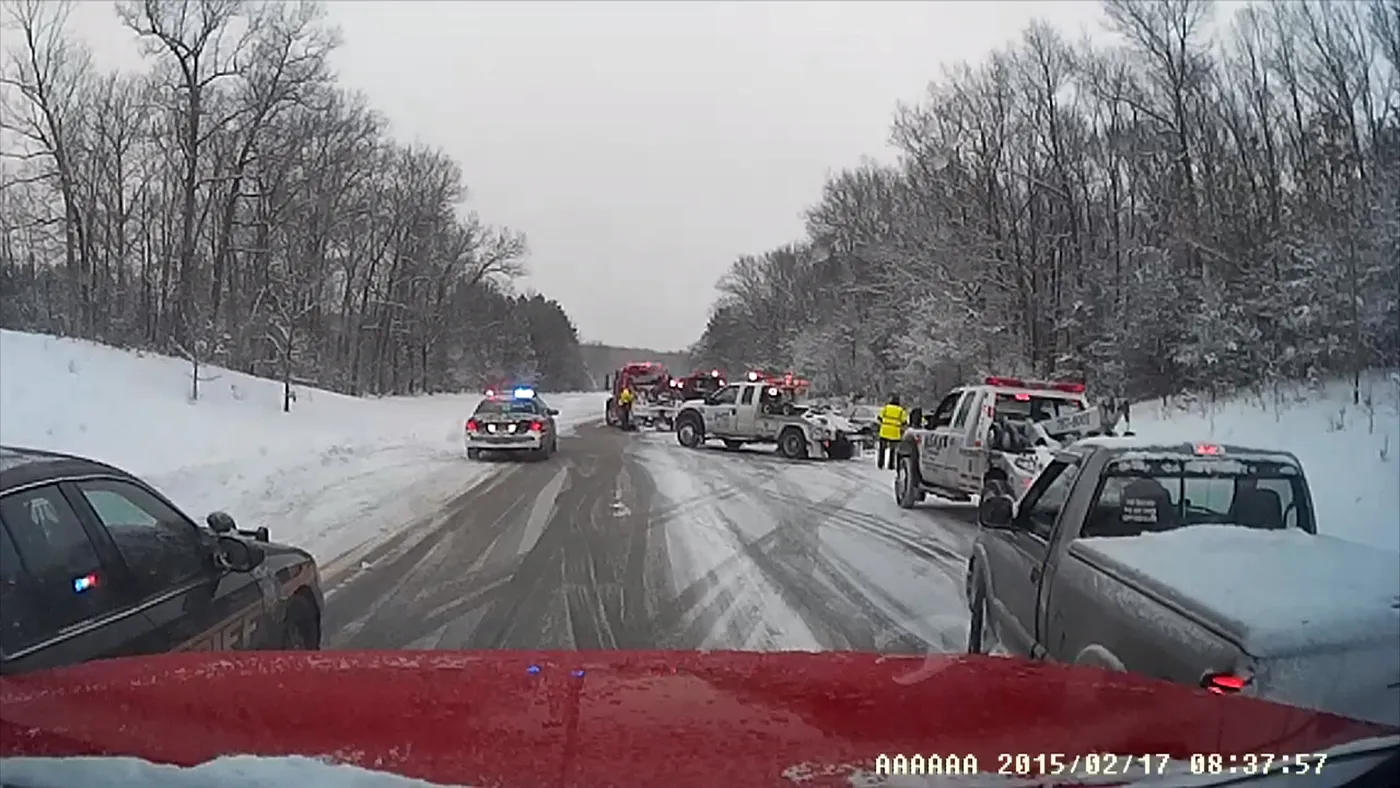
- 图2:输出标签:
["环岛"]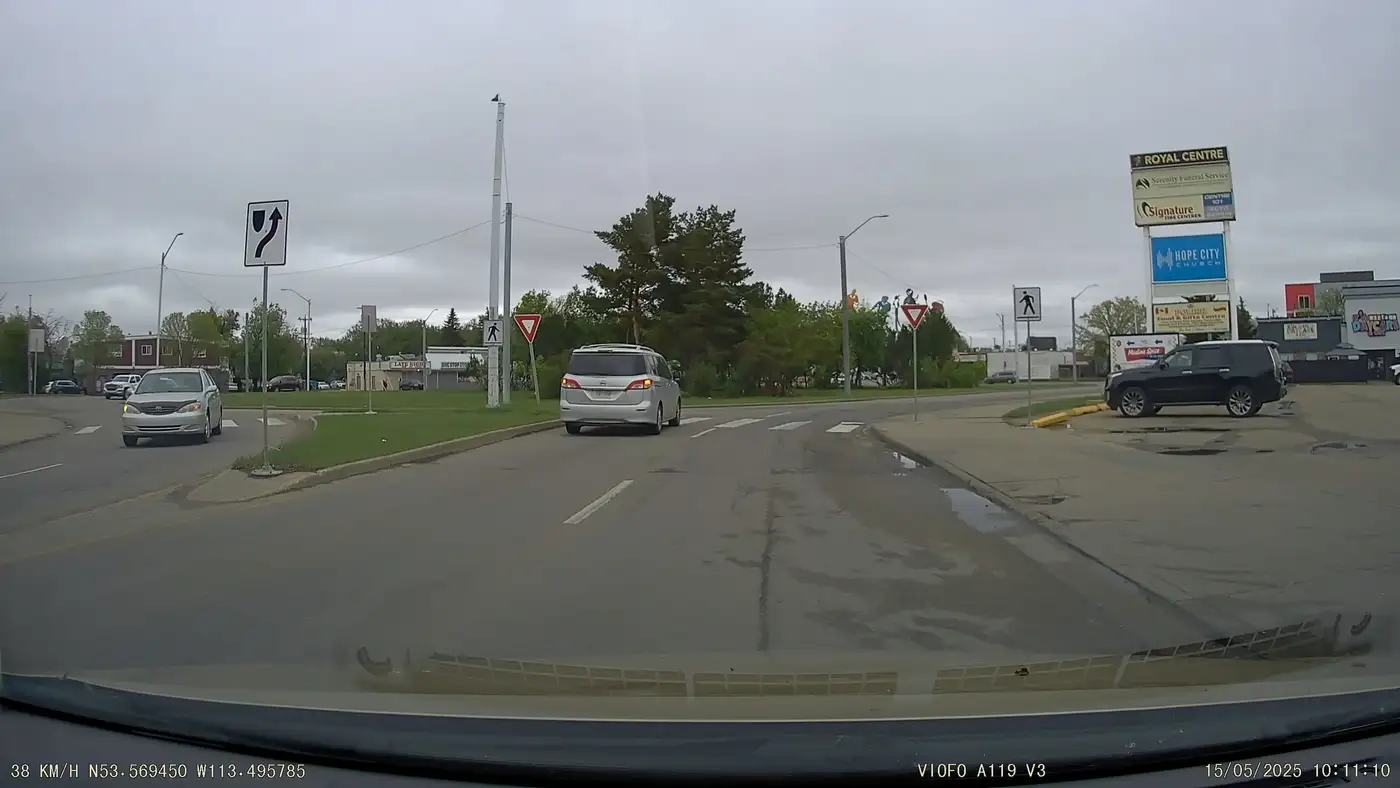
- 图3:输出标签:
["吊车/升降作业车"]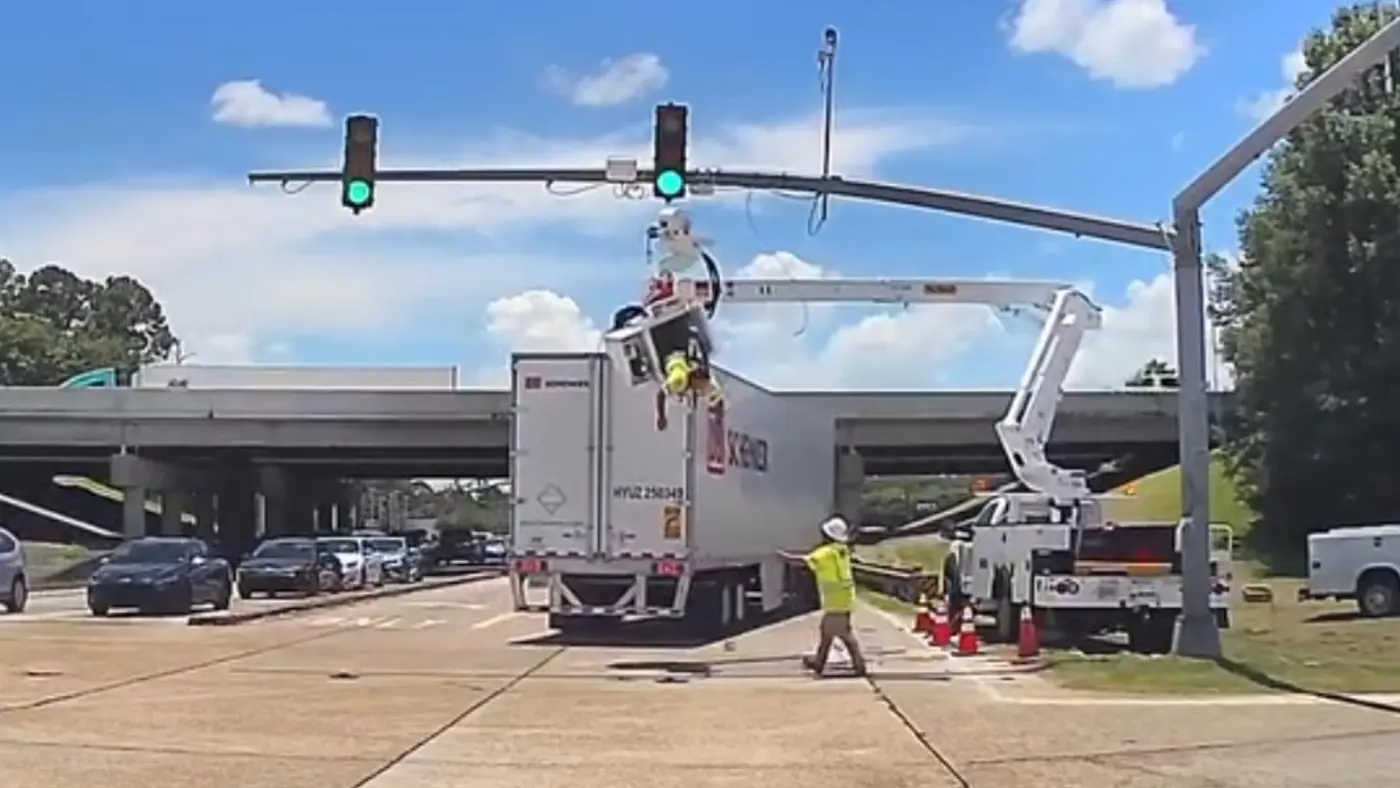
- 图4:输出标签:
["皮卡车"]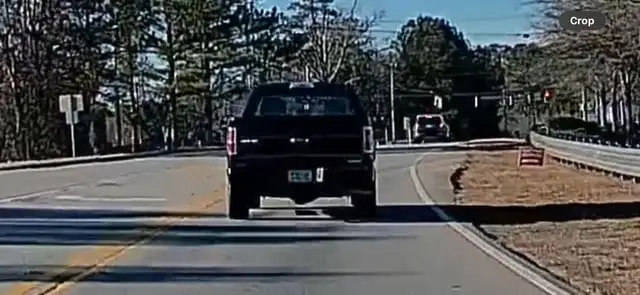
- 图5:输出标签:
[ ](对应“都不是”)
5. 总结
通过本案例,我们验证了 EMR Serverless Spark AI Functions 在智驾数据预处理领域的优势:
- 开箱即用,无需编码,效率提升数倍:从“下载数据 -> 写 Python 脚本 -> 部署环境 -> 运行推理”的数小时流程,缩减为“编写 SQL -> 提交运行”的分钟级操作。
- 高吞吐批量处理,无带宽压力:针对大规模数据集深度性能优化,吞吐量显著优于 UDF 方案,embedding 函数支持自动合并多行数据为单次 LLM 请求,显著降低延迟。
- 生产级稳定性保障:内置限流自动退避、超时重试、服务异常熔断等机制,无需用户自行处理异常场景,保障大规模数据处理任务稳定完成。
- 统一的模型服务管理:用户无需在代码中管理凭证,支持灵活切换不同模型;通过平台统一配置模型服务地址和密钥,安全合规。
- 极致的弹性成本:Serverless 架构意味着在没有任务时不产生任何费用,按实际处理的图片数量和计算时长计费,非常适合间歇性的数据处理需求。
未来,这套架构可扩展至视频级的行为分析(如“驾驶员是否疲劳”、“行人违规横穿”),成为智驾数据闭环中不可或缺的智能清洗引擎。