大家好,我是晚安code。
见过太多人把 prompt 写成许愿池:洋洋洒洒八百字,中间夹杂三句「请你一定要认真思考」,最后补一句「谢谢」。跑出来的东西格式还是错的。
问题不在态度,在结构。把提示词工程当成一门可以拆解的工程来做,事情会简单很多——五个格子填满,输出就稳了七八成。
这篇不讲玄学,只讲五要素、模板和能直接抄的代码。看完你至少能少改三遍 prompt。
一、提示词工程是什么,为什么「好好说话」不够用
提示词工程(Prompt Engineering):设计、测试、迭代大模型输入文本,让输出变得稳定可控的一套方法。你可以把它理解成给一个从没见过你的新同事派活——你觉得理所当然的事,他全不知道。
这个概念最早被当成「话术」,后来慢慢变了味:市面上流传各种「咒语」,说加某个词模型就变聪明。我试过一阵,大部分没用,少数有用的那几个,拆开看本质都是在补信息。
真正让输出稳定的是三件事:把任务说清楚、把约束说死、把示例给对。这三件事都可以复用、可以测试、可以版本管理。所谓「工程」,指的就是这个——它是可以复现的,不是靠灵感的。
2026 年 10 月这段时间,各家模型的指令跟随能力比两年前强了不少,很多老技巧的收益在下降。但下降的是技巧,不是方法。下面这五个要素,我一个都没删掉过。
二、拆开一条 Prompt:5 个核心要素
一条能稳定出活的 prompt,基本都在这五个格子里。少哪个,模型就自己编哪个。
1)角色(Role)——你是谁
告诉模型用什么身份和视角回答。写代码评审就写「Python 后端工程师」,写营销文案就写「做过三年投放的运营」。
说句不讨喜的:角色设定在现代模型上被高估了。它主要调的是语气和关注点,不是能力。「你是资深专家」不会让模型突然变强,但「你是一名只看正确性和安全问题的评审员」会显著改变它挑刺的方向。所以角色要写职责边界,别写形容词。
2)任务(Task)——做什么
动词开头,一句话说清。对比一下:「帮我看看这个代码」和「找出这段代码里的并发安全问题,并给出修复后的版本」——后者模型才知道该往哪使劲。
3)上下文(Context)——背景是什么
模型不知道你没说的事。受众是谁、已有材料是什么、这段内容会用在什么场景,都要交代。
我见过最典型的翻车:让人写「一份周报」,模型写了一份给全公司看的长篇汇报。补一句「给直属 leader 看,200 字以内,只讲进度和风险」,输出立刻对味。
4)约束(Constraints)——有什么要求
输出格式、长度、语气、不能出现的东西,全放这里。这一格是性价比最高的一格,也是新手最常漏的一格。
唯一要注意的是:约束尽量写成肯定句。「不要用专业术语」不如「用初中生能听懂的话解释」。模型对「做什么」的服从度,明显高于「不做什么」。
5)示例(Examples)——长什么样
给 2~3 个「输入 → 输出」的示范,模型照着模仿就行。少样本提示(Few-shot Prompting):在 prompt 里放几对输入输出样例,让模型模仿格式和风格。类比的话,像给新同事两份填好的表格当样板。
示例不是越多越好。三个覆盖边界的例子,胜过十个长得差不多的例子——下面第五节我会细说这个坑。
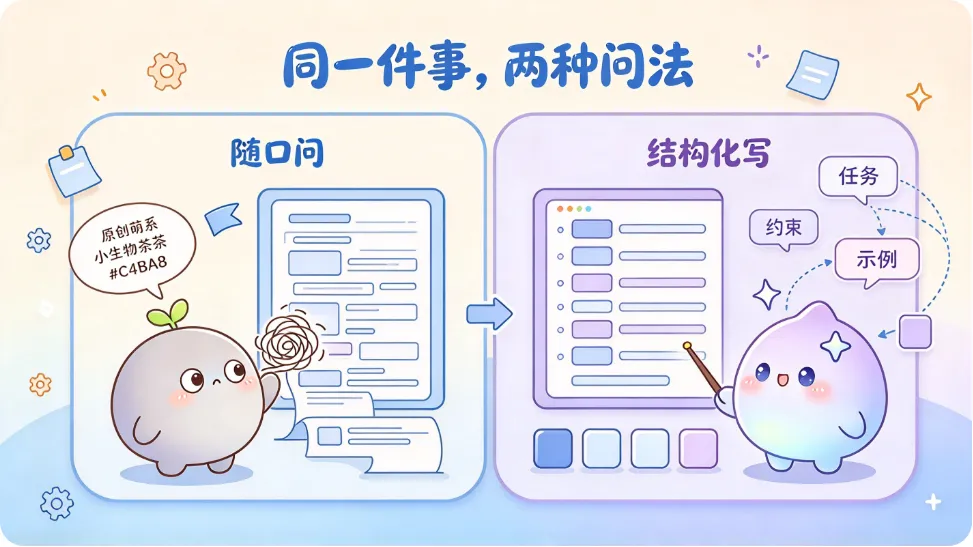
把「随口问」和「工程化写」放一起对比,差距一目了然:
| 要素 | 随口问 | 工程化写 |
|---|---|---|
| 角色 | 无 | 明确职责与视角 |
| 任务 | 一句话带过 | 动词开头,边界清晰 |
| 上下文 | 靠模型猜 | 给背景、受众、已有材料 |
| 约束 | 无 | 格式、长度、禁忌项 |
| 示例 | 无 | 2~3 个,覆盖边界 |
| 结果 | 每次都不一样 | 可复现 |
这五个要素是怎么拼成一条 prompt 的,看这张图:
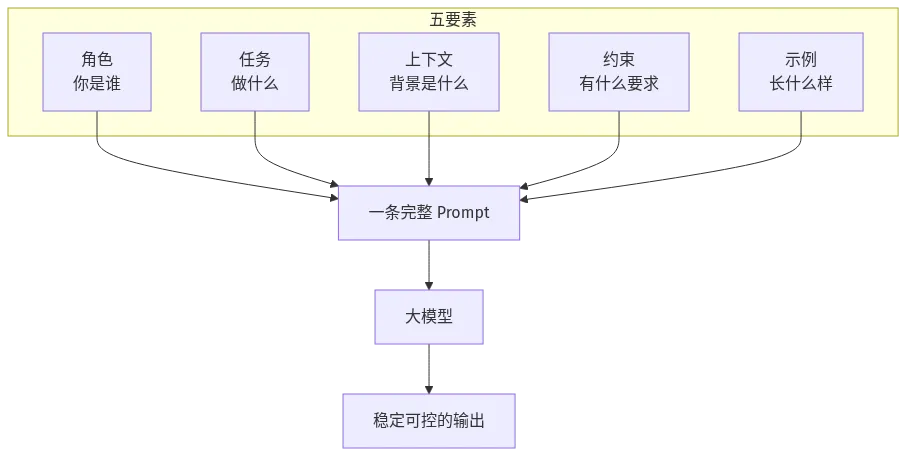
五要素里,任务和约束的收益最高;角色和示例看场景。信息不够的时候,优先补任务和约束。
这里插一句:提示词工程解决的是「说清楚」的问题,解决不了「模型不知道」的问题。 有些内容是模型压根没有的,比如你们公司内部的接口文档——那不是 prompt 能变出来的东西,得上检索。
三、从要素到模板:一套可复制的结构化写法
系统提示词(System Prompt):对话开始前设定的最高层级指令,定义模型的身份、边界和输出规范。类比成岗位说明书——写一次,管后面所有对话。
系统提示词决定下限,用户提示词决定这一次的上限。也就是说:能长期复用的规则放 system,一次性的内容放 user。
原理搞清楚了,模板可以直接抄:
【角色】
你是一名有 10 年经验的 Python 后端工程师,负责代码评审。
【任务】
找出用户提供代码里的正确性与安全问题。
【上下文】
这些代码会跑在生产环境,日均调用量百万级。
【约束】
- 输出用 Markdown,固定两节:结论、问题清单
- 每个问题给出:行号、问题描述、修复后的代码
- 不评价代码风格与命名
- 没发现问题就写「未发现阻塞性问题」,不要硬凑
【示例】
输入:for i in range(len(items)): print(items[i])
输出:未发现阻塞性问题。
【不确定时】
信息不足就直接问我,不要猜。
这个模板里,「不确定时」那一行经常被忽略,但它很值钱——没有它,模型遇到模糊需求时会硬编一个答案给你。
落到代码上,system 和 user 的分工是这样的:
from openai import OpenAI

client = OpenAI(
    base_url="https://api.deepseek.com/v1",  # 换成任意 OpenAI 兼容平台
    api_key="sk-***",                         # 别硬编码,用环境变量
)

SYSTEM = """你是一名有 10 年经验的 Python 后端工程师,负责代码评审。
规则:
1. 只报正确性与安全问题,不评价代码风格
2. 每个问题给出:行号、问题、修复后的代码
3. 没发现问题就写「未发现阻塞性问题」,不要硬凑
输出格式:## 结论 / ## 问题清单"""
下面这次调用,把一次性内容放进 user:
resp = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {
   "role": "system", "content": SYSTEM},
        {
   "role": "user", "content": f"评审这段代码:\n```python\n{code}\n```"},
    ],
    temperature=0,
)
print(resp.choices[0].message.content)
temperature=0 是评审、抽取这类任务该有的默认值——你要的是可复现,不是惊喜。
模板归模板,能不能落地还得看具体场景。下面三个是我实际用得最多的,改改就能上。
四、实战:3 个能直接抄的场景
能一次写对的 prompt 很少。 实战里八成的时间花在改,不在写。所以下面这几个我都给到了「怎么改」的方向。
1)代码审查:角色 + 约束 + 固定输出格式
上面的 SYSTEM 就是完整版,重点看两处:一是输出小节写死(## 结论 / ## 问题清单),二是明确禁止硬凑。
少了「没发现问题就直说」这句,模型会为了显得有用,把命名不规范这种事也升格成「严重问题」。评审场景下这很要命,会淹没真正的风险。
调优方向:如果发现它总在报同一类鸡毛蒜皮,别改 prompt 里的形容词,直接在约束里列出你不关心的类别。
2)信息抽取:few-shot 把格式钉死
思维链(Chain of Thought) 我们放第三条讲,这条先看示例怎么给。从客服对话里抽结构化字段:
SYSTEM = """从客服对话中抽取结构化信息。

示例 1:
输入:我想退掉上周买的那双 42 码跑鞋,订单号 A1024
输出:{"intent": "退货", "order_id": "A1024", "reason": "尺码不合适"}

示例 2:
输入:快递怎么还没到?都三天了
输出:{"intent": "催发货", "order_id": null, "reason": null}

规则:抽不到的字段一律填 null,不要编造。只输出 JSON,不要任何解释。"""
注意示例 2 是故意挑的——它演示了「字段缺失时填 null」这个边界情况。这比你再多给三个正常样例有用得多。
3)方案对比:思维链 + 任务拆解
思维链(Chain of Thought):要求模型把推理步骤写出来再给结论,而不是直接报答案。类比成让同事把账算给你看,而不是只丢一个数字。
USER = """我们是一个 3 人小团队,要在 2 个月内上线一个内部工单系统。
备选方案:A 自研、B 低代码平台、C 买 SaaS。

请按以下步骤分析,每一步都要写出来:
第 1 步:列出三个方案各自的真实成本(人力、钱、时间)
第 2 步:指出 3 人团队最容易低估的那一项成本
第 3 步:给出结论,并说明什么条件下这个结论会翻转

不要跳过任何一步。"""
关键在最后一句。你不写「不要跳过任何一步」,模型经常把中间步骤吃掉,直接给你一个看起来很自信的结论——而中间步骤恰恰是你判断它靠不靠谱的依据。
拆步骤还有个好处:哪一步跑偏了你能立刻看出来,不用对着一个错误结论猜原因。
五、5 个高频坑
提示词工程最常见的失败不是写得不够好,是写得太多。 下面这几个我都亲自踩过。
1)示例给太多,且高度重复
五个几乎一样的正例,不如两个正例加一个反例。重复示例只是在浪费上下文窗口,模型从第二个开始就没在学了。
2)示例里的格式写错了
这是我踩得最疼的一个。模型会把示例里的格式当成事实模仿——你在示例里把日期写成 2026/10/4,输出就永远是斜杠格式,哪怕约束里写着用短横线。
给示例之前,自己先当一遍校对。示例写错,等于亲手教坏它。
3)约束用否定句
「不要啰嗦」不如「每个小节不超过三句话」。「别用术语」不如「用初中生能听懂的话说」。否定句模型要绕一圈才能理解,肯定句是直接执行。
4)一次塞太多任务
一条 prompt 里同时要它总结、翻译、改格式、给建议——最后通常每样都做一半。拆成几次调用,前一次的输出喂给后一次(也就是提示词链,prompt chaining),准确率反而更高。
5)跑一次就定稿
真正的调优流程是闭环的,不是一条直线:
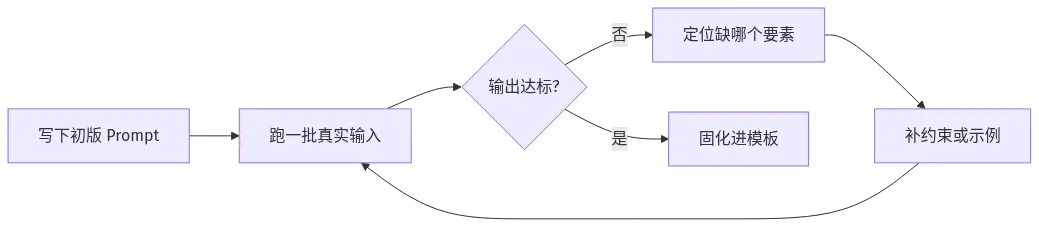
节点「定位缺哪个要素」是这里的关键——不要凭感觉改措辞,先判断是哪一格没填好。是任务没说清?还是示例不够?定位准了,改一次顶十次。
六、提示词工程的天花板在哪
提示词工程的边界很清楚:它优化的是「表达」,不是「知识」。
可能有人会问:提示词是不是写得越长越好?
不是。长度本身不产生信息量。一条 200 字但五要素齐全的 prompt,通常比 800 字堆满「请你务必认真思考」的效果好——后者只是在给模型加噪音。
可能有人会问:换个模型,之前写的 prompt 还能用吗?
基本能用,但输出格式那部分要重测。不同模型对示例的模仿强度、对 system 消息的服从度都不一样,尤其是小参数模型,约束要写得更死一点。
写到这里,就绕不开那个老问题:提示词工程和另外两条路到底怎么选。
检索增强生成(RAG):先把相关资料检索出来塞进上下文,再让模型基于这些资料回答。类比成开卷考试——模型不用记住,带着书进考场就行。
| 手段 | 解决什么 | 成本 | 什么时候用 |
|---|---|---|---|
| 提示词工程 | 表达与约束问题 | 低,改文字就行 | 默认先试这个 |
| RAG 检索增强 | 模型不知道你的私有知识 | 中,要维护知识库 | 知识频繁更新、答案要溯源 |
| 微调 | 固定风格与固定任务模式 | 高,要数据和算力 | 提示词压不下去、样本量够 |
顺序别搞反。我见过有人一上来就问要不要微调,结果九成的问题补两句约束就解决了。先用提示词把能榨的榨干,再考虑上检索,最后才是微调。
说白了,提示词工程能解决「说清楚」的问题,解决不了「模型不知道」的问题——该上检索就上检索,别指望把 prompt 写成一本说明书。
这五个要素你未必要每格都填,但输出不对劲的时候回头看一眼是哪一格空了——提示词工程里最常见的病根,八成就在那儿。
我是晚安code,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:你做提示词工程时踩过最深的坑是哪个,后来怎么填上的?