
过去两年,研发管理平台领域最热闹的讨论几乎都围绕 AI 编码工具展开:代码补全、Agent 自动修 Bug、PR 自动审查,几乎每个月都有新能力上线。研发团队确实在变快。
但有一组数据始终没有被真正认真对待。快手 AI Coding 负责人李京在 AICon 上海 2026 的演讲《从个人提效到组织生产力提升:快手 AI Coding 演进实践》(2026 年 6 月)中披露:在 10000+ 研发人员的组织里,AI 代码生成率从 0 做到 30%+,83% 的研发人员开始使用 AI 工具,个人体感提效 20%–40%,需求交付效率却没有得到相应幅度的提升。快手技术团队在 InfoQ 长文《3 年、1 万人,快手技术团队首次系统披露 AI 研发范式升级历程》(2026 年 2 月)中,也系统复盘了这一“数据悖论”。
个人快了,组织没快。这中间的落差,恰恰是传统研发管理平台最没准备好的地方。
落差从哪里来?要回答这个问题,需要先看研发管理平台当前依赖的核心度量体系出了什么问题。
一、工时数据正在失效,但很多团队没意识到
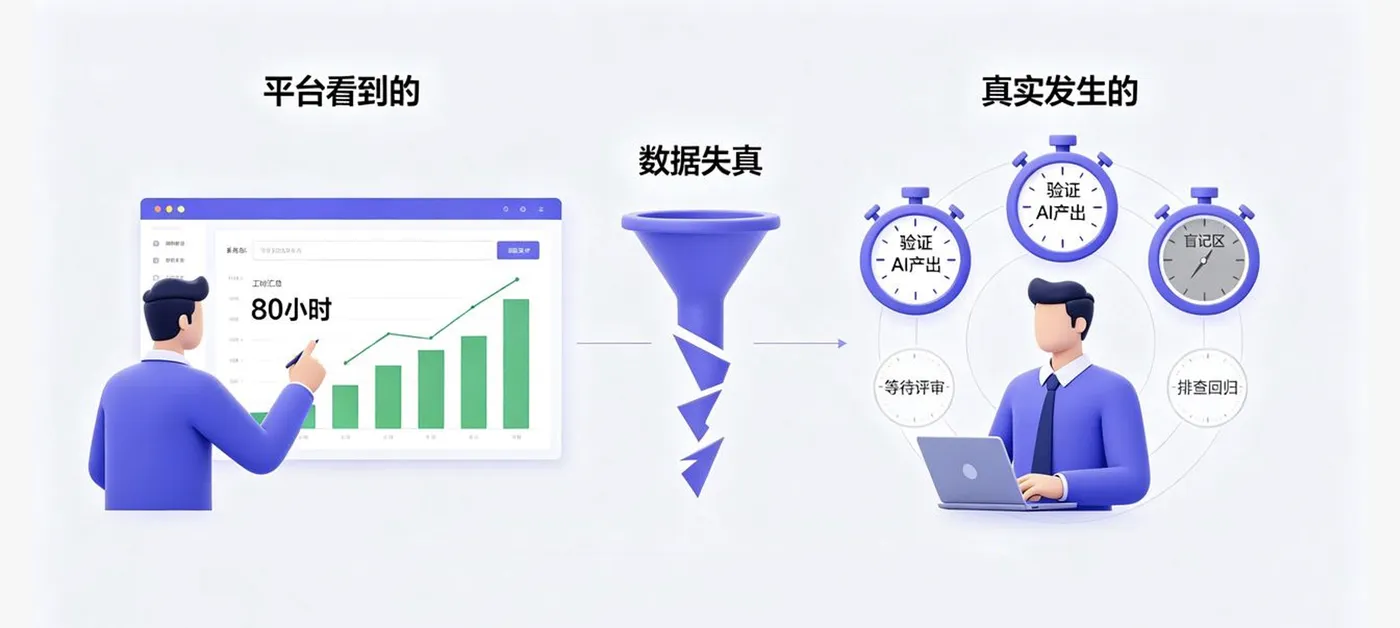 研发管理平台的核心度量单元一直是工时。需求拆解到人,人按天或小时填报,平台汇总成项目人力成本、迭代投入、资源利用率。这套逻辑运行了十几年,前提是“人的工作时间等于项目推进量”。
AI正在拆掉这个前提。
Harness《2026年工程卓越状态报告》(State of Engineering Excellence 2026)调查了美、英、法、德、印五国 700 名工程从业者与管理者:开发者每天约 31% 的时间,消耗在“与 AI 相关、但现有度量体系不追踪”的隐性工作上。按五天工作制折算,相当于每人每周约 1.5 个工作日。这些时间发生在哪里?
- 在AI生成代码和人工验证之间的等待里
- 在评审队列的拥堵里
- 在反复确认AI改动是否引入回归的排查里
这些环节消耗的是真实的人力,但传统工时填报里没有它们的位置。
同一项调查给出了更具体的数字:
94%的受访者表示技术债、验证时间和开发者疲劳没有被现有生产力指标追踪。其中,将“审查AI代码准确性”列为最大摩擦来源的受访者占比为53%,将“修复AI引入的隐性Bug”列为最大摩擦来源的受访者占比为52%。
这三个数字的口径并不相同:94% 回答的是“哪些因素未被现有指标追踪”,53% 和 52% 回答的是“AI 在哪些环节造成最大摩擦”,它们都是选择该项的受访者占比,而不是该项工作占总工时的比例。完整口径见下表。
研发管理平台看到的是“这个人这个迭代填了80小时”,看不到的是这80小时里有多少被消耗在AI产出的验证上。
数据失真已经发生,但大多数团队还在用它做决策。问题不是填报的人不认真,而是整个度量框架的假设不再成立。
数据来源与统计口径对照
| 表述 | 原始口径 | 统计性质 | 来源 |
|---|---|---|---|
| 每天31%时间(≈每周近一个工作日) | 开发者日均时间占比,团队平均值 | 时间占比 | Harness《2026年工程卓越状态报告》,700名受访者 |
| 94% | 认为技术债/验证时间/疲劳未被追踪的受访者比例 | 受访者占比 | 同上 |
| 53% | 将“审查AI代码准确性”列为最大摩擦来源的受访者比例 | 受访者占比 | 同上 |
| 52% | 将“修复AI隐性Bug”列为最大摩擦来源的受访者比例 | 受访者占比 | 同上 |
| 38% | 组织实际追踪AI代码审查时间的受访者比例 | 受访者占比 | 同上 |
补充佐证:Sonar《2026年代码开发者调查》(1,100+专业开发者)显示,96%的开发者不完全信任AI生成代码的功能正确性,但仅48%在提交前始终验证。两组数据交叉印证了同一趋势:AI产出在增加,验证负担在累积,而度量体系没有跟上。
二、三个结构性原因,让工时越填越不准
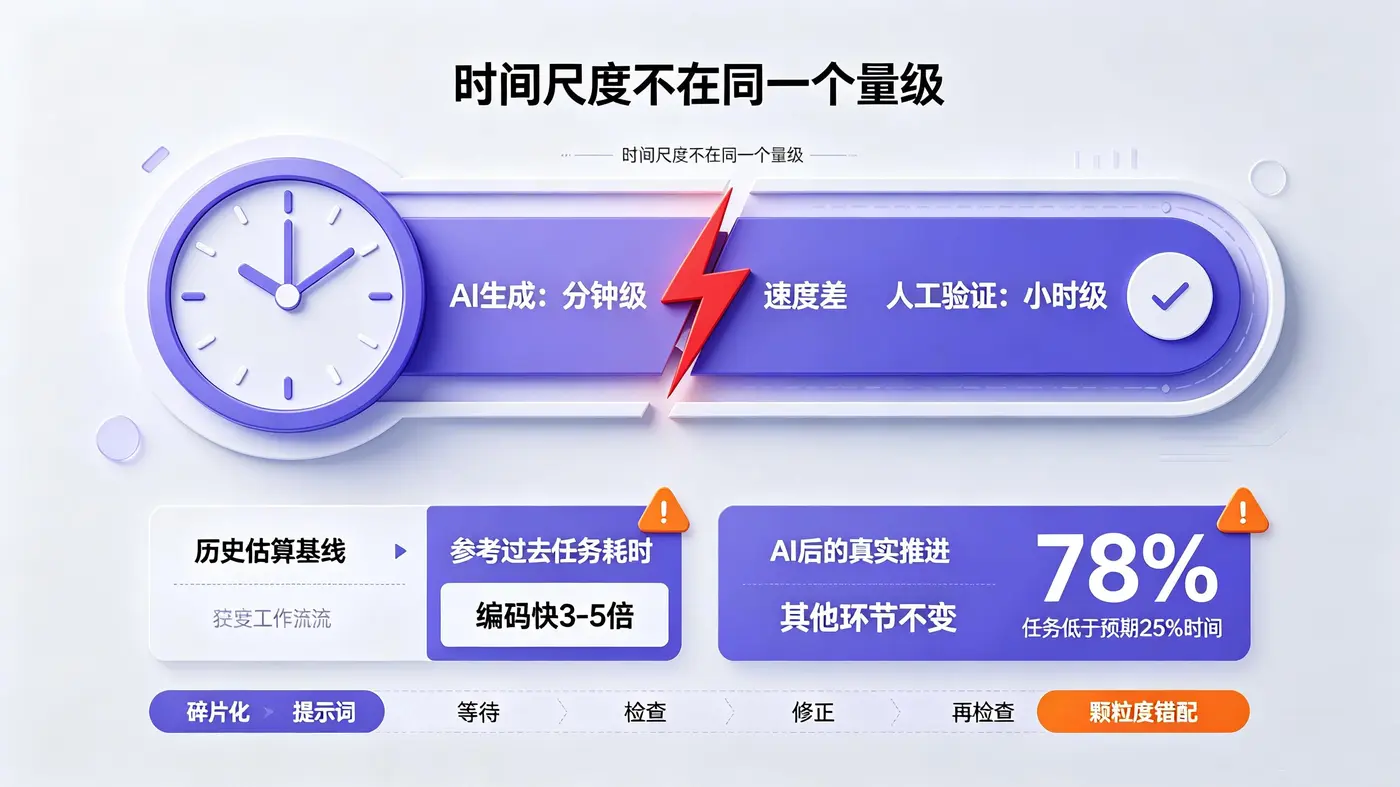 工时数据失真不是一个新问题,但AI让它从“略有偏差”变成了“系统性失效”。要理解为什么,需要看三个结构性原因。
原因一:AI的时间感知与人的计时不在一个尺度上
有研究指出,编码Agent以人类时间估算任务耗时,以机器时间执行,两者之间的差距达到一到三个数量级。
开发者让AI生成一段代码,等待几十秒到几分钟,然后花半小时到两小时验证这段代码是否真正正确。填报工时时,开发者记的是“这个任务我做了两小时”,不会去拆解其中几分钟是AI执行、多少分钟是人工验证。
但验证那部分恰恰是新的瓶颈所在。快手团队也观察到:
“AI可以在几分钟内生成代码,但验证这些代码是否正确、是否符合业务需求,往往需要几个小时甚至更长时间,AI生成和人工验证之间存在明显的速度不对称。”
原因二:估算基线已经不可用
传统工时估算依赖历史数据:类似复杂度的任务上次花几天,这次参照报数。
AI让“写新代码”提速3—5倍(BCG Platinion《The Agentic Software Factory》,2026.3),但Sprint其他环节耗时几乎没变;编码只占交付链路一小段,大量时间耗在队列与交接(Builder.io,2026.6)。GitLab 2026年调查(1,528名开发者/技术买家)显示,78%受访者认为AI后编码提交变快,但整体交付节奏未见改善;91%组织同时使用两种以上AI编码工具,仅60%认为AI编码ROI超预期。
这里要区分两个口径:78% 是“认为编码变快”的受访者占比,不等于“高复杂度任务的实际耗时降到了预期的 25%”。
更能说明问题的是 METR 2025 的一项随机对照实验:16 名资深开发者在他们熟悉的代码库中完成任务,事前预估能提速约 25%,实际耗时反而增加了 19%。样本不大,也不能直接外推到普通团队——但它指向的判断很清楚:在熟悉代码库的资深开发者身上,AI 都可能出现“预期提速、实际变慢”的反转,那么过去积累的估算基线就更没有理由继续照用。
因此,过去积累的工时估算基线,在AI深度参与的任务中已失去参照价值;管理者拿到的估算数字,与实际推进量的对应关系越来越模糊。
原因三:工时填报的颗粒度与AI工作流的节奏不匹配
传统的工时填报以“半天”或“小时”为单位,适配的是开发者连续投入一段时间的线性工作模式。
但AI参与后的工作流变得高度交错:写一段提示词、等AI输出、检查、修正提示词、再检查。这种碎片化、高频切换的工作方式,很难用传统的工时块去准确描述。
填报变成了一种事后回忆和大致估算,数据的可信度自然下降。
三个原因指向同一个结论:工时作为一个度量指标,已经无法准确反映AI参与后的实际工作流。 继续围绕它做报表和分析,产出的结论只会离真实越来越远。
三、研发管理平台需要换一套度量对象
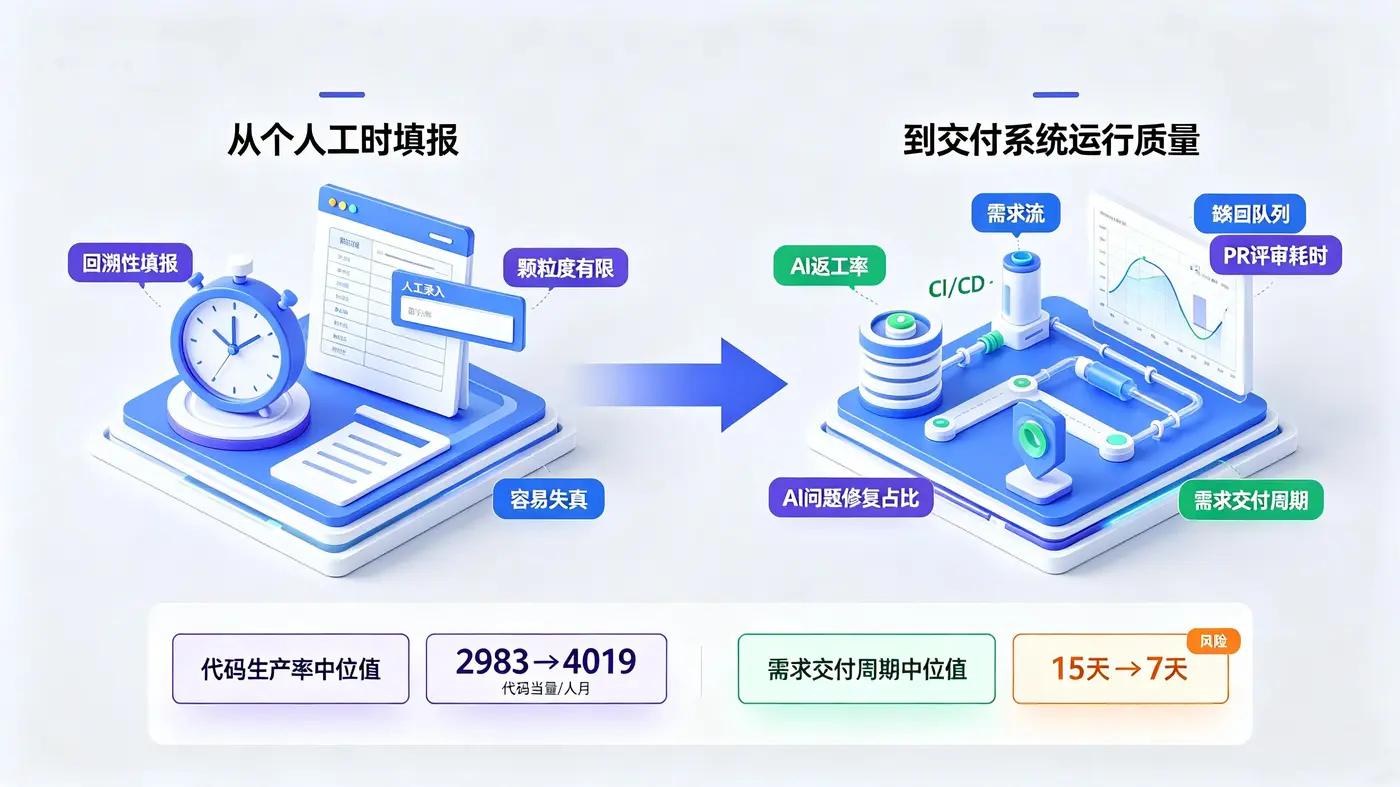 需要改变的是度量对象本身。
从“人花了多少时间”转向“工作流中哪个环节在阻塞交付”。
评估AI引入后的研发效能时,应当关注的是:
- AI生成的代码有多少比例需要人工返工?
- PR从提交到完成评审的平均耗时是否在增长?
- 同一个迭代中,用于修复AI引入问题的时间占比是多少?
这些指标的共同特点是,它们衡量的是端到端交付系统的运行质量,不依赖于个人对工时的回溯性填报。
DevData 2026 的基准报告里更值得看的,不是具体数值,而是它换了度量单位:从“人月”换成了“代码当量/人月”和“需求交付周期”。这两个单位都直接从交付结果里取,不依赖任何人的回溯性填报。
四、一体化平台在AI度量上的优势
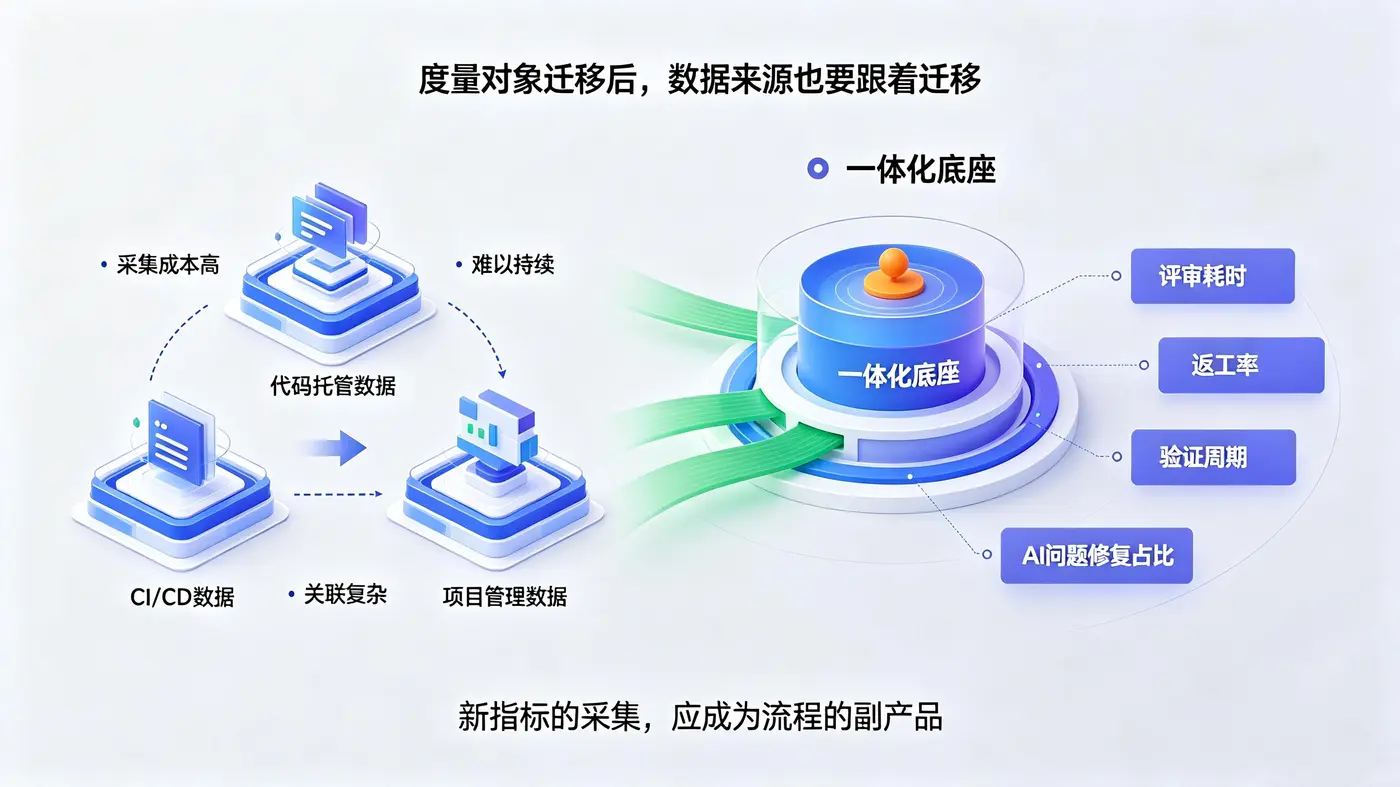 度量对象迁移到工作流之后,数据来源的问题浮了出来:评审耗时、返工率、验证周期分别落在代码托管、CI/CD 和项目管理系统里。有数据团队的可以自建采集与关联,中小团队通常没有这份人力——如果每次统计都要三个人对一周的报表,这套度量撑不过两个迭代。
这里有一条判断标准:看这些指标是不是流程的副产品。如果取数必须发生在流程运行之外,它一定会逐渐停摆;如果它天然产生在流程里,才能持续。
这也是为什么在AI编码时代,代码托管引擎与项目管理平台的集成深度变得比以往更重要。
以禅道DevOps 4.0依托的GitFox代码托管引擎为例,它将代码评审链路与禅道的需求、任务、缺陷数据放在同一底座上。GitFox的效能度量看板支持按代码库、用户、日期维度展示提交量、评审耗时、问题数等微观指标,并从这些指标定位具体的效能短板。
评审耗时这个指标的价值在于,它直接反映了AI生成代码后人工验证环节的实际负载——而这个负载,正是传统工时数据最容易遗漏的部分。
一体化底座的另一个作用是让AI辅助能力本身也成为流程的一部分。禅道DevOps后续计划承载的AI代码评审和辅助编程能力,如果与需求管理和缺陷追踪在同一平台上运行,AI产出的代码从生成、评审到修复的完整链路就有了可追溯的数据基础,度量的颗粒度不再受限于人的填报行为。
一体化平台的价值在于让新指标的采集成为流程的副产品,而不是额外的管理负担。
五、给技术管理者的行动建议
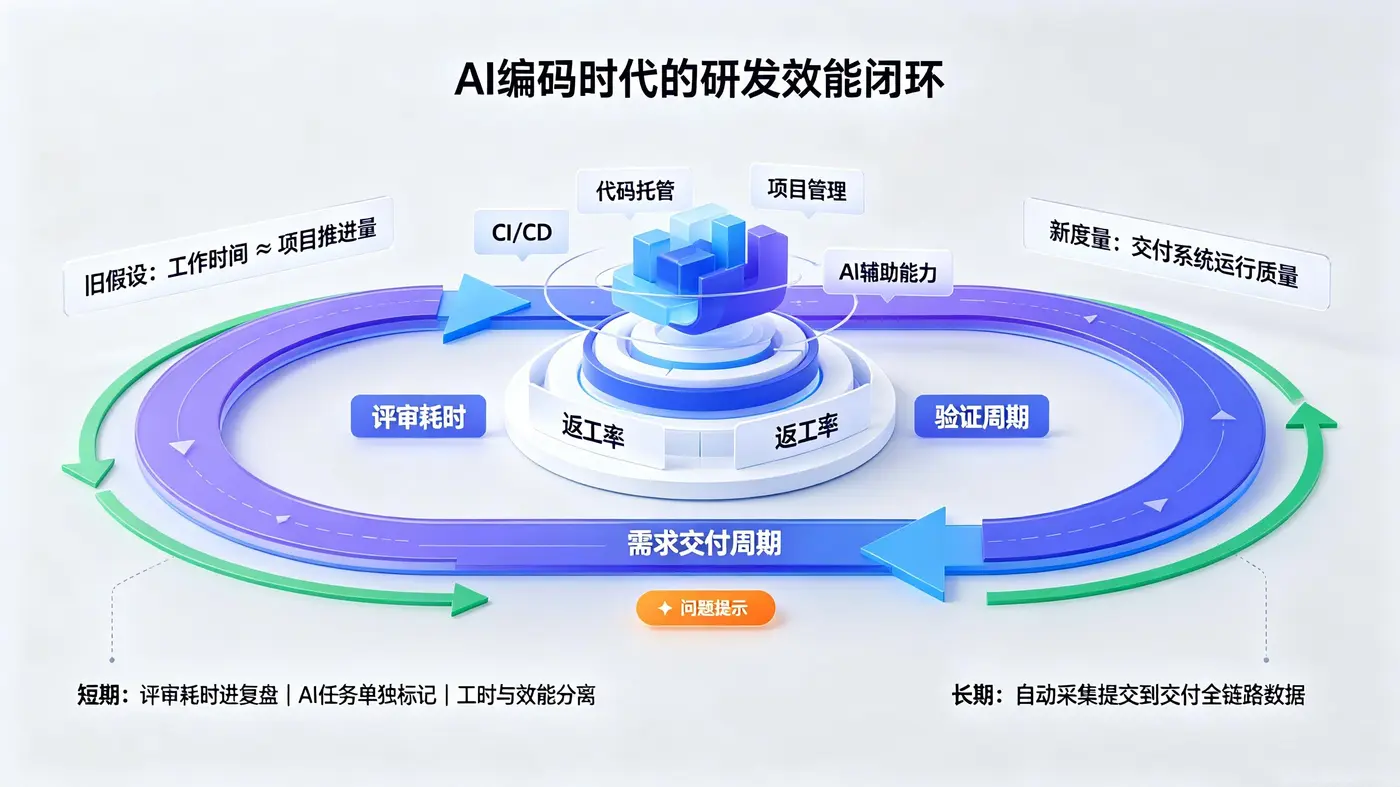 AI编码工具的普及速度远快于研发管理体系的调整速度。很多团队已经在用AI写代码,但管理方式还停留在“等人填工时”的阶段。
短期可以做的调整有三件事。
第一,把评审耗时纳入迭代复盘的核心指标
不依赖开发者填报,从代码托管平台的PR数据中自动提取。观察这个指标在AI工具上线前后的变化趋势,它会直接告诉你瓶颈转移到了哪里。
第二,对AI参与的任务做单独标记
在任务管理系统中增加一个字段,记录该任务中AI生成代码的比例区间。积累几个迭代的数据后,就能判断哪些类型的任务适合深度使用AI、哪些类型的人工验证成本过高。
第三,重新审视工时填报的意义
如果工时数据的主要用途是核算人力成本,可以保留,但不要用它来评估AI带来的效能变化。效能评估需要独立的指标集,且这个指标集应该以工作流数据为基础,而非填报数据。
更长期来看,研发管理平台的选型标准需要纳入一项新要求:它能否从代码提交到交付的完整链路中,自动采集和分析关键节点的耗时与质量数据。
在AI深度参与研发的背景下,管理平台如果只能看到“人填了什么”,看不到“系统实际发生了什么”,它提供的数据只会越来越偏离决策所需要的事实基础。
