Data Agent 上线了,为什么还不能上岗?

简介: “30 分钟上岗”意味着不仅 Data Agent 需要具备主动熟悉环境的“冷启动”能力,还需要具备越干越好、自我进化的“热加载”能力。

随着 Data Agent 逐步进入业务使用,最近在和几个客户讨论 Data Agent,能够明显感觉到,大家问的问题变了。

过去,客户最关心的是准确率。为了验证产品能力,客户会准备一批问题,让不同厂商回答,再看谁答得更准、过程更可信。这套方式很像招聘时的面试:先出几道题,看看候选人的基本能力,再决定要不要进入下一步。

现在,越来越多客户已经不满足于“面试”了,他们更直接地问:能不能先放到一个业务部门里试用一段时间?看看它是不是还像演示时那么好用?

从“面试”到“试用”,客户开始关心它能不能在真实环境中真正承担一个分析师岗位的工作。

Data Agent 的竞争,也因此开始从“面试”进入“试用”。

客户想试用,Agent 却还在等实施

Data Agent 系统上线之后,一个很现实的问题就会暴露出来: Data Agent 比一名新入职的分析师更慢开始工作。

企业招聘一名新的数据分析师,通常会给他开通账号和权限,告诉他负责哪个业务域,再给他一个数据仓库权限、几张常用报表,以及过去的需求和 SQL。如果条件好一些,还会安排一个主管或者导师,有问题可以随时问。

新分析师当然不可能第一天就理解业务,他需要先熟悉表结构、字段取值和表与表的关系,通过了解需求和 SQL 来熟悉指标口径。他一边学习,一边先接一些简单任务,比如复用一段历史 SQL 来查一个数、答疑一张报表的取值逻辑等。

换句话说,人不是学完了才开始工作,而是在工作中边干边学,完成上岗。

但企业引入 Data Agent 时,顺序往往反了过来。业务人员还没有真正开始试用,IT 和数据团队先要准备环境、开通权限、接入元数据、整理指标口径、补充语义、配置知识,再由厂商实施和调试。忙了三五个月以后,业务部门才终于可以打开产品,问第一道问题。

客户很容易产生一个朴素的判断:招一个分析师,过几天就能先做点简单的事;买一个 Data Agent,却要先做三五个月项目。既然如此,还是人更好用。

问题不在模型能力,也不完全在语义层做得好不好。更根本的问题是:我们把本来应该由 Agent 自己完成的上岗学习,搬到了 Agent 之外,变成了一项由 IT、数据团队和厂商共同完成的实施工作。

我们嘴上说交付的是“数字分析师”,实际交付方式却仍然像一个传统软件项目。

Agent 需要完成岗前准备

对传统软件来说,上线通常意味着系统已经部署完成,账号、权限、接口和页面都可以使用。至于用户能不能用好,往往留给后续培训和运营。

但 Data Agent 不一样。既然它承担的是一个岗位,就不能把“学会怎么工作”的责任全部留给使用者。产品上线,只代表它有了工位;真正上岗,还需要它知道自己负责什么、应该使用哪些数据、数据大致长什么样、常用表之间是什么关系、哪些指标和报表可以作为校准依据,以及哪些地方自己还不确定,需要在任务中边提问边校对。
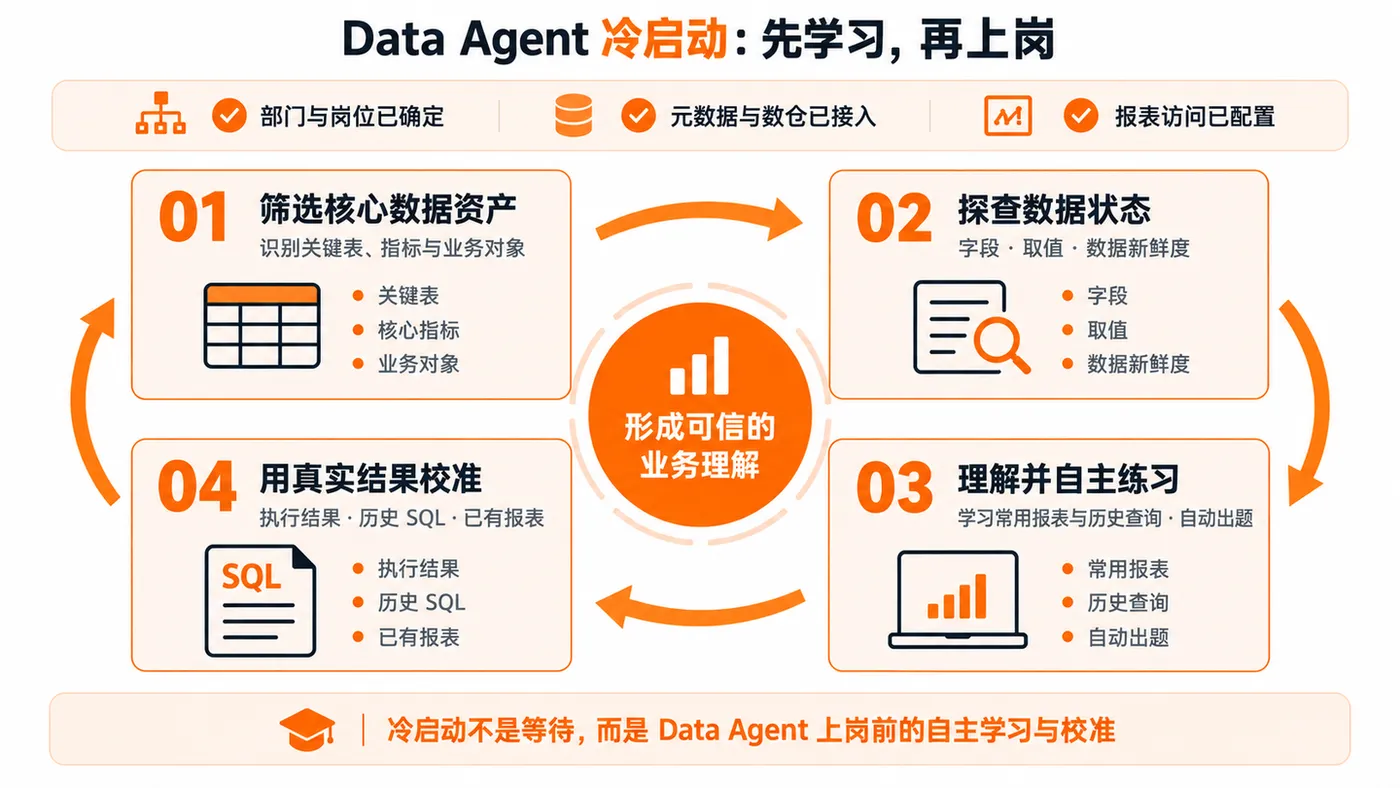
这就是我们提出“30 分钟上岗”的原因。

在部门和岗位已经确定,元数据、数仓和报表访问已经配置的前提下,Data Agent 应该先给自己一段冷启动时间。它需要自主筛选核心数据资产,探查字段、取值和数据新鲜度,理解常用报表和历史查询,自主生成练习题,再通过真实执行结果、历史 SQL 或已有报表校准自己的理解。

这 30 分钟里,是 Agent 先主动熟悉岗位环境的时间;然后,才是它开始完成第一项正式任务的开始时间。

30 分钟不是一个科学测算出来的绝对时间,它更像是一条产品约束:要把原来按月进行的 Data Agent 上岗前的准备工作,尽可能沉淀为标准化的连接、数据探查和自主学习过程。

“30 分钟上岗”意味着不仅 Data Agent 需要具备主动熟悉环境的“冷启动”能力,还需要具备越干越好、自我进化的“热加载”能力。

让 Data Agent 也走一次“试用期”考评

我建议企业评估 Data Agent 时,可以少准备几道“面试题”,多设计一次真实试岗。

先给它一个明确岗位,开放必要的数据和工具,提供一名新分析师正常会拿到的历史需求、SQL、报表和分析文档,然后先看它能不能自主完成岗位冷启动。冷启动结束以后,再给它几项日常任务,看看它的“开工”表现。

这比准备几十道题,更接近企业真正“招聘”一个 Data Agent 时需要做出的判断。

10 月 23 日,我会在 DaCon 北京站公开演讲中,进一步讨论“30 分钟上岗”这个话题, 欢迎大家找我讨论。

当下, 随着客户从“面试 Data Agent ”走向“试用 Data Agent”,一个更现实的问题已经摆在面前:

Data Agent 系统上线之后,到底还要多久,才能真正开始工作?

相关文章
|
机器学习/深度学习 算法 openCL
高效、轻量的深度学习框架MNN
MNN是一个高效、轻量的深度学习框架。
高效、轻量的深度学习框架MNN
|
SQL 人工智能 自然语言处理
AI 时代如何通过主动元数据构建高质量、可追溯的语义底座?
元数据管理将向 “数据知识图谱” 演进,成为AI原生的数据操作系统,驱动数据的自描述、自治理与自服务。
|
21天前
|
弹性计算 监控 测试技术
阿里云最便宜服务器新版测评:38元/年、99元、199元三款实例性能、限制与选购全解析
对于个人站长、编程学习者、毕业设计项目、小微企业来说,云服务器的采购成本是首要考量因素。很多新手在挑选云服务器的时候,优先寻找最低价格套餐,但是低价实例往往附带购买门槛、资源限制、续费溢价、流量约束等隐藏规则,如果没有提前了解,很容易出现第一年低价,第二年续费价格暴涨,或是业务上线之后因为资源限制出现网站卡顿、访问超时等问题。阿里云推出的38元一年、99元一年、199元一年三款特价实例,是当前入门级云服务器当中热度最高的产品,分别对应轻量应用服务器与ECS弹性云服务器,三者定位、硬件配置、网络能力、续费政策存在明显区别。本文会对这三款特价服务器做完整的横向测评,包含硬件参数、带宽实测、磁盘IO
264 0
|
2月前
|
SQL 人工智能 JSON
【数据开发】字段怎么算、改了影响谁?我做了一个能直接问 AI 的 SQL 血缘工具
Scope Lineage 是一款面向 Spark/Hive SQL 的开源字段级血缘分析工具,支持静态解析、AI 问答与自动 mapping 文档生成,精准追踪字段来源、加工逻辑及影响范围,大幅提升数仓开发与治理效率。(239字)
151 2
【数据开发】字段怎么算、改了影响谁?我做了一个能直接问 AI 的 SQL 血缘工具
|
2月前
|
数据采集 人工智能 监控
数据中台实践派:瓴羊 Dataphin 的全链路治理思路拆解
瓴羊Dataphin是阿里旗下AI原生智能数据治理平台,基于OneData方法论,以OneID/OneModel/OneService架构,实现全链路数据集成、智能建模、标准统一、资产治理与安全服务,助力企业将数据中台从“成本中心”升级为“价值引擎”。
|
2月前
|
机器学习/深度学习 人工智能 文字识别
1.2B 小模型赢过 235B 大模型:NaviDC-OCR 把文档解析卷明白了
NaviDC-OCR是中国电信AI团队推出的轻量级(1.2B)文档解析模型,专注解决手机拍摄文档的畸变、弯曲、透视等真实场景难题。它首创形变感知训练与边界点序列检测,结合内容-结构解耦学习,在OmniDocBench等四大基准全面登顶,小模型大幅超越Qwen3-VL、GPT-5.2等百B级通用大模型,为RAG与文档智能提供高鲁棒性“地基”。
|
3月前
|
数据采集 人工智能 数据管理
数据治理平台技术架构深度解析:基于DCMM 2.0的数据质量评估模型设计路径
本次选型揭示:数据质量管理非功能堆砌,而取决于标准关联、监测链路、血缘追溯与反馈闭环四大架构深度。DCMM管流程成熟度,GB/T 36344管六维指标(规范性、完整性、准确性、一致性、时效性、可访问性),平台须双轨对齐、闭环验证。
|
3月前
|
SQL 人工智能 Serverless
从数据湖到多模态湖仓-基于阿里云 EMR Serverless StarRocks 与 DLF Paimon 构建AI时代的统一分析检索架构
阿里云 EMR Serverless StarRocks 在统一数据、一致语义和系统级优化之上,构建了面向 AI Data、AI Agent 和多模态应用的下一代湖仓架构。
从数据湖到多模态湖仓-基于阿里云 EMR Serverless StarRocks 与 DLF Paimon 构建AI时代的统一分析检索架构
|
3月前
|
SQL 人工智能 安全
我们为Agent修了一条安全访问数据的路
阿里云AIDBS推出Agent数据网关,专治AI Agent越权访问、误删生产库、敏感数据泄露等安全顽疾。它在Agent与数据间构建统一安全通道,实现语义理解、执行管控、数据防护三位一体,支持分钟级接入,零改造适配主流Agent与数据源。
306 0
|
3月前
|
数据采集 人工智能 安全
大模型落地的数据治理瓶颈:从标准、质量、元数据到安全的全链路体系化建设路径
本文揭示大模型落地“翻车”的真相:非模型之过,实为数据之困。当华东区销售额出现400万偏差,根源在于多系统数据口径不一、标准缺失、质量堪忧、元数据割裂、安全缺位。AI效果的上限,由数据质量决定——Data-Centric AI不是理念选择,而是生存必需。

热门文章

最新文章