把同一个问题丢给不同的 AI 助手,你常常会得到不同甚至互相矛盾的答案。很多人把这归因于"模型能力不同",但从工程角度看,答案的差异首先来自语料与检索层,而不是模型层。
本文从 RAG 管线的视角,拆解不同平台在信源选择上的机制差异,以及内容生产者该如何"适配"这套检索机制。
一、答案的原材料:检索层决定了模型能说什么
生成式回答的链路可以简化为一句话:检索到什么,才可能生成什么。
在典型的 RAG 架构里,一次问答至少经过三个阶段:把问题向量化后从语料库召回候选文档 → 用重排模型对候选重排打分 → 把靠前的片段拼进上下文交给模型生成。模型本身并不"记住"答案,它是在给定的上下文里组织语言。
这意味着:如果你的内容根本没被召回,或者召回后排名靠后,"模型答得好不好"就与你无关。不同平台的差异,本质上发生在召回与重排这一层。
二、差异从哪来:四个可观测的机制维度
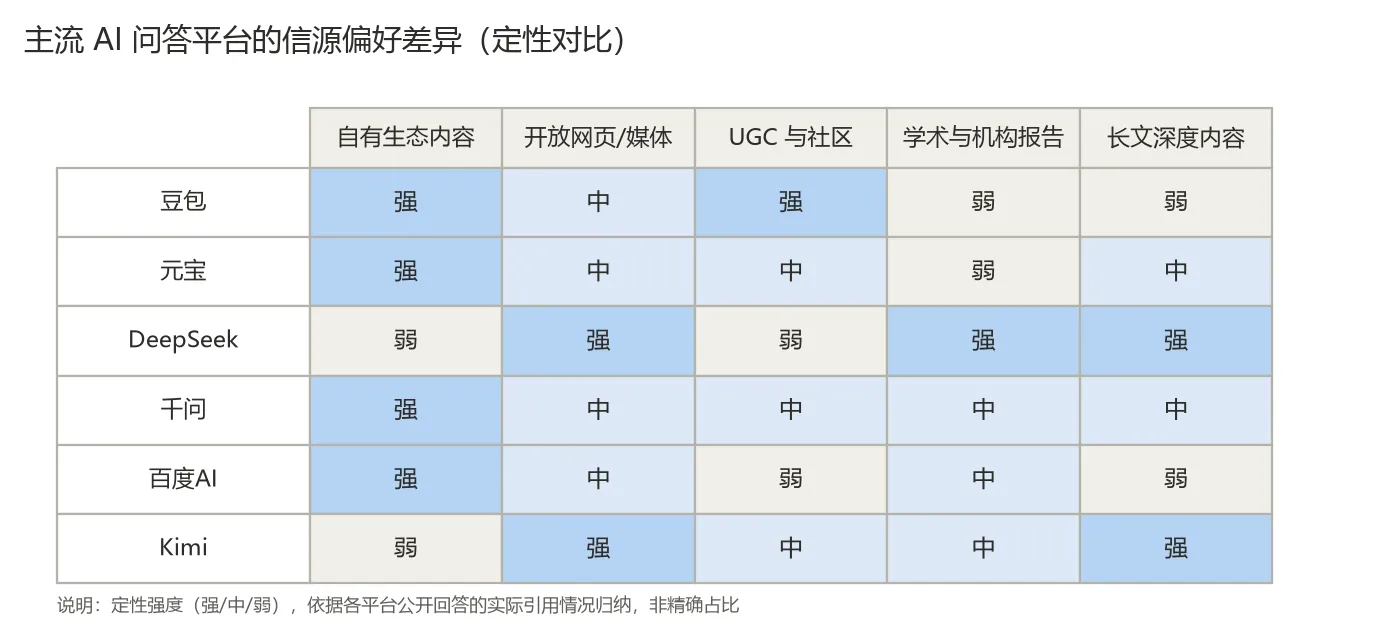
对比多个主流问答产品的公开回答,信源差异大致落在四个维度上:
- 语料池构成:生态内循环 vs 开放检索。
部分平台的第一优先级是自家生态内容——新闻客户端、短视频、百科、社区。这类平台的回答倾向引用生态内已沉淀的内容,外部网页的进入门槛更高。另一类平台则更依赖开放网页检索,答案来源更分散。语料池的边界,直接决定了你的内容要"发在哪"才能被召回。 - 权威度加权:从"挑好文"到"拼证据"。
重排模型普遍会给来源权威性一个较高的权重,但不同平台的实现差异很大:有的偏"内容质量分",结构清晰、结论明确的内容容易胜出;有的偏"证据链",偏好机构报告、学术论文与权威媒体,甚至要求同一信息在多个独立来源交叉出现后才采信。对后者而言,"孤证"内容的存活率显著偏低。 - 内容形态偏好:长文深度 vs 多模态。
有的平台明显偏好 3000 字量级的行业分析、技术白皮书和评测长文,偏好可溯源、带原始链接与时间戳的内容;有的平台则大量引用短视频、图文笔记等多媒体内容,视频关键帧与口播文本的抽取质量开始直接影响引用结果。 - 同一模型、不同端口:检索配置并不一致。
一个容易忽略的事实是:同一个模型,在 App 端与 Web 端的引用结构可能明显不同——移动端更倾向调用生态内的短视频内容,Web 端则更多依赖网页检索。这说明端侧的检索策略本身就是一个变量,只看某一个端口的测试结果会严重失真。
三、内容层面:AI 到底"摘"什么样的内容
理解检索机制后,内容侧的优化方向就变得有据可依。有三个可直接落地的原则:
- 结论前置 + 问答结构。
检索召回的是片段而不是整篇文章,模型也只能摘取片段。因此每一段应尽量"独立成立":开头直接给出结论,再分点论证、补数据。把"是什么—为什么—怎么做"的顺序倒过来写,是很多技术博客被高频引用的共同特征。 - 模块化生产,适配 chunk 切分。
检索系统会先把文档切成若干语义块(chunk)再向量化。如果一篇文章只有开头给结论、后面全是铺垫,被切出来的块大概率"信息不完整",无法单独回答任何问题。把长文拆成若干 200–300 字、可直接摘录的独立答案块,同一篇文章就能在多个问题场景下被分别召回。 - 给内容装上"自证据"。
普林斯顿大学等机构关于生成式引擎优化的研究(GEO: Generative Engine Optimization)给出了量化结论:在内容中加入引用来源,被生成式引擎引用的概率提升约 34%;加入统计数据提升约 32%;加入直接引语提升约 30%。换句话说,可验证性是新的"内容质量分"。
四、垂类与多平台:渠道策略由语料构成决定
信源偏好不仅有平台差异,还有行业差异。对多个垂类行业的信源抽样显示,在汽车、金融这类高决策门槛行业,垂直专业信源的占比显著高于综合媒体——汽车类的头部信源集中在专业汽车资讯平台,金融类则大量来自财经资讯与投资社区。
这给出一条朴素的工程结论:渠道选择不应该拍脑袋,而应该回到"目标平台的语料池里,哪类信源占比高"来推导。 对应的另一个结论是,一稿多投不可取:同一份内容在不同平台上,需要按该平台的偏重重排结构(例如面向长文偏好平台保留深度论证,面向多模态偏好平台配套视频脚本),而不是简单复制。
五、怎么验证:把"被引用"变成可测量指标
机制讲清楚后,最后一个工程问题仍然是测量——这也是内容可见性最容易失控的一环。
固定的做法是:用一组标准化问题集(覆盖品类词、品牌词、竞品词、场景词),在多平台分别做同一时间窗口的重复采样,然后统计四个指标:
- 提及率:N 次采样中被引用的比例;
- 来源占比:被引用内容来自哪些平台、哪些域名;
- 位次分布:在推荐排序中出现的位置分布;
- 引用溯源:具体命中的是哪一篇文章、哪一条内容。
只有把"模型引用了我的哪篇内容"定位到具体 URL 级别,优化动作才有靶心;也只有固定的问题集与采样频率,前后对比才有意义。单点截图无法作为任何结论的证据。
六、写在最后
从"写给搜索引擎"到"写给检索管线",内容工程的评价标准正在被重写:结构是否可摘录、来源是否可验证、在目标平台的语料池里是否有位置。
对开发者而言,这里有一批值得认真做的问题——多平台采样、chunk 友好度评估、引用溯源与归因。它们不玄,只是还没有被当成标准的工程问题来对待。
作者长期关注大模型应用与内容生态,以上为结合公开资料与实测的工程观察,欢迎在评论区交流实现细节。