大家好,我晚安code。
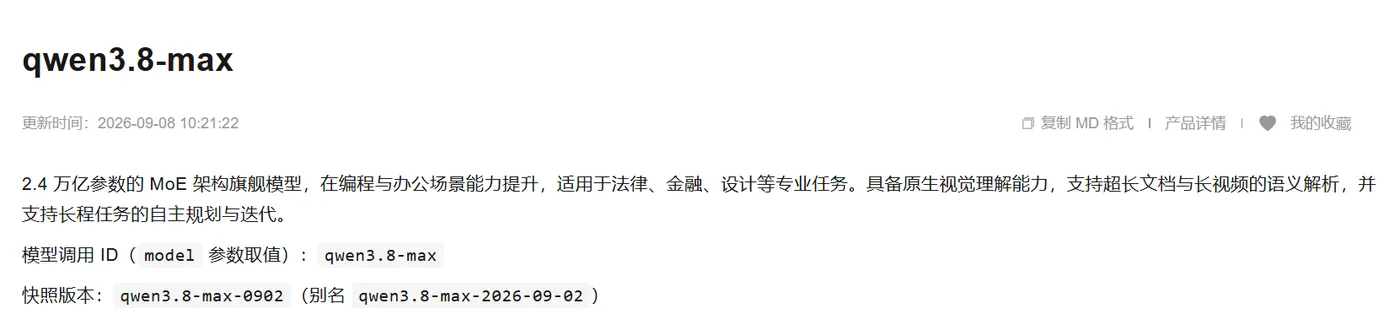
最近评论区老有人问:国产开源大模型里,到底哪个值得盯?我的答案是 Qwen3.8-Max——不是因为它刷了多少榜,而是阿里这次把「2.4 万亿总参数 + 百万上下文 + 首次开源 Max 级权重」三张牌一起甩了出来。这篇文章把它的规格、价格、开源进度一次讲清楚。
一、先对齐发布时间:8 月初官方发布
先说事实,别被各路自媒体绕晕:阿里巴巴于 2026 年 8 月 3 日官宣 Qwen3.8-Max,8 月 2 日起已在阿里云百炼等多个区域陆续上线(官方文档注明 8 月 2 日已替代 Preview 版本)。它是通义千问系列迄今参数规模最大、能力最强的旗舰模型。
为什么它值得单独写一篇?因为这是千问史上第一次把 Max 级权重拿出来开源——此前开源的都是 27B 之类的小号,Max 只走 API。这次连家底都亮出来了。
二、规格怎么读:2.4T 总参数,激活只有 950 亿
很多人一看「2.4 万亿参数」就以为要 4TB 显存才能跑,其实不是一回事。Qwen3.8-Max 是稀疏混合专家(MoE,Mixture of Experts)架构:总参数 2.4 万亿不假,但推理时只激活约 950 亿参数。你可以理解为「一个几百人的专家团,每次只按题目叫最对口的几个人上场」。
| 规格项 | Qwen3.8-Max |
|---|---|
| 架构 | 稀疏 MoE + 混合注意力(标准注意力 + 线性注意力) |
| 总参数 | 约 2.4 万亿(2.4T) |
| 激活参数 | 约 950 亿(推理时) |
| 上下文窗口 | 最大 100 万 token |
| 最大输出 | 13.1 万 token |
| 输入模态 | 文本、图像、视频(2 秒~2 小时) |
| 输出模态 | 目前仅文本 |
上下文这块国内玩家普遍 128K 起步,Qwen3.8-Max 把窗口直接推到 100 万 token,什么概念?大概能装下一整部中等篇幅的小说、几十份长文档,或者一口气喂进两小时的视频内容再让它总结。对长文档处理、法律金融这类专业场景是实打实的红利。
三、能力亮点:16 天自主编程 + 超长内容理解
规格只是参数,我更关心它干起活来什么样。官方披露的几个点比较有信息量:
- 长周期自主编程:内部测试里它自主完成了一个长达 16 天的真实软件工程项目,产出的「oh-my-cli」自进化智能体框架已开源。16 天连续推进一个项目,考验的不是单次写码能力,而是任务拆解、状态管理和跨天记忆——这正是智能体时代最缺的能力。
- 超长内容入口:能吞下超百页文档、整部电视剧、100 小时直播,转成可交互的知识库再问答。结合 100 万上下文窗口看,这条链路是通的。
- 视觉到世界的转换:官方给了不少应用侧案例,从 UI 截图重建前端、2D 户型图出 3D 效果图,到法律文书审查、金融研究都有覆盖。
四、价格:国内输入 12 元/百万 token,主打便宜大碗
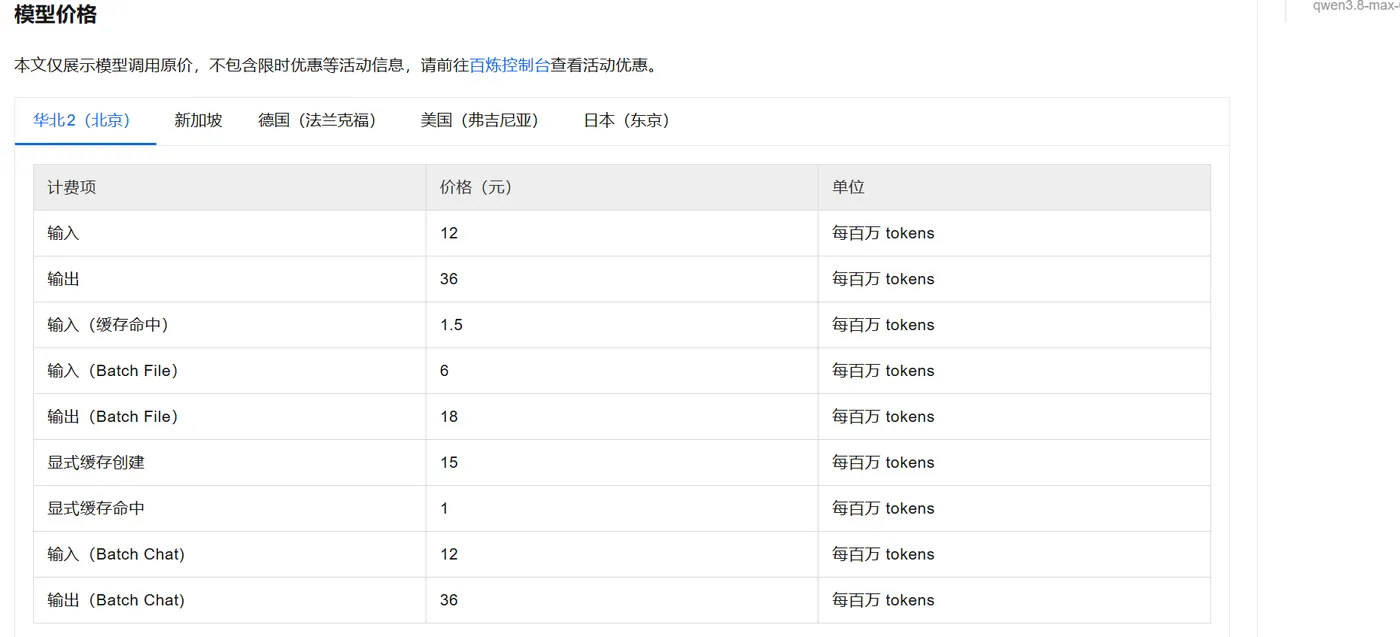
到账环节。Qwen3.8-Max 的国内定价走的是「便宜大碗」路线,输入 12 元/百万 token,跟同体量旗舰比很有竞争力。
| 计费项 | 国内价(元/百万 token) | 备注 |
|---|---|---|
| 输入 | 12 | 华北2 北京等区域 |
| 输出 | 36 | — |
| 缓存命中输入 | 1.5 | 命中缓存时 |
| 海外参考 | 约 $2 输入 / $6 输出 | 阿里云国际站口径 |
要提醒一句:真实成本看你怎么用。百万上下文的输入如果每次都全量喂,再便宜的单价也会叠起来;好在它支持上下文缓存,命中后输入单价能降到 1.5 元/百万 token,长对话、反复读同一批文档的场景一定要开缓存。
五、开源进度:Max 权重首次开源,许可条款要看清
最大变数是许可协议。 按官方计划,Max 级权重与 Qwen3.8-27B 已在 8 月中旬陆续上架开源平台。要注意两点:
- 「首次开源 Max 级权重」是实打实的里程碑,说明阿里愿意把最强的家底开放出来让人自部署、微调。
- 但部分报道指出,Max 权重可能不再沿用此前宽松的 Apache 2.0,而是换成了自定义许可,对商用有额外约定。这块官方细则和最终协议我建议以 Hugging Face / ModelScope 仓库页面的 License 声明为准——动笔时细节仍待官方进一步明确。
对绝大多数开发者,我反而更建议关注同批的 Qwen3.8-27B:稠密小模型、能跑本地,性能又不差,才是大多数人真正用得上的那个。2.4T 的全量权重,你本地大概率是喂不下的。
六、我的点评:别被 2.4T 吓到,也别被 2.4T 忽悠
说点个人判断:Qwen3.8-Max 对能用上 100 万上下文的专业场景是真香,但普通个人开发者没必要盯着 2.4T 这个数字。它真正撬动的,是「国产旗舰也愿意开源、也卷价格」这个信号——这比任何单点参数都重要。
可能有人会问:Qwen3.8-Max 现在能用吗?在哪调?
能。API 已上线阿里云百炼平台(model 参数
qwen3.8-max),国内主要区域可直连,支持 Function Calling、上下文缓存、批量推理;新用户在北京区域有 100 万 token 免费试用额度。开源权重自 8 月中旬起在 Hugging Face / ModelScope 陆续提供。
(以上规格与国内价格为阿里官方 2026 年 8 月口径;开源许可细节以 Hugging Face / ModelScope 仓库页 License 为准,海外价以阿里云国际站为准。)
我是晚安code,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:Qwen3.8-Max 的 2.4 万亿权重你打算自部署,还是更看好 27B 本地小模型?