阿里云百炼平台qwen3.7-max 大模型详解:本文系统性地介绍了该模型的定位与核心优势(Qwen3.7 系列中规模最大、综合能力最强的 Max 模型),并以模块化方式列出了模型能力(输入/输出模态、function calling、结构化输出、联网搜索、前缀续写、cache 缓存、批量推理等)、模型价格(输入 12 元/百万 tokens、输出 36 元/百万 tokens,及缓存命中、Batch File、Batch Chat 限时 5 折等优惠价格)、工具调用价格(code_interpreter、web_extractor 限时免费,web_search 4 元/千次调用)、免费额度(剩余 0%)、模型限流与上下文参数(最大输入 991K、最大输出 128K、上下文长度 1M 等),以及基于 OpenAI 兼容模式的 Python API 调用代码示例,是面向开发者的一站式模型选型与接入参考指南。
一、qwen3.7-max模型介绍
Qwen3.7 系列中规模最大、综合能力最强的 Max 模型,当前开放纯文本模型能力供体验。Qwen3.7 是面向智能体时代的新一代旗舰模型,核心优势在于智能体能力的广度与深度:在编程、办公与生产力、长周期自主执行方面均能出色胜任各项任务。该模型版本功能等同于快照模型 qwen3.7-max-2026-05-20。模型标签涵盖 Qwen3.7、深度思考、文本生成三大特性,用户可通过页面右上角的"立即体验"入口快速上手试用。
二、qwen3.7-max模型能力
qwen3.7-max 是一款纯文本模态的模型:输入模态支持文本(T),输出模态同样为文本(T)。在具体功能能力方面,该模型支持以下特性:
- 模型体验:支持,用户可在线直接体验模型效果;
- function calling(函数调用):支持,模型能够调用外部函数完成复杂任务;
- 结构化输出:支持,可按指定格式(如 JSON)规范返回结果;
- 联网搜索:支持,模型可结合实时网络信息增强回答;
- 前缀续写:支持,可基于给定前缀继续生成内容;
- cache 缓存:支持,通过缓存机制降低重复输入的成本;
- 批量推理:支持,适合离线大批量任务处理;
模型调优:不支持,该模型暂不开放微调训练能力。
overall 来看,qwen3.7-max 在智能体场景所需的工具调用、结构化交互与长文本处理方面具备完整的能力矩阵。
三、qwen3.7-max模型适用场景
根据百炼文档,Qwen3.7-Max 适用于以下场景:
- AI 编程与 Agent 开发:在长链路推理、跨文件代码理解与复杂工程任务执行方面表现突出;如需最强推理能力可选择该模型或其后续版本。
- 办公与生产力工作流:支持深度思考、文本生成及视觉理解(2026-06-08 快照版起支持图像/视频输入),可处理文档摘要、内容生成、指令跟随等通用对话场景。
- 长周期自主执行:支持 Function Calling、结构化输出、上下文缓存和联网搜索(华北2北京地域),最大上下文长度达 100 万 tokens,适合需要多步工具调用的复杂 Agent 任务。
四、qwen3.7-max模型价格
模型价格按 token 计费(可切换为千 tokens 单位查看),具体定价如下:
基础推理价格:
- 输入:12 元/每百万 tokens;
- 输出:36 元/每百万 tokens;
- 输入(缓存命中):2.4 元/每百万 tokens;
- 输入(Batch File):6 元/每百万 tokens;
- 输出(Batch File):18 元/每百万 tokens;
- 输出(Batch Chat):限时 5 折,原价 36 元/每百万 tokens;
- 显式缓存创建:15 元/每百万 tokens;
- 显式缓存命中:1.2 元/每百万 tokens;
- 输入(Batch Chat):限时 5 折,原价 12 元/每百万 tokens。
工具调用价格:
- code_interpreter(Responses API):限时免费;
- web_extractor(Responses API):限时免费;
- web_search(Responses API):4 元/千次调用。
可以看出,阿里云为批量调用(Batch)场景提供了力度较大的折扣优惠,Batch File 模式直接半价,Batch Chat 模式限时 5 折;同时缓存命中价格低至 1.2~2.4 元/每百万 tokens,配合显式缓存功能可大幅降低长上下文重复调用的成本,而代码解释器与网页抽取工具当前限时免费,进一步降低了智能体应用的开发成本。
五、qwen3.7-max免费额度
根据百炼新人免费额度规则,首次开通百炼时各模型通常会发放一定额度的新人免费 Token(仅华北2北京地域),有效期为自开通/模型发布/申请通过之日起 90 天,不同模型及快照版本的额度相互独立。详情可通过百炼平台了解:https://www.aliyun.com/product/bailian
六、qwen3.7-max模型限流与上下文
qwen3.7-max 在并发限流与上下文长度方面提供了旗舰级的规格参数:
- 最大输入长度:991K tokens;
- 最大输出长度:128K tokens;
- RPM(每分钟请求数):30000;
- TPM(每分钟 token 数):5000000;
- 最大输入长度(思考模式下):983K tokens;
- 最大输出长度(思考模式下):128K tokens;
- 上下文长度:1M(百万级 tokens);
- 最大思维链长度:256K tokens。
百万级上下文窗口配合高达 256K 的思维链长度,使模型能够处理超长文档理解、大规模代码库分析等重负载任务;而每分钟 3 万次请求、500 万 tokens 的吞吐上限,则为企业级高并发生产应用提供了充足保障。
七、qwen3.7-max模型使用API代码示例
提供了 OpenAI 兼容与 DashScope 两种接入方式,并支持一键"获取 API Key"。以下为 OpenAI 兼容模式的 Python 调用示例(支持深度思考与流式输出):
from openai import OpenAI
import os

client = OpenAI(
    # 如果没有配置环境变量,请用阿里云百炼API Key替换:api_key="sk-xxx"
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://llm-fltqd30d7x9rrh4v.cn-beijing.maas.aliyuncs.com/compatible-mode/v1",
)

messages = [{
   "role": "user", "content": "你是谁"}]
completion = client.chat.completions.create(
    model="qwen3.7-max",  # 您可以按需更换为其它深度思考模型
    messages=messages,
    extra_body={
   "enable_thinking": True},
    stream=True
)
is_answering = False  # 是否进入回复阶段
print("\n" + "=" * 20 + "思考过程" + "=" * 20)
for chunk in completion:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if hasattr(delta, "reasoning_content") and delta.reasoning_content is not None:
        if not is_answering:
            print(delta.reasoning_content, end="", flush=True)
    if hasattr(delta, "content") and delta.content:
        if not is_answering:
            print("\n" + "=" * 20 + "完整回复" + "=" * 20)
            is_answering = True
        print(delta.content, end="", flush=True)
该示例展示了如何通过 OpenAI SDK 兼容接口调用 qwen3.7-max:只需配置 DASHSCOPE_API_KEY 环境变量并指定 base_url,即可无缝迁移原有 OpenAI 代码;通过 extra_body={"enable_thinking": True} 参数可开启深度思考模式,并以流式方式分别打印模型的"思考过程"与"完整回复",便于开发者直观观察模型的推理链路,快速构建智能体应用。
八、阿里云千问qwen3.7-max大模型最新活动全解析
阿里云qwen3.7-max作为千问3.7系列中规模最大、综合能力最强的旗舰模型,当前正在开展多项限时优惠活动,覆盖按量付费折扣、夜间错峰折扣、订阅套餐优惠、满减券、免费额度等多个维度。以下是截至目前的最新活动详情:
按量付费限时5折
qwen3.7-max推理服务当前享受限时5折优惠,覆盖输入、输出、Batch Chat及显式缓存等6个计费项,折后价格如下:
| 计费项 | 原价(元/百万Token) | 5折价(元/百万Token) |
|---|---|---|
| 输入 | 12 | 6 |
| 输出 | 36 | 18 |
| 输入(Batch Chat) | 12 | 6 |
| 输出(Batch Chat) | 36 | 18 |
| 显式缓存创建 | 15 | 7.5 |
| 显式缓存命中 | 1.2 | 0.6 |
活动详情可访问:https://www.aliyun.com/benefit/scene/ai-discount
Night Plan夜间错峰优惠(低至2折)
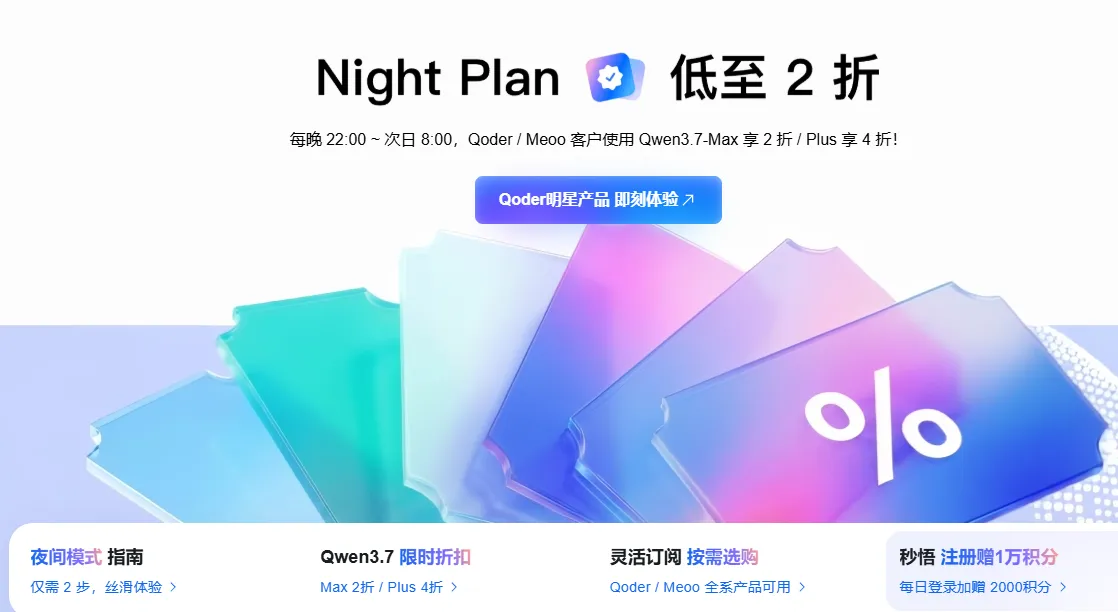
这是qwen3.7-max力度最大的优惠活动。每晚22:00至次日08:00(北京时间),Qoder和秒悟Meoo客户使用qwen3.7-max可享2折优惠,Credits消耗仅为白天的20%,最高可节省80%成本。
核心规则:
- 覆盖产品:Qoder全系(Desktop、Work CN、CLI、JetBrains插件)及秒悟Meoo网页端
- 参与门槛:Pro Trial试用用户及付费订阅用户自动生效,无需报名、不用领券
- 效果保障:折扣仅影响计费,模型推理质量、响应速度与白天完全一致
- 使用建议:白天规划需求,夜间提交长程任务,早上验收成果
需要注意的是,随着qwen3.8-max于2026年9月上线,Token Plan个人版的夜间折扣政策已有所调整。根据2026年8月发布的规则,qwen3.8-max上线后,个人版夜间5折优惠仅针对qwen3.8-max,qwen3.7-max等旧模型按标准Credits系数计费,无额外夜间折扣。不过,Qoder/Meoo客户端的夜间错峰折扣(2折)仍可能继续适用。具体最新政策建议以阿里云百炼控制台实时展示为准。活动详情可参考:https://www.aliyun.com/benefit/client/nightplan
Token Plan订阅套餐限时优惠
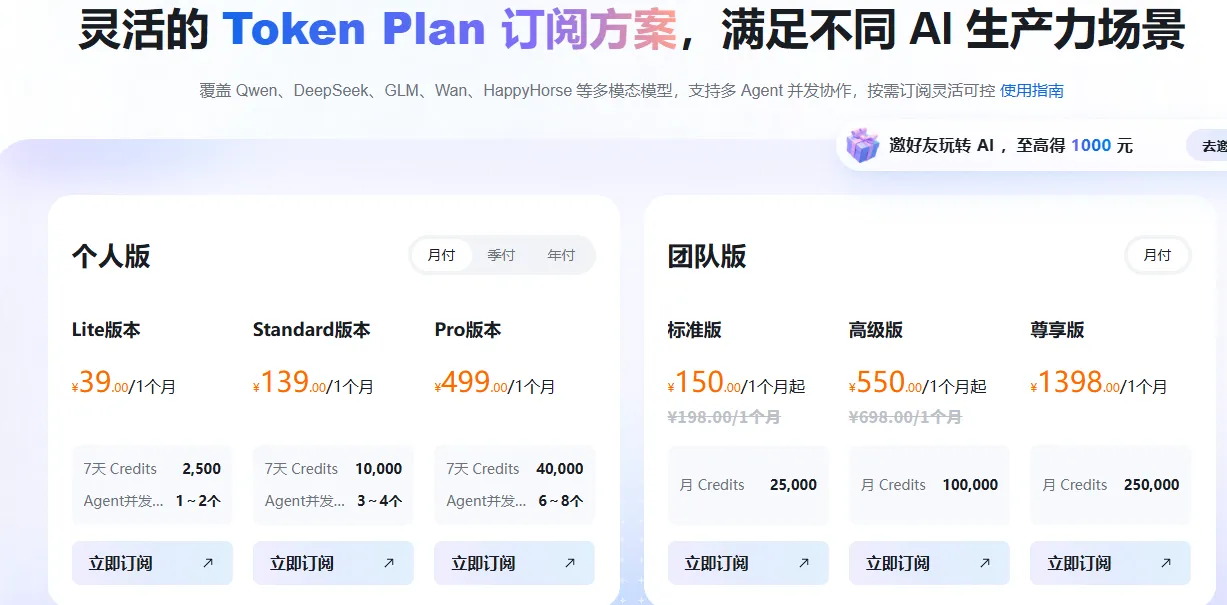
通过Token Plan订阅计划使用qwen3.7-max,成本可预测且灵活可控,限时活动价如下:
个人版:
- Lite版:39元/月(原价60元),含2500 Credits/7天
- Standard版:139元/月(原价180元),含10000 Credits/7天
- Pro版:499元/月(原价600元),含40000 Credits/7天
团队版:
- 标准坐席:150元/席位/月(原价198元),含25000 Credits/席位/月
- 高级坐席:550元/席位/月(原价698元),含100000 Credits/席位/月
- 尊享坐席:1398元/席位/月,含250000 Credits/席位/月
详情可访问阿里云百炼Token Plan服务页面:https://www.aliyun.com/benefit/scene/tokenplan
AI焕新季满减券(2026年9月30日截止)
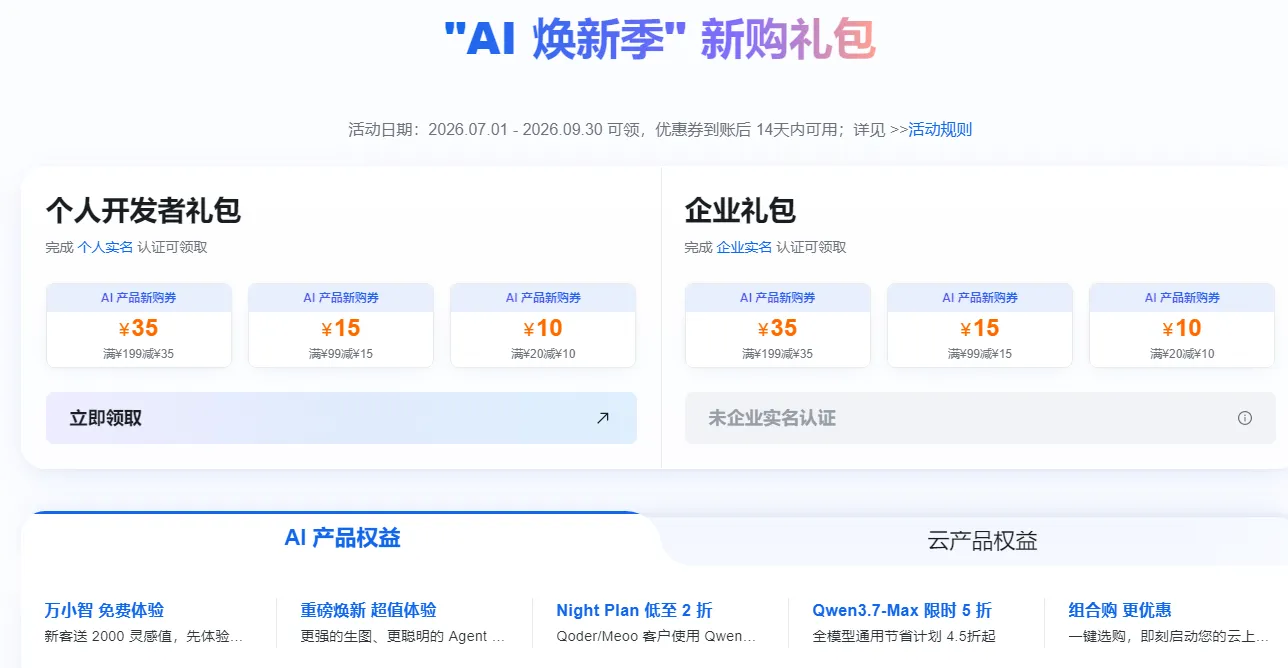
面向已完成实名认证并开通百炼平台的特邀用户,提供三档满减券:
- 满20减10
- 满99减15
- 满199减35
领取后14天内有效,仅限首次新购1年期及以内订单,支持Token Plan团队版、Qoder系列、Agent工具等产品。个人和企业用户均可免费一键领取,结算时自动抵扣。详情可参考:https://www.aliyun.com/benefit/client/cross
新用户免费额度
首次开通阿里云百炼的用户,系统自动为qwen3.7-max发放100万Token免费额度(输入、输出共用总额度),有效期90天,仅限华北2(北京)地域实时推理调用。
- 主账号与RAM子账号共享同一模型额度
- 不同模型及快照版本额度独立不互通
- 已认证用户可开启"免费额度用完即停"功能,避免意外扣费
- 额度耗尽或过期后不支持补发、延期或重置
OPC创新助力计划(先用后返)
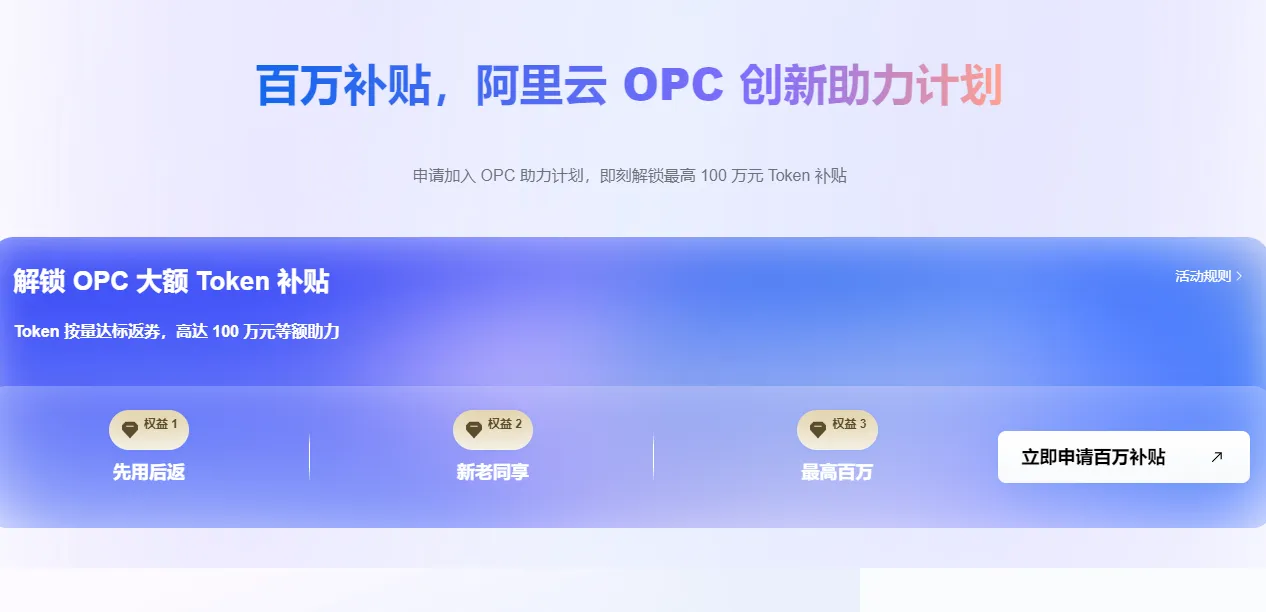
面向独立开发者、自由职业者及"一人公司",提供最低1000元、最高100万元Token补贴,采用"先用后返"模式,根据实际消费金额次月获得相应额度的满返优惠券。
申请入口:https://opc.aliyun.com/products
AI通用型节省计划
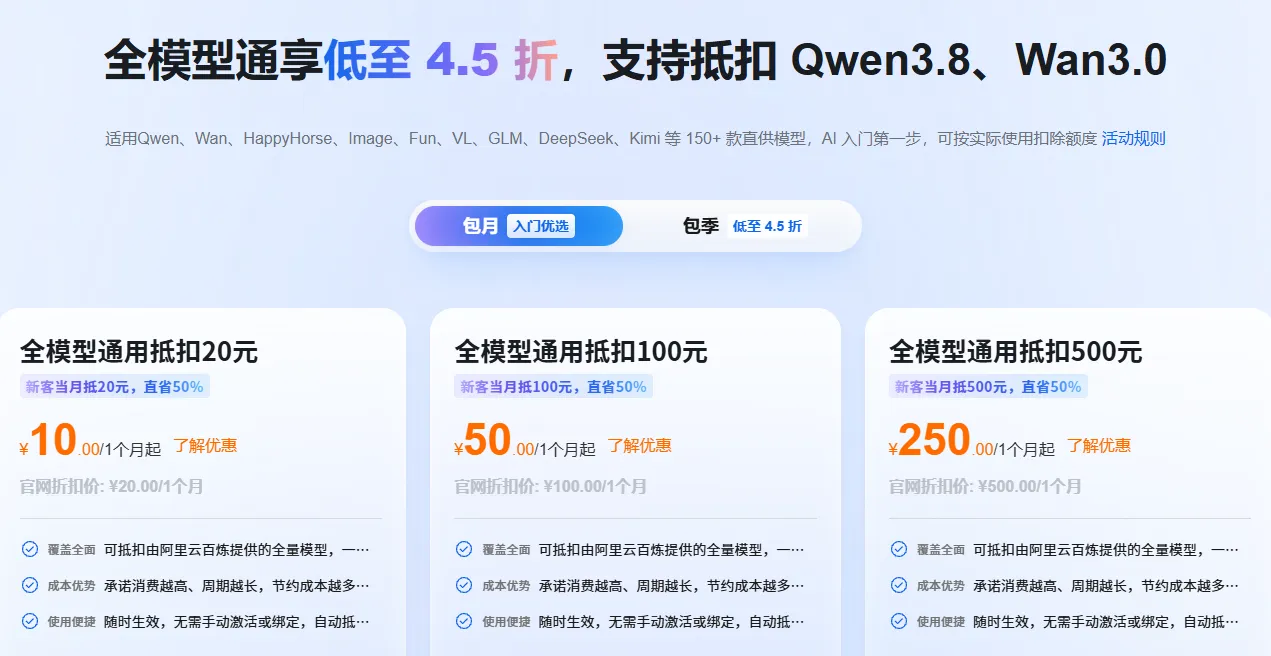
新客首月10元起,当月可抵扣20元,覆盖千问、DeepSeek、万相等全模型通兑,可与Token Plan叠加使用,进一步降低长期使用成本。
总结: qwen3.7-max 作为阿里云面向智能体时代的新一代旗舰模型,凭借 1M 超长上下文、256K 思维链、完整的工具调用与批量推理能力,以及灵活的缓存与折扣计费体系,为编程、办公生产力和长周期自主执行等场景提供了强大支撑,开发者可通过 OpenAI 兼容接口极低门槛地接入使用。