
在智能体技术快速迭代的行业背景之下,大模型的价值已经不再局限于问答对话、文本创作等基础任务。市场迫切需要可以自主拆解复杂目标、多轮调用外部工具、长时间持续迭代完成完整项目的基座模型。Qwen3.7‑Max作为通义千问序列定位最高的旗舰基座模型,正是面向智能体工作负载打造,拓展了大模型在编程开发、长文档深度分析、办公自动化、复杂逻辑推理、自主任务执行等场景的能力上限,兼顾普通用户日常使用、专业从业者生产力提升以及企业级业务系统二次开发,无论是网页端直接交互,还是通过API集成至自有业务系统,都可以释放强大的实用价值。
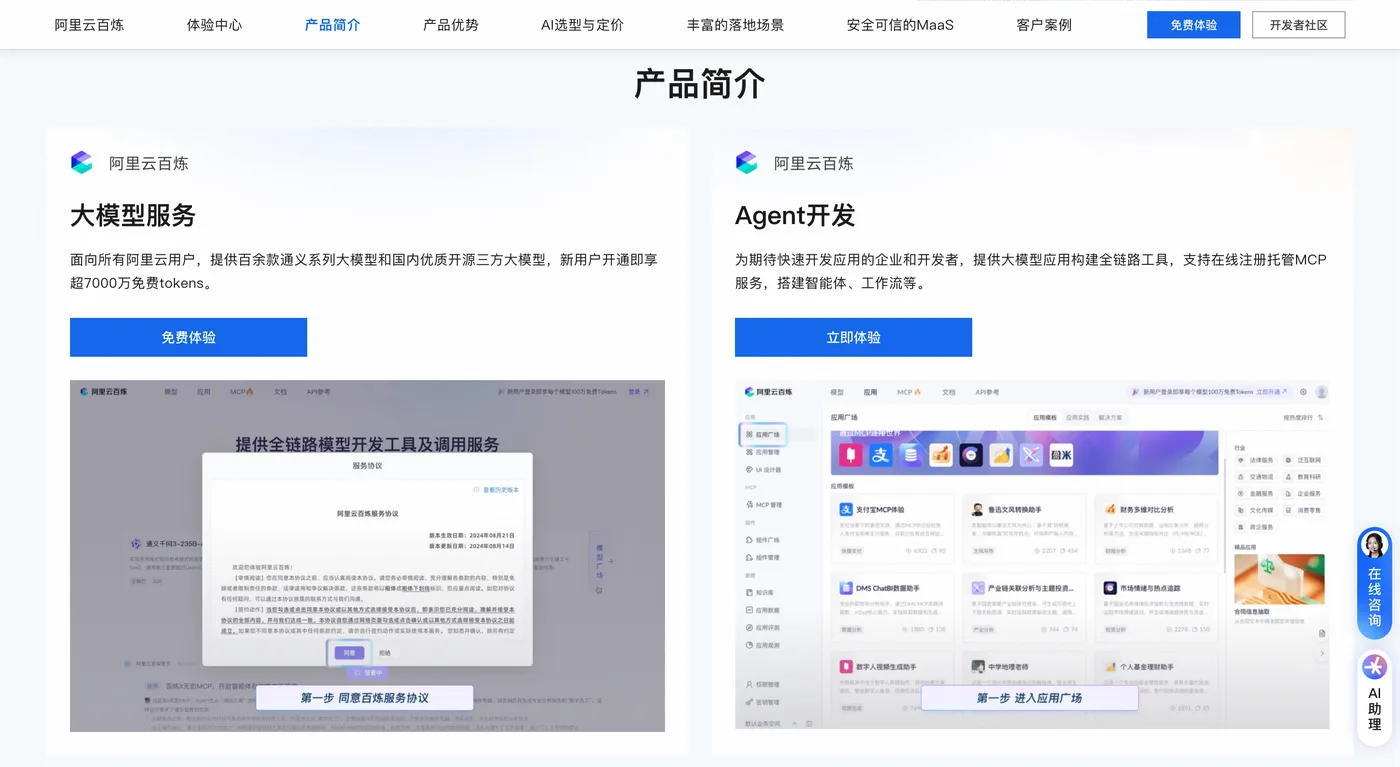
Qwen3.7‑Max属于Qwen3.7产品序列综合实力最强的版本,产品设计重心不再只聚焦单次问答输出质量,重点打磨四大核心方向:长周期自主任务执行、工具调用泛化适配、大规模代码工程处理、百万级上下文理解。对比前代模型,推理稠密程度、工具调用正确率、长文档信息留存率、复杂工程开发能力均实现大幅提升,在多个国际主流大模型评测榜单取得靠前成绩,尤其Agent相关基准测试表现亮眼,Terminal‑Bench 2.0等编程工具类基准刷新国产模型记录。长周期自主任务实测中,该模型完成过数十小时不间断运行,实现上千次工具调用,多轮自我编译、调试、修复缺陷,几乎不需要人工介入,最终达成十倍性能提升,充分印证模型处理高复杂度、长链路项目任务的底层实力。开发者可以前往阿里云百炼大模型服务平台,体验完整模型能力。详情👉访问阿里云百炼大模型服务平台页面 了解。
百万级超长上下文架构,破解长文档处理行业痛点
传统大模型处理大容量资料时普遍存在短板:输入文本接近上下文上限,极易出现关键信息遗忘、跨段落逻辑断裂、细节丢失、检索比对出错。当输入完整合同、整套源码库、几十万字调研报告、整本图书、长时间会议记录时,经常遗漏核心条款、忽略代码漏洞、曲解文档前后逻辑,无法做到全局信息联动分析。
Qwen3.7‑Max原生支持一百万token超大上下文窗口,依托经过深度优化的混合注意力架构,显著增强长文本场景信息召回效果,长文档问答准确率较前代模型显著提升。模型可以一次性承载百万级体量输入内容,完整读入整套项目源码、多份法律合同、多份行业财报、长篇学术专著、数小时录音转写文本,并且支持跨章节、跨文件、跨段落完成关联比对和逻辑推演。
针对不同职业人群,该能力可以落地到大量真实业务场景。法律从业者批量上传多份PDF合同,能够横向比对不同版本条款差异,识别风险内容,梳理权责边界;行业研究员导入数十万字行业报告与多家企业财报,自动提取核心经营指标,梳理行业竞争格局,输出结构化调研报告;后端开发人员将完整项目代码库送入模型,开展全项目漏洞扫描、架构梳理、代码重构、历史版本差异分析,不用人工拆分代码片段分批提交。模型兼容PDF、Word、Markdown等主流格式批量导入,支持要点提取、摘要总结、问答交互、深度分析,适配专业岗位批量处理资料的工作习惯。
为进一步降低百万上下文场景的使用成本,模型原生支持提示缓存机制。在智能体开发场景,系统提示词、固定知识库、项目基础代码属于反复复用的静态上下文,开启缓存后,该部分内容无需每轮请求重复计算,有效降低token消耗,加快接口响应速度,对于高频多轮Agent任务,成本下降效果明显,是搭建企业级自动化工作流的关键特性。详情👉访问阿里云百炼大模型服务平台页面 了解。
下面为Python调用示例,演示携带大段文档上下文开展分析,运行前需要完成依赖安装:
pip install openai python‑dotenv
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
 api_key=os.getenv("DASHSCOPE_API_KEY"),
 base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

long_document_content = """此处粘贴超长文档内容,可以是合同、源码、财报文本,最大可承载百万token级别文本"""

resp = client.chat.completions.create(
 model="qwen3.7‑max",
 messages=[
 {

 "role": "system", "content": "你是专业文档分析助手,基于传入完整文档回答问题,不能遗漏文档关键细节。"},
 {

 "role": "user", "content": f"请分析下面这份文档,梳理核心风险点:\n{long_document_content}"}
 ],
 max_tokens=8192,
 temperature=0.3,
 top_p=0.8,
 stream=False
)
print(resp.choices[0].message.content)
同时提供curl命令调用方式,方便开发者快速调试接口:
curl https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions \
-H "Authorization: Bearer 你的DASHSCOPE_API_KEY" \
-H "Content‑Type: application/json" \
-d '{
"model":"qwen3.7‑max",
"messages":[{"role":"user","content":"基于传入长文档,梳理全部关键风险点"}],
"max_tokens":8192,
"temperature":0.3
}'
工程实操需要注意,文档体量极大时,不建议直接把全部文本写入请求体。最佳实践是向量数据库搭配百万上下文实现混合检索,只将高相关性片段送入模型,兼顾推理效果、接口开销与响应性能。
顶尖Agent智能体能力,支撑长周期自主闭环任务
Qwen3.7‑Max最核心定位就是面向智能体时代的基座模型,它不只优化单次输出质量,而是完善整套自主任务闭环能力,包含目标拆解、子任务规划、工具选择调用、结果校验、错误识别、自我修复、迭代重试,驱动AI完成多步骤、长时间、多工具协同的复杂工作流。
市面上大量大模型处理多步骤复杂任务,遇到报错或者不符合预期的返回结果,流程就直接终止,需要人工修改提示词、调整参数才能够继续运行。Qwen3.7‑Max经过大量长周期任务专项训练优化,当出现运行报错、输出结果偏离目标,模型可以自主定位失败诱因,调整执行策略,重新发起工具调用,循环迭代直至完成任务目标。公开实测案例中,模型完成内核优化项目,数十小时自主不间断运行,发起上千次工具调用,数百轮编译测试评估,持续修改代码、编译运行、评估测试用例、分析性能指标、修复bug,全程几乎没有人工干预,最终实现十倍性能提升。这套自我修复迭代能力,是区分普通对话模型和专业Agent基座模型的核心标志。
该模型对各类主流Agent框架具备优秀跨框架泛化能力,不绑定单一脚手架,在OpenClaw、Qwen Code以及各类自定义Agent运行框架均可稳定运行。原生兼容MCP模型上下文协议,可以对接本地工具、办公组件、代码执行环境、文件读写、数据库查询工具,开发者无需大规模适配改造,就可以搭建专属自动化工作流。
工具调用是Agent运行的底层基础,以下为基础function calling示例,模拟本地文件读取工具调用逻辑:
import os
import json
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(
 api_key=os.getenv("DASHSCOPE_API_KEY"),
 base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

tools = [
 {

 "type": "function",
 "function": {

 "name": "read_local_file",
 "description": "读取本地文本文件内容",
 "parameters": {

 "type": "object",
 "properties": {

 "file_path": {

 "type":"string","description":"本地文件路径"}
 },
 "required":["file_path"]
 }
 }
 }
]

response = client.chat.completions.create(
 model="qwen3.7‑max",
 messages=[{

 "role":"user","content":"读取项目目录下readme.md文件,总结项目主要功能"}],
 tools=tools,
 tool_choice="auto",
 max_tokens=4096
)
print(json.dumps(response.model_dump(), ensure_ascii=False, indent=2))
代码运行后,模型自动判断是否触发工具调用,输出调用参数,业务代码捕获返回结果完成真实文件读取,再将工具结果回传给模型,完成一轮完整Agent循环。以此逻辑扩展,能够搭建读取本地文件、执行脚本、访问接口、查询数据库的复杂自动化工作流。
第一梯队编程能力,实现工程级多文件项目开发
编程能力是Qwen3.7‑Max另一大核心优势,在国际编程评测榜单处于全球第一梯队,能力不局限于简短脚本片段生成,面向完整软件工程场景,覆盖全栈编程语言,包含前端框架页面开发、后端业务接口编写、数据库SQL脚本、底层内核相关代码、多语言混合项目、单元测试编写、漏洞排查、项目重构、历史代码迁移等场景。新增Agentic Coding智能编程代理能力,不再孤立生成代码片段,而是理解完整项目目录结构,修改多处关联文件,自主运行测试用例,捕获程序异常,定位bug,修改源码并验证效果,形成完整开发闭环。
多数代码大模型仅擅长输出演示demo,面对真实多文件项目,经常忽略文件之间依赖关系,修改A文件,忘记同步更新B、C关联模块,产出无法直接运行的代码。依托百万级上下文窗口,Qwen3.7‑Max可以读入整套项目源码,掌握模块依赖、全局变量、接口约定,修改代码时同步维护多处关联逻辑,输出可直接调试运行的工程代码。搭配Qwen Code终端编程工具,开发者在本地项目文件夹,通过自然语言描述需求,AI自动新增、修改、删除项目文件,不用手动复制粘贴代码,显著提升开发效率。
安装Qwen Code终端工具执行命令:
npm install -g @qwen‑code/qwen‑code@latest
qwen --version
安装完成后,进入业务项目目录,执行命令启动终端编程代理:
qwen run "重构用户登录模块,增加参数校验,补充单元测试用例"
在真实开发场景,模型可以完成从产品原型到可交付版本的完整链路,例如接收户型需求,输出带有视角切换、标注渲染的可交互三维可视化前端页面,证明模型具备把抽象产品需求转化为完整可运行原型的实力。运维场景,能够分析系统日志,定位报错堆栈,编写修复脚本,生成监控配置;算法开发场景,可以完成数据处理脚本、模型推理代码、指标统计代码编写。同时针对调试场景深度优化,传入报错堆栈、异常日志,能够快速定位根因,区分业务逻辑缺陷、环境配置故障、依赖版本冲突,输出修改方案,同步讲解问题原理,方便开发者学习。
结构化输出、内置工具生态与参数调优实践
Qwen3.7‑Max原生支持结构化输出,可以稳定输出JSON格式数据,适配数据抽取、内容解析、API参数组装场景。开发者指定JSON Schema约束返回格式,减少文本清洗工作,降低业务解析出错概率。模型内置联网搜索、网页内容提取、代码沙盒解释器,API调用时直接开启工具,不需要开发者从零实现工具逻辑。
开启内置工具的调用示例:
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(
 api_key=os.getenv("DASHSCOPE_API_KEY"),
 base_url="https://dashscope.aliyuncs.com/compatible‑mode/v1"
)

resp = client.responses.create(
 model="qwen3.7‑max",
 input="整理当前人工智能Agent技术发展现状,输出结构化JSON结果",
 tools=[
 {

 "type":"web_search"},
 {

 "type":"web_extractor"},
 {

 "type":"code_interpreter"}
 ]
)
print(resp.output_text)
不同业务场景,参数配置直接影响输出质量,这里整理实用调优经验。temperature控制生成随机性,取值区间0‑1。做数据抽取、文档分析、工具调用、结构化JSON输出,建议设置0.2‑0.4,提升输出确定性,降低幻觉概率;创意写作、头脑风暴,可调整0.7‑0.9,丰富内容多样性。top_p通常配合temperature使用,常规业务场景设置0.7‑0.9。max_tokens根据业务场景配置,文档分析、代码生成建议设置8192及以上,避免输出中途截断。seed参数设置固定数值,测试调试阶段可以提升结果复现能力,方便对比不同提示词效果。
多场景落地应用与开发避坑指南
Qwen3.7‑Max覆盖个人用户、专业从业者、企业开发者不同群体。普通用户网页端直接交互,完成文档总结、内容创作、学习答疑;律师、研究员、金融分析师依靠它批量处理海量文档;软件开发者将其作为AI编程助手,实现代码生成、漏洞审查、项目重构;企业开发者依托API构建自有智能体应用、知识库问答系统、自动化办公工作流。
落地开发过程,需要规避几类常见问题。第一,百万上下文不等于直接把全部原始数据全部送入模型。超大文本全部提交会带来token开销上涨、接口延迟升高,工程层面优先选择向量检索叠加大上下文的混合方案,只送入高相关性片段,兼顾效果与成本。第二,Agent任务不能追求一步到位,复杂业务目标拆解成多个子任务,增加结果校验环节,每一步对输出做校验判断,防止任务发生偏移之后无法回退。第三,开发工具调用,严格规范tool描述与参数schema,描述越清晰,模型选择工具、填写参数的准确率越高。第四,尽管模型自我修复能力强大,高风险业务场景,必须设置人工审核,不能无条件信任AI输出结果,代码、合同、业务决策类内容,务必人工复核。第五,提示缓存适合静态不变的上下文,动态变化对话历史不适合开启缓存,做好场景区分。
总结
Qwen3.7‑Max是面向智能体时代的旗舰基座模型,核心突破集中于百万级超长上下文、长周期自主Agent执行、工程级编程、广泛工具生态适配四大维度,跳出传统大模型局限于问答生成的定位,把模型能力延伸到真实世界复杂任务执行。既可以直接网页交互使用,也可以通过兼容OpenAI格式的API快速集成进业务系统,配套完整代码示例,降低开发者上手门槛。
随着AI Agent应用持续演进,基座模型长链条规划、多工具调用、自我纠错迭代的能力,会成为核心竞争力。Qwen3.7‑Max正是沿着这条技术路线打造,对于普通用户提升个人生产力,开发者搭建下一代AI自动化应用,都具备很高使用价值。开发者可以从简单API调用入手,逐步尝试工具调用开发,再过渡搭建完整Agent工作流,充分释放模型全部能力。
