深度注意力SMOTE:一种增强版本的SMOTE算法

简介: 该研究将传统过采样技术与深度学习相结合,提出了一种增强版本的SMOTE方法——深度注意力SMOTE(DA-SMOTE-ED)。该方法致力于克服传统过采样在边界区域盲目插值容易引入噪声的缺陷,为不平衡时间序列数据的异常检测提供了一种技术路径。
在工业设备监测与故障诊断领域,正常运行数据占据绝大多数,而异常数据极为稀缺,导致采集到的多维时间序列存在严重的类别不平衡与类间重叠问题。针对这一难题,相关学者在期刊《Computers in Industry》上发表了题为“Deep attention SMOTE: Data augmentation with a learnable interpolation factor for imbalanced anomaly detection of gas turbines”的研究论文。

该研究将传统过采样技术与深度学习相结合,提出了一种增强版本的SMOTE方法——深度注意力SMOTE(DA-SMOTE-ED)。该方法致力于克服传统过采样在边界区域盲目插值容易引入噪声的缺陷,为不平衡时间序列数据的异常检测提供了一种技术路径。

1.png

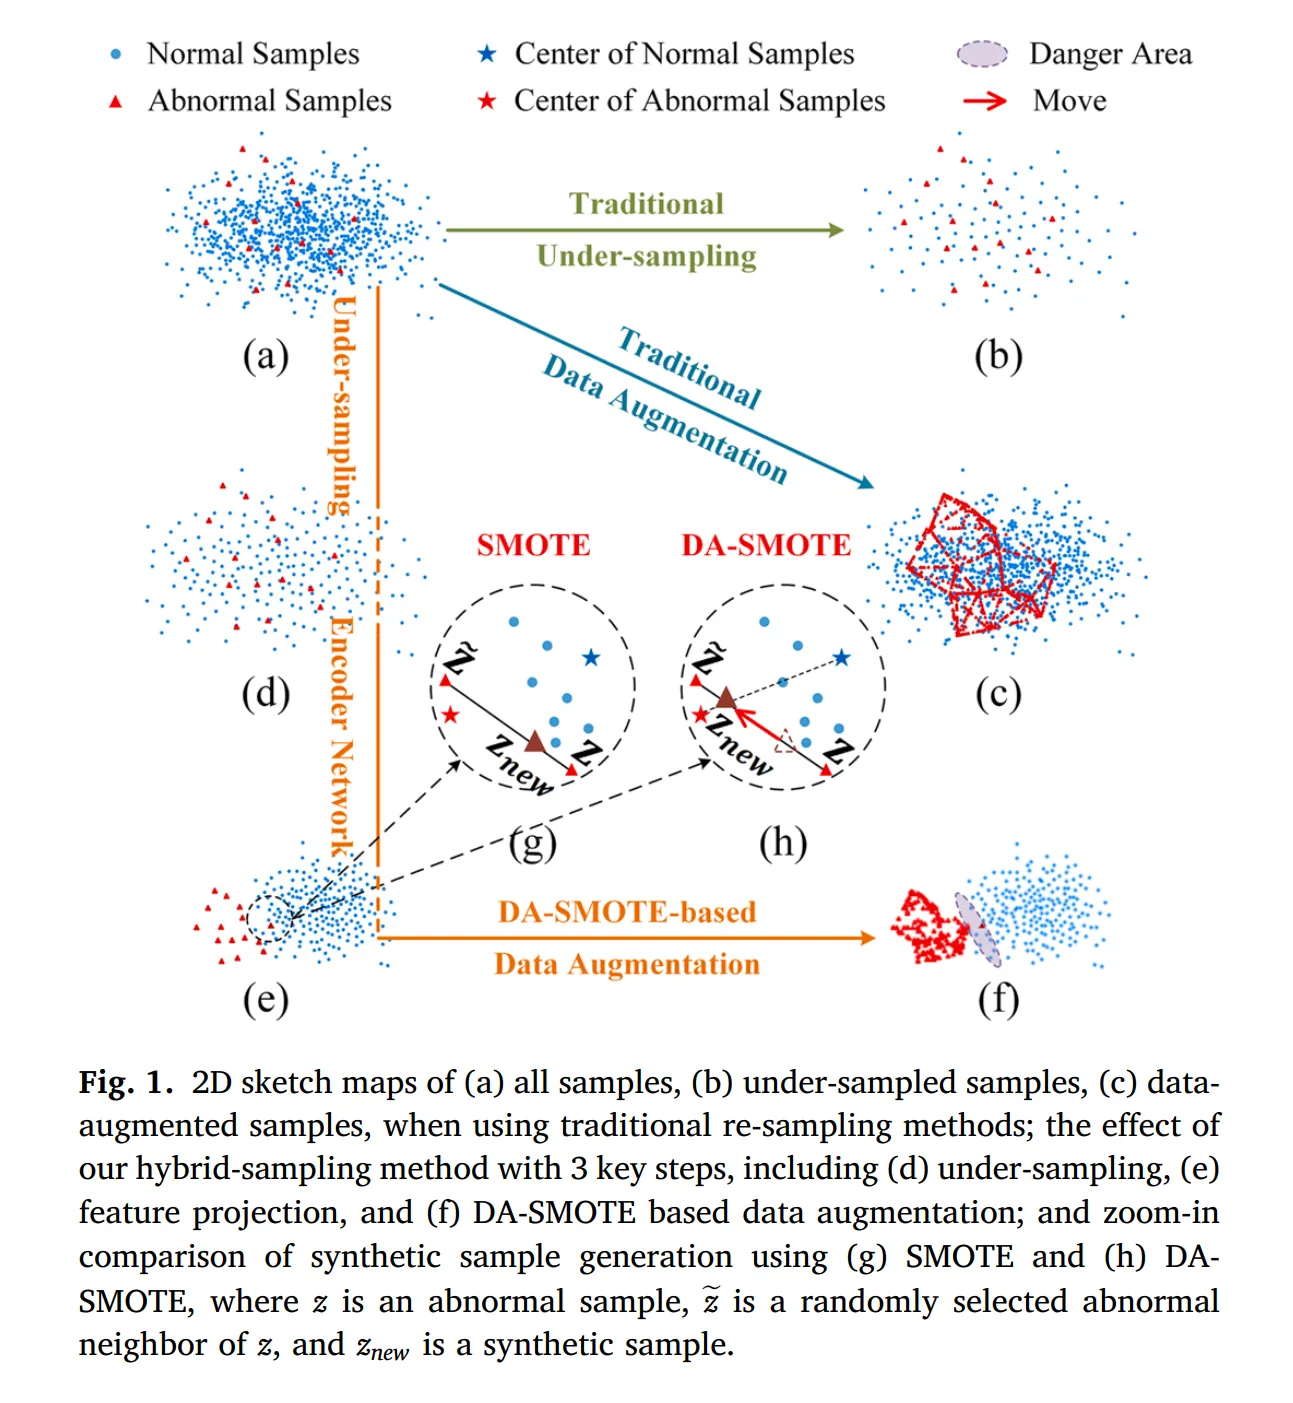
传统SMOTE算法通过在少数类样本及其近邻之间随机选取插值系数进行线性插值,这种完全随机的生成机制极易导致合成样本落在多数类密集的重叠危险区域,进而形成标签噪声并误导分类模型。

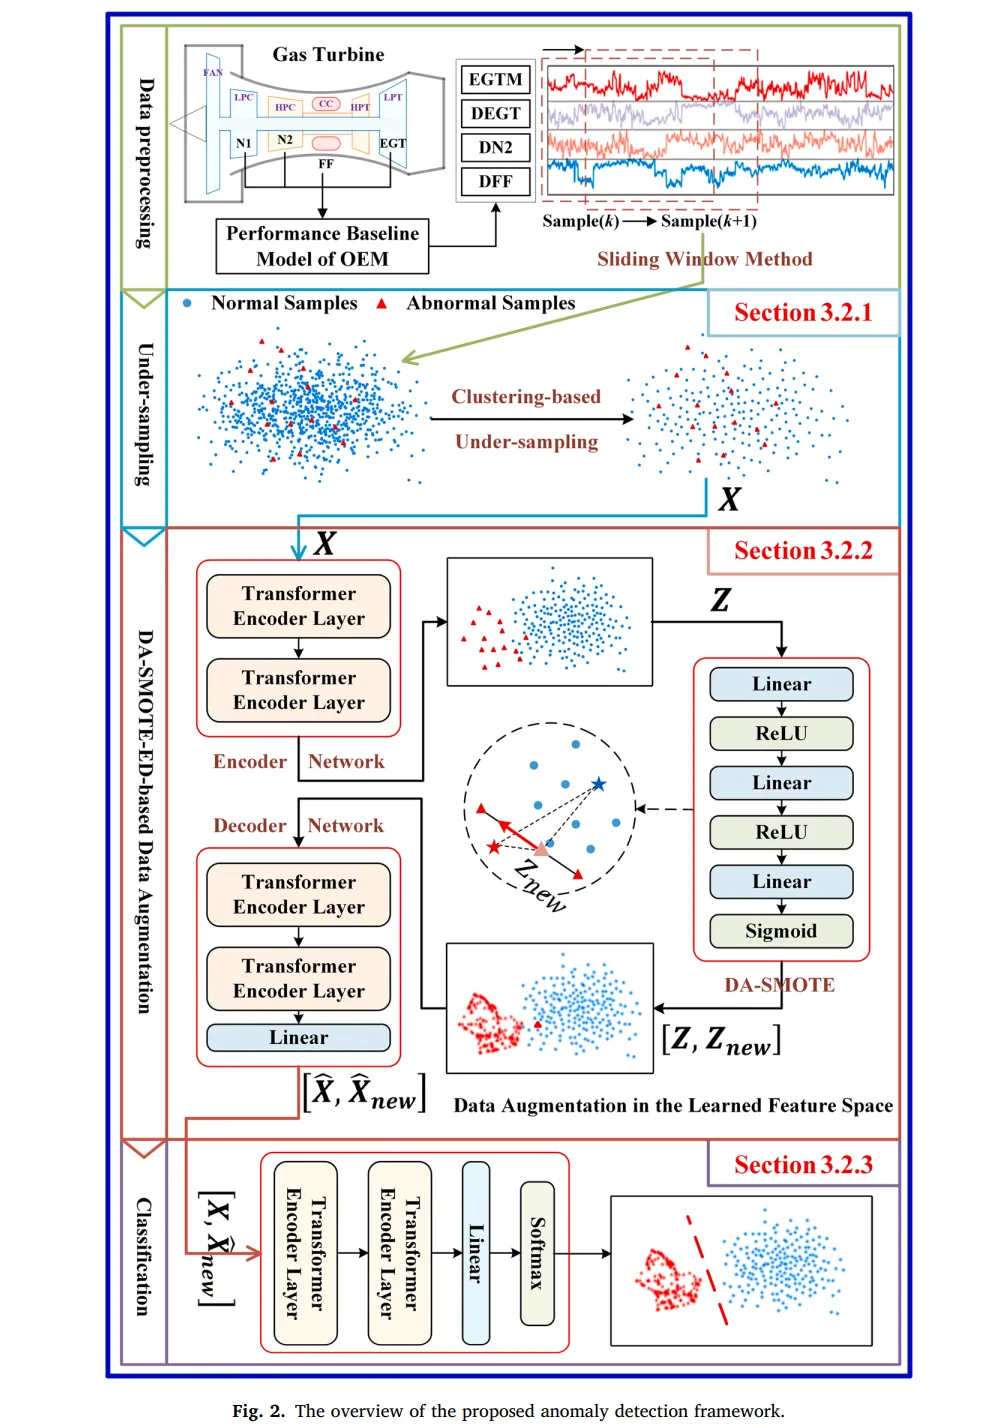
为了从根本上保留更多有用信息并降低噪声风险,该研究构建了一套混合重采样框架。首先,在多数类样本上采用基于聚类的欠采样策略,将多数类数据划分为多个簇并提取簇中心来代表正常样本,从而在压缩数据量、缓解不平衡程度的同时最大化保留正常状态的分布信息;然后,欠采样后的多数类样本与原始少数类样本组合,共同进入后续的特征投影与智能数据增强阶段。
2.png

为了进一步消除类间重叠对数据生成的不利影响,增强版本的SMOTE将样本生成过程从原始数据空间迁移到可学习的潜特征空间中。

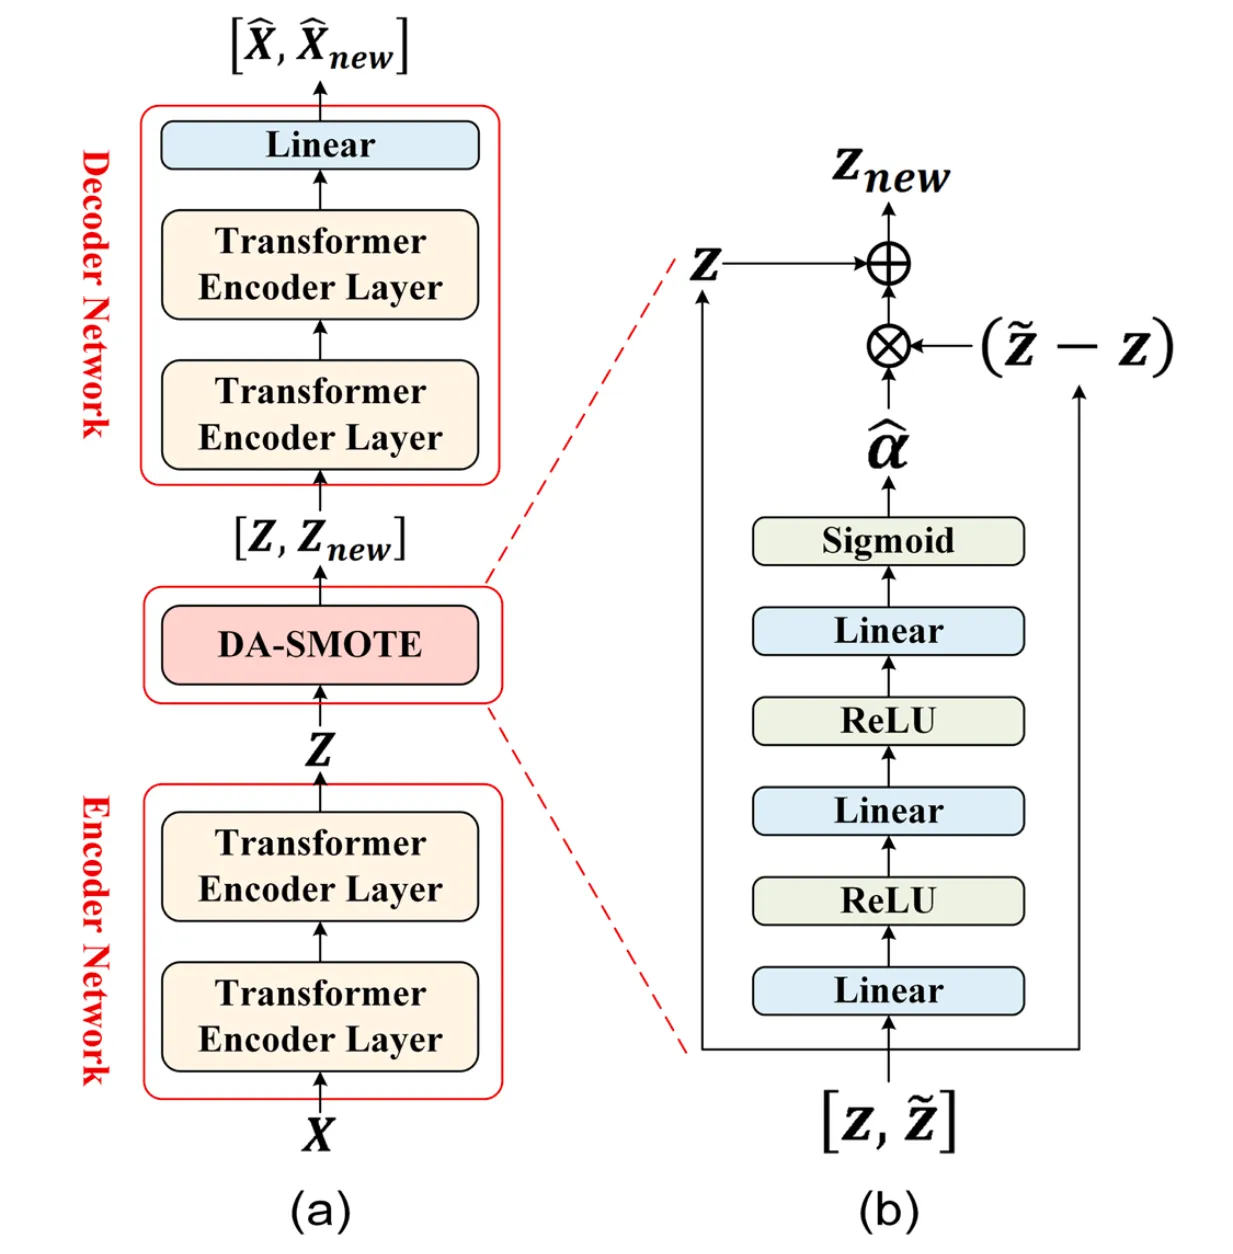
DA-SMOTE-ED整体由编码网络、DA-SMOTE生成模块以及解码网络三部分构成。编码网络基于多头自注意力机制构建Transformer编码器层,能够自适应捕获多维时间序列中的复杂时序关联与特征依赖,将输入数据投影到一个类内紧凑且类间可分的潜空间中。在潜空间内完成数据增强后,结构对称的解码网络再将合成特征无损地映射回原始数据空间,确保最终生成的合成时序样本与真实样本具有一致的维度和物理意义。
4.png

DA-SMOTE模块是该方法的核心改进所在,它彻底摒弃了传统SMOTE中服从均匀分布的随机插值因子,设计了一种基于注意力的自适应插值机制。该模块将少数类样本与其近邻构成的样本对作为输入,依次通过降维线性层、非线性激活函数、升维线性层以及逻辑激活层,端到端地为每一对样本动态计算出最优的插值系数。

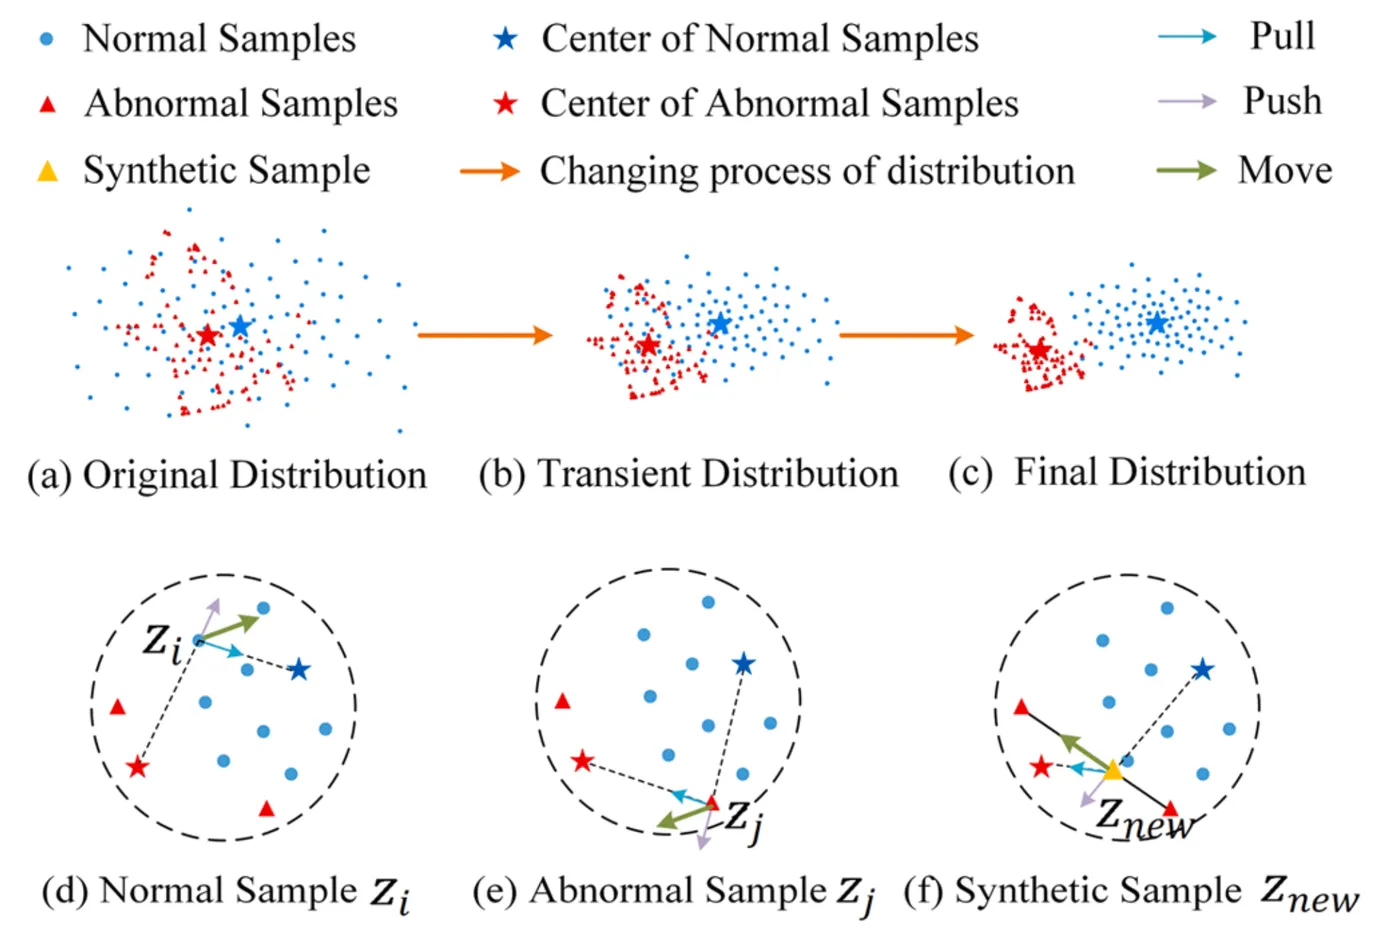
在学习机制的作用下,该插值因子能够感知全局数据分布,引导生成的合成少数类样本主动偏向少数类中心,并远离多数类的聚集区域,从而显著抑制了重叠区域噪声样本的产生。
5.png

为了使模型能够同时兼顾特征保真度与类别可分性,DA-SMOTE-ED在训练过程中联合优化了重构损失与三元组中心损失。重构损失采用类别平衡的距离度量,约束编码器和解码器在降维映射与逆映射过程中保留原始时序的关键模式信息;三元组中心损失则同时作用于真实特征与合成特征,通过拉近样本与其所属类别中心的距离、同时推远样本与相异类别中心之间的距离,显式地拉大类间边界。这种双重驱动的目标机制不仅重塑了更加清晰的决策边界,也使得注意力模块生成的插值因子具备了明确的物理导向性。

在完成潜空间插值与解码重构后,合成的少数类时序样本与欠采样后的多数类样本进行拼接,重构出完全平衡的新训练集。在此基础上,系统采用基于自注意力机制的分类网络作为下游判别器,对多维时间序列样本进行端到端的二分类判决。

该方法不仅在一定程度上解决了传统SMOTE在复杂时序和重叠边界下的退化问题,其网络结构与损失函数设计还具备良好的通用性,通过扩展类别中心定义即可直接适配多分类故障识别任务,展现了数据驱动与深度注意力相结合在工业数据增强领域的实用潜力。

参考文献:
Deep attention SMOTE: Data augmentation with a learnable interpolation factor for imbalanced anomaly detection of gas turbines[J]. Computers in Industry, 2023, 151: 103972.
https://www.sciencedirect.com/science/article/pii/S0166361523001227

相关文章
|
18天前
|
机器学习/深度学习 前端开发
发动机故障诊断智能体(三):特征可分性优化与加权对比投影层
在基础时序编码网络完成对正常工况的压缩表征后,尽管模型具备了提取稳态规律的能力,但在面对多种不同类型的微量气路故障时,潜在空间中的特征分布仍可能存在相互交叠的现象。该组件致力于通过引入度量对比学习机制,在特定的低维投影空间内重塑特征拓扑结构,系统性优化不同故障模式之间的几何可分性。
|
18天前
|
自然语言处理 安全 测试技术
别再只测『答得对不对』:给大模型应用建一套 Prompt 注入红队回归集,把越权/泄密挡在上线前
本文揭示RAG客服应用因缺乏Prompt注入防护而致系统提示词泄露的事故,指出问题根源在于测试只关注“答得对”,却忽视“会不会答不该答的”。提出将注入测试升级为可回归的红队用例集:结构化存于jsonl,覆盖四类注入;用pytest参数化断言输出、工具调用与拒答行为;接入CI自动拦截。安全不是模型天赋,而是靠可执行、可演进的断言守出来的。
别再只测『答得对不对』:给大模型应用建一套 Prompt 注入红队回归集,把越权/泄密挡在上线前
|
29天前
|
缓存 JSON API
阿里云千问Qwen3.8‑Max深度解析:核心能力、订阅计费规则、API接入配置与生产落地完整教程
Qwen3.8‑Max作为千问系列新一代MoE架构旗舰基座,总参数量达到2.4万亿,激活参数950亿,是面向复杂专业任务、长周期智能体、工程级代码开发、多模态深度解析的高阶大模型,原生支持文本、图像、视频多模态输入,最大上下文窗口达到百万Token,最大输出Token支持131072,内置深度思考推理链路,在编程、科研、法律金融专业分析、长视频文档解析、自主Agent任务等场景能力表现突出。很多开发者在项目前期直接接入该旗舰模型,却对模型能力边界、多种计费模式、订阅套餐权益、API参数配置、上下文缓存优化缺乏完整认知,出现成本失控、接口报错、长文本信息丢失、深度思考模式额外消耗大量Token等
1585 5
|
2月前
|
Kubernetes 应用服务中间件 nginx
Kubernetes (K8s) 从入门到实战:命名空间、Pod、Controller、Service,图文并茂
本文是K8s初学者的实战笔记,系统讲解命名空间(隔离资源、环境划分、权限控制)、Pod(最小调度单元、多容器、标签、生命周期、探针、资源限制)、控制器(Deployment灰度发布/回滚、StatefulSet/Job/DaemonSet)及Service(ClusterIP/NodePort、负载均衡、多端口)等核心概念与操作,附带丰富命令示例和原理剖析。
Kubernetes (K8s) 从入门到实战:命名空间、Pod、Controller、Service,图文并茂
|
1月前
|
人工智能 自然语言处理 API
阿里云百炼 Token Plan 个人 & 团队版对比:定价、用量加油包、接入配置、活动权益完整说明
阿里云百炼Token Plan是面向开发者的大模型订阅服务,以Credits统一计费,支持Qwen、Claude、DeepSeek等多模态模型及Cursor、Qwen Code等AI工具。个人版39元/月起,团队版150元/月起,含文本、图像、视频、语音等全能力,兼容OpenAI/Anthropic协议。在阿里云百炼官网:https://t.aliyun.com/U/fPVHqY 免费领取千万Tokens
323 6
阿里云轻量应用服务器新人优惠:38元和68元有啥区别?200M峰值带宽是真的吗?
阿里云轻量应用服务器新人优惠:38元和68元有啥区别?区别就是需要抢,抢到是38元一年,抢不到是68元,轻量服务器配置:2核2G、40GB ESSD云盘、200Mbps峰值带宽、不限流量,阿里云轻量应用服务器官网:https://t.aliyun.com/U/dwftch
|
2月前
|
人工智能 开发框架 Java
如何入门学习 Agent 开发?
本文分享Agent开发实战经验:强调甄别一手资讯、聚焦Context本质而非框架、坚持实操落地、重视效果评测与自我迭代,助新手避开玄学误区,从真实场景出发高效入门。(238字)
120 5
|
1月前
|
人工智能 IDE Java
Qoder CN v1.4.1完整实战指南:Agent式AI编程全流程拆解与企业落地教程
2026年,原有通义灵码完成品牌升级,正式命名Qoder CN,当前稳定版本为v1.4.1。该产品跳出传统IDE插件仅做代码片段补全的定位,升级为Agentic全栈智能编程平台。市面上部分海外同类工具更多聚焦编辑辅助,而Qoder CN依托Quest自主任务、多文件Agent编辑、Repo项目知识库三大核心能力,可以实现从业务需求输入、方案设计、批量编码、自测验证到项目文档沉淀的端到端自主研发闭环。本文结合SpringBoot项目迁移、微服务拆分、分库分表改造、单元测试批量生成四类企业真实业务场景,完整讲解多端安装部署、百炼大模型接入、三级编码Rules规则、四种开发模式、MCP外部工具扩展、
251 0
|
3月前
|
人工智能 自然语言处理 运维
新版通义千问(Qwen3.8-Max-Preview)功能介绍
目前Qwen3.8-Max-Preview处于预览阶段,官方表示正式版将开源权重,未来有望支持私有部署、模型定制和行业应用开发。随着模型的持续迭代与优化,Qwen3.8-Max-Preview将进一步降低AI使用门槛,推动AI技术与各行业深度融合,让智能普惠千行百业,助力数字经济高质量发展。
657 6

热门文章

最新文章