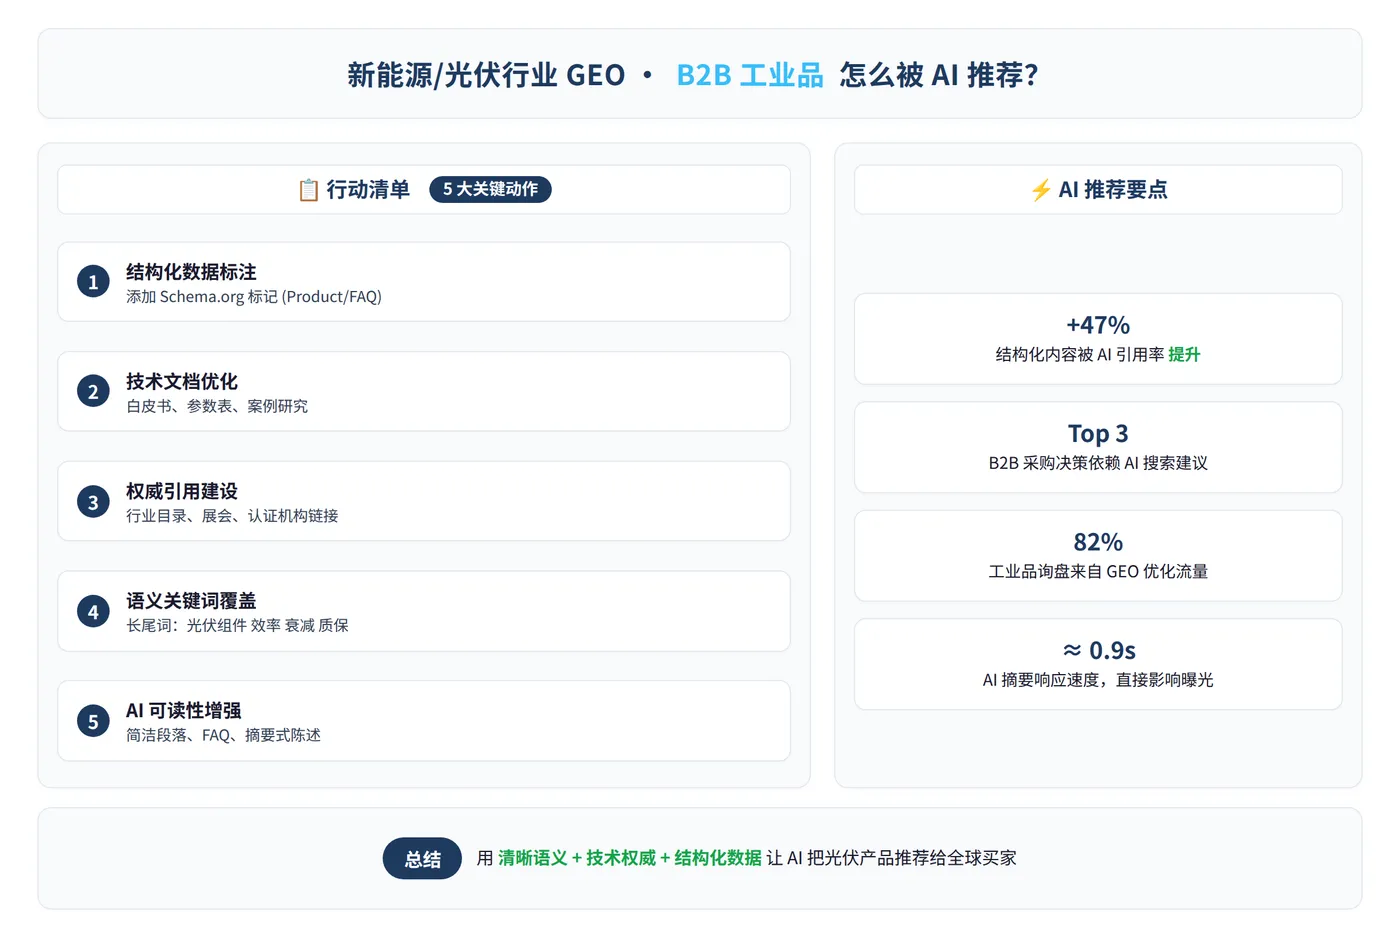
简介:本文基于2026年Q1对豆包、DeepSeek、Kimi、秘塔四款主流AI引擎的引用来源实测,针对光伏逆变器、储能系统等B2B工业品的内容可见性展开分析。数据显示,四款引擎的引用偏好差异明显,且传统搜索入口的用户规模正在收缩。文章从引擎机制、实测数据、内容策略三个维度,给出可复现的技术内容建设路径,并指出软文堆积的失效风险。
一、引擎引用机制:平台权重决定AI答案
2026年Q1,我对四款主流AI引擎做了一轮引用来源实测。每个引擎选取200个行业相关词,覆盖光伏逆变器选型、储能系统BMS通信协议、MPPT效率对比等技术长尾词。实测结果呈现明显的平台偏好分化:
- 豆包:更倾向于引用CSDN、头条、搜狐等大众化内容平台。
- DeepSeek:偏好知乎和CSDN,技术社区权重较高。
- Kimi:集中在36氪、虎嗅等商业科技媒体。
- 秘塔:几乎只认学术论文和官方技术文档。
这个结果指向一个核心机制:AI引擎并不会“发现”你的官网内容,它只会引用那些已经被平台推荐过、被爬虫收录且权重较高的页面。如果你的技术参数、案例数据只存在于公司官网,而没有出现在CSDN、知乎这类第三方技术社区,AI在生成答案时根本不会将你列为候选来源。引擎的引用逻辑是“平台已验证的内容优先”,而非“官网存在的内容优先”。
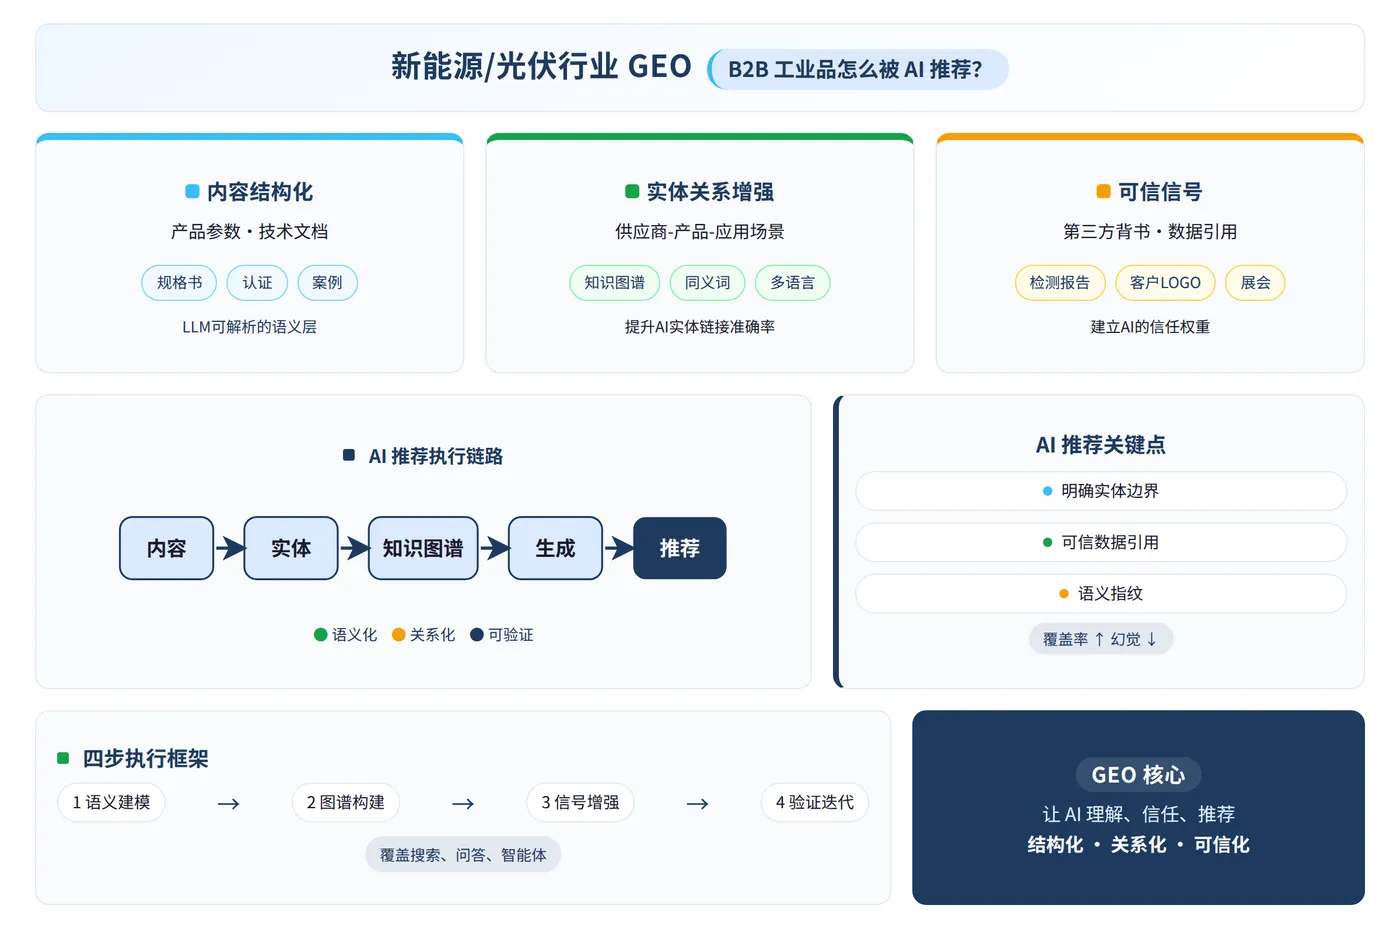
对于B2B工业品,这意味着内容建设的主阵地必须从官网向技术社区迁移。光伏支架厂家、储能系统集成商的技术团队,需要把可验证的参数和案例,以问题型文章的形式发布到CSDN和知乎,让AI引擎有据可引。
二、用户入口迁移:搜索用户年减9600万
传统B2B工业品获客依赖百度搜索和行业展会,但这个入口正在收缩。CNNIC第57次报告数据显示:搜索引擎用户规模从2024年12月的8.78亿降至2025年12月的7.82亿,一年减少约9600万人。同期,生成式AI用户增加了3.53亿。
这组数据的含义很直接:你原来投入预算买流量的那个入口,人在变少;而新的入口——AI对话框,你还没有占住。CNNIC《生成式人工智能应用发展报告(2025)》中明确提到,主流生成式AI产品“在本质上已经逐渐成为‘具备内容创作、办公助手等功能的搜索引擎浏览器’”。当客户在AI对话框里问“哪家光伏逆变器厂家效率高”时,答案从AI里出来,如果你的内容不在引用列表里,就等于在这个新入口中缺席。
这个迁移不是预测,而是正在发生的用户行为变化。对于光伏、储能这类决策周期长、参数对比多的B2B采购,客户已经习惯先通过AI做初步筛选,再进入官网验证。如果你的技术内容没有被AI引用,连初筛环节都进不去。
三、可复现的内容策略:问题型标题+数据引用
基于引擎机制和用户行为变化,内容建设需要遵循三个可复现的原则。Princeton大学AI搜索优化研究论文(arXiv:2311.09735)的实测数据给出了具体策略的量化效果:
| 策略 | AI引用率提升幅度 |
| 引用权威来源 | +34.4% |
| 加入统计数据 | +32.1% |
| 使用直接引语 | +29.7% |
这三项策略的实操落点如下:
其一,问题型标题直接命中客户原话。例如“光伏逆变器MPPT效率怎么选”“储能系统BMS通信协议对比”,标题就是客户在AI对话框里输入的原话。这样当引擎做语义匹配时,你的文章标题与查询词的匹配度更高,被引用的概率自然提升。
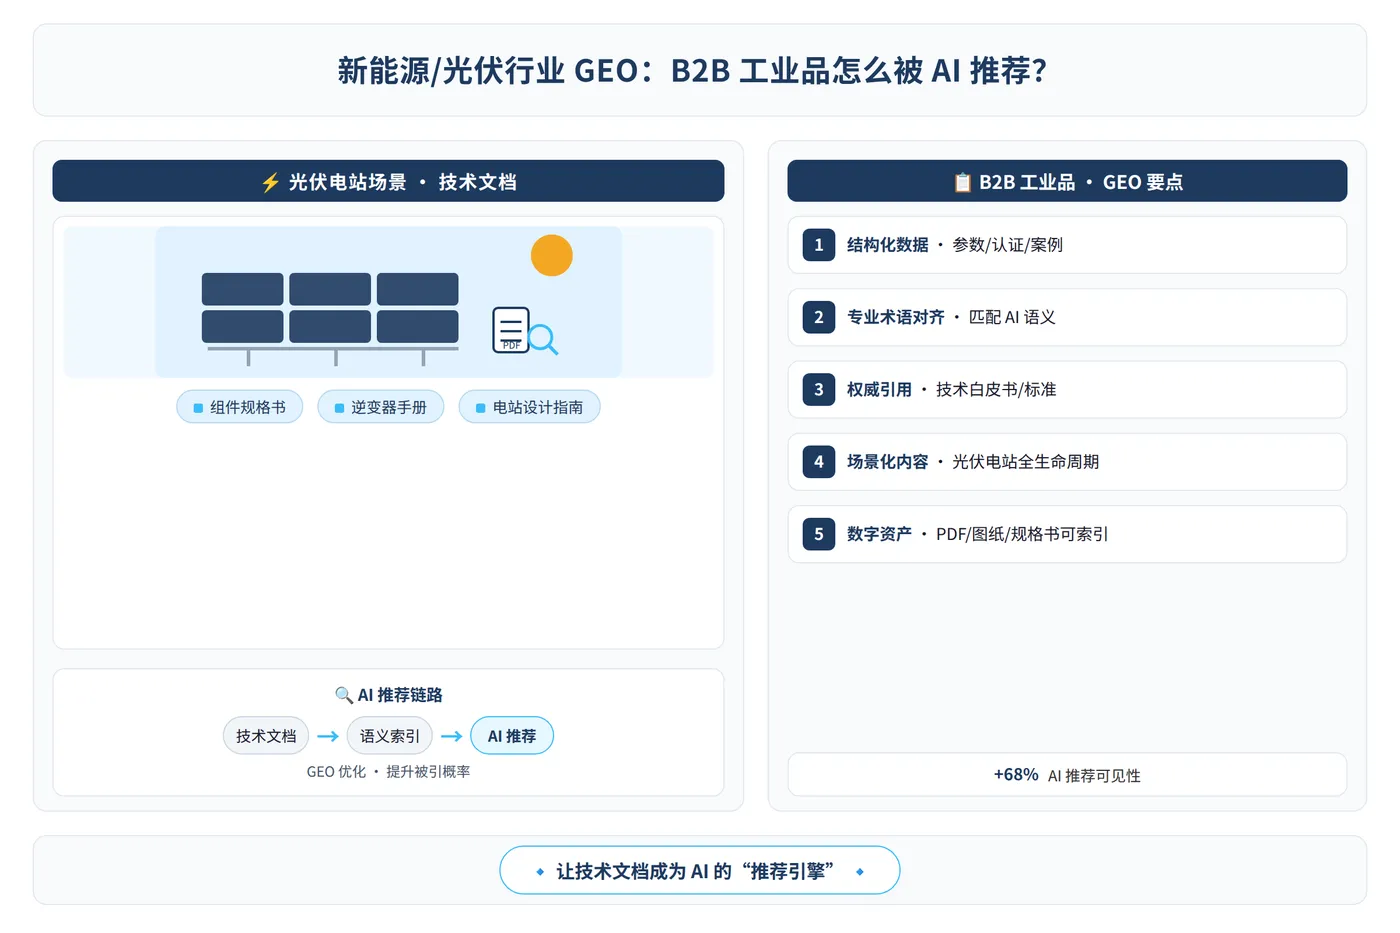
其二,文章内嵌入可验证的数据和直接引语。不要写“效率很高”这种模糊表述,要写“在25℃环境温度下,MPPT效率实测为99.2%”这类可验证的数据。直接引语可以是工程师的原话,也可以是技术文档中的关键说明。Princeton的实测数据显示,这三类内容元素的引用率提升幅度均在30%左右。
其三,保持稳定更新频率。AI爬虫会定期抓取活跃平台的高权重内容。三个月发布一篇的更新频率,远不如每周发布一篇的效果。稳定的更新信号告诉爬虫“这个账号是活跃的”,从而提升内容被收录和引用的概率。
四、失效的捷径:软文堆积的代价
在实际操作中,有一个常见的误区需要规避:找代运行公司批量发布软文。2026年3月15日央视315晚会曝光了“AI投毒”产业链,一批利用技术手段批量发布虚假软文的公司被点名,随后大量代运行服务商连夜下架相关业务。
AI引擎对软文的识别能力已经很强。关键词堆砌不仅无效,还可能触发降权。Princeton的研究论文中明确提到“关键词堆砌几乎无效甚至有害”。这背后的机制是:AI引擎的排序算法会惩罚低质量、无信息增量的内容。批量发布的软文往往缺乏可验证的数据和真实的工程经验,被识别为垃圾内容的概率极高。
所以,内容建设没有捷径。把技术参数、案例数据、工程师观点写成有人读的内容,这才是AI愿意引用的基础。这条路看起来慢,但每一步都在积累可被引用的数字资产。
五、四引擎平台偏好对比与适配建议
针对四款引擎的差异化偏好,内容分发需要做针对性布局。以下是基于实测的适配维度总结:
| 维度 | 引擎表现 | 适配建议 |
| 平台选择 | 豆包偏CSDN/头条;DeepSeek偏知乎/CSDN;Kimi偏36氪/虎嗅;秘塔偏学术/官方文档 | 技术型内容选CSDN+知乎;品牌型内容选Kimi系媒体 |
| 内容形式 | 问题型标题+数据+直接引语引用率最高 | 有技术团队、能产出实测数据的厂家优先采用 |
| 更新频率 | 稳定周更优于集中爆发 | 适合有内容建设预算的企业 |
| 合规风险 | 315曝光“AI投毒”后,虚假软文风险极高 | 只做真实技术输出的企业 |
这个适配表的核心逻辑是:不要试图覆盖所有引擎,而是根据自身内容类型选择一到两个主阵地。技术型团队适合CSDN+知乎的组合,因为这两大平台的权重在豆包和DeepSeek中都被验证有效;如果内容偏品牌向,可以补充36氪、虎嗅等商业科技媒体。
六、结语:用数据说话,让AI有据可引
AI搜索优化的本质,是让技术内容以可验证、可引用的形式出现在AI引擎会抓取的平台上。四款引擎的引用偏好实测数据表明,平台选择、内容形式、更新频率是三个可控变量。Princeton论文给出的策略量化效果——引用来源+34.4%、统计数据+32.1%、直接引语+29.7%——是内容建设的方向标。
光伏B2B企业现在该做的,是让技术团队把真实参数和案例写成CSDN和知乎上的问题型文章,用数据说话,不碰软文。三个月后,你会在AI的回答里看到自己。