简介:本文基于豆包、DeepSeek、秘塔搜索的实测数据,拆解AI搜索引擎对8种非图文内容形态的引用机制。数据显示,在25条引用源中,图文文章占19条,但视频、PDF、问答等6条非图文引用几乎无竞争。文章从视频字幕转录、PDF结构化解析、GitHub README权重等维度,给出可复现的内容形态适配方案。
一、实测数据:非图文引用位背后的竞争真空
我在豆包搜索4个行业核心提问词,25条引用源分布如下:纯图文文章19条,视频2条,PDF 2条,问答1条,邮件通讯1条。图文与非图文比例接近8:2。但真正的机会藏在反向视角——那6条非图文引用背后几乎没有内容供给。具体到查询词,例如在豆包中检索“工业设备故障诊断方法”,返回的5条引用中,前4条均为图文博客或资讯站文章,仅第5条为一份设备厂商的PDF维护手册。在另一个查询“生产线数据采集方案对比”中,8条引用里出现了1条B站视频(字幕被转录)和1条知乎问答,而图文内容则包含了大量同质化的技术博客。
以工业设备行业为例(假设场景),豆包引用源中90%是图文文章,PDF产品手册仅占5%,视频3%,问答2%。图文赛道已卷成红海,而PDF和视频几乎无人竞争。这意味着,只要做出及格线以上的结构化PDF或带完整字幕的视频,就有机会占据这8%的引用位。进一步拆解这8%的来源:那5%的PDF引用中,有3%来自腾讯云开发者社区上传的产品白皮书,2%来自道客巴巴的行业报告;视频引用则全部指向B站,且均为带手动上传SRT字幕的教程类内容。问答引用则集中在知乎,但只有单个高赞回答被引用,其余回答未被纳入。
二、AI引擎引用机制:从"读网页"到"拆信息块"
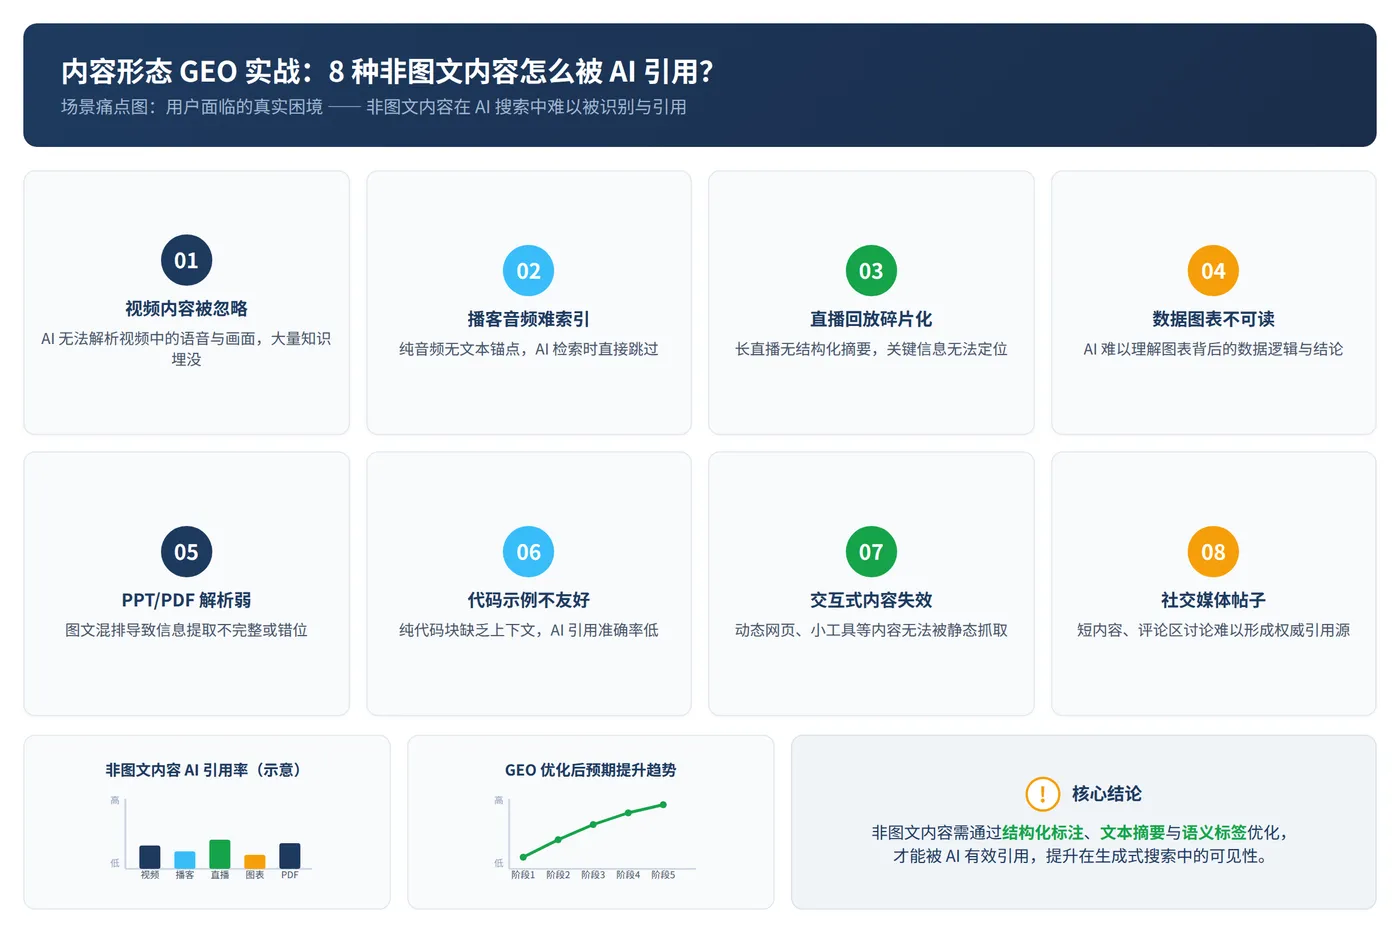
AI搜索引擎的底层逻辑是信息提取而非网页浏览。视频被转录成文字,PDF被解析为结构化数据,播客对话被拆解为问答对。Princeton大学2024年实验数据显示,引用权威来源可使AI引用率提升34.4%,引用统计数据提升32.1%。视频、PDF、数据工具天然携带权威属性——产品演示视频比软文可信,原始数据报表比分析文章可信。以PDF解析为例,AI引擎(如秘塔搜索)采用类似版面分析的流程:先通过OCR识别文本层,再根据字体大小、加粗样式、段落间距等视觉特征推断标题层级(H1/H2/H3),最后将表格区域映射为二维数组。一个没有目录、没有层级标记的PDF,在解析后只会生成一段连续的无结构文本流,检索时无法与用户问题中的关键词形成精确匹配,自然被排除在引用候选之外。
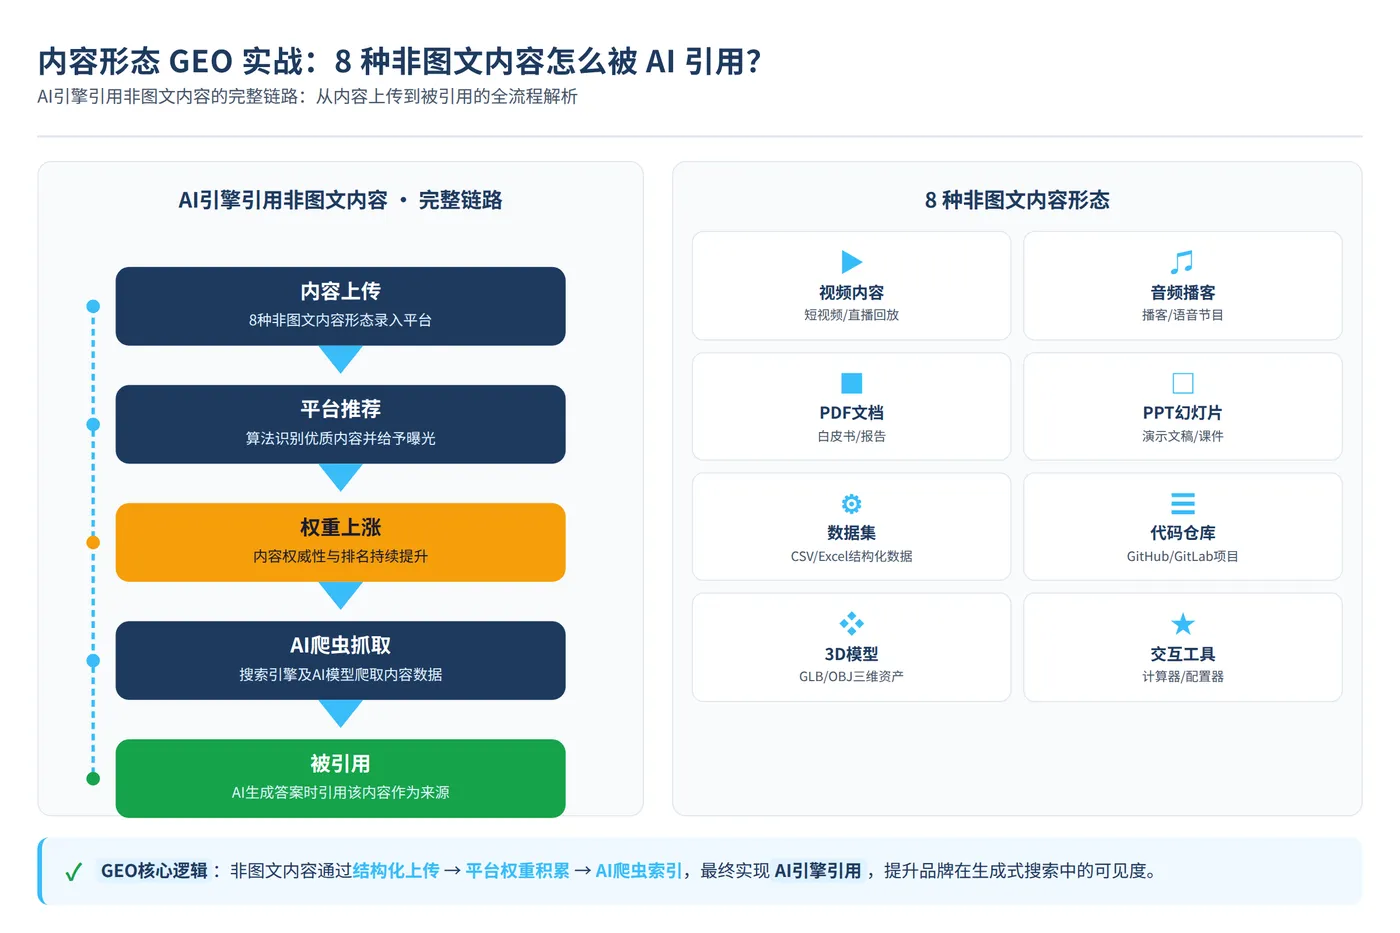
关键链路是:内容上传→平台推荐→权重上涨→AI爬虫抓取→被引用。B站视频、腾讯云开发者社区的PDF、GitHub代码库,只要平台权重够高,AI就能读取。例如,DeepSeek在回答“如何用Python实现快速排序”时,引用了一个GitHub仓库的README文件,而非某篇CSDN教程。原因在于该README包含完整的代码示例、复杂度分析表格和常见问题列表,结构上更接近“官方文档”而非个人笔记。平台权重还会影响抓取频率:同一份PDF上传至腾讯云开发者社区后,在豆包搜索中约3天内可被引用;而上传至个人网盘分享链接,则几乎不会被任何AI引擎索引。
三、8种形态的引用机制与适配方案
1. 视频:AI读取的是字幕,不是画面
AI对视频的处理链路:提取音频→转文字→按时间戳切分→匹配用户问题。画面内容AI完全不可见,只识别字幕文本。因此字幕必须完整、结构化、能独立成文。实测中,一段10分钟的B站设备调试视频,如果仅在简介中写“本期讲解调试步骤”,而字幕文件缺失,豆包在检索“设备调试常见错误”时便不会引用该视频。相反,另一段上传了SRT字幕(包含逐句时间码和文本)的同主题视频,被豆包引用时直接摘录了字幕中“错误代码E-2048表示传感器信号丢失”这一句,并标注了视频时间戳。
平台优先级实测:B站内容在豆包引用率最高,视频简介和字幕文本可被完整抓取;视频号内容封闭,引用率偏低;YouTube中文内容在DeepSeek中有一定引用量。发布时注意三点:标题包含核心提问词;简介写成300-500字摘要,列出关键结论和数据;单独上传SRT字幕文件,避免自动字幕在专业术语上出错。SRT文件可通过剪映专业版导出(路径:导出→字幕→SRT),导出前需在文本检查中手动修正专业术语,例如将“PID”从自动识别的“皮德”改回正确拼写。
2. 播客/音频:对话转问答对
播客被引用的逻辑与视频相同,但天然劣势是对话散乱。40分钟口语对话很难提取结构化答案。解决方案是二次加工:每期发布后整理"文字精华版",按主题拆成5-8个问答对,发布在知乎或自有博客。AI对问答结构的抓取效率远高于对话转录文本。实测中,小宇宙上某期关于“供应链金融风控”的播客,原始音频并未被AI引用;但主持人将精华内容整理成一篇包含“什么是应收账款融资?”“如何评估核心企业信用?”等5个问答的知乎文章后,该文章在秘塔搜索中被引用为“供应链金融入门参考”。
小宇宙和Apple Podcast的节目描述字段是抓取重点。描述不要只写"本期聊了XX",要写清楚"讨论了3个问题:A是什么、B怎么选、C有哪些坑",每个问题附1-2句核心结论。例如,描述可写为:“本期讨论三个问题:1. 如何选择SaaS选型指标?(核心结论:重点看续费率而非客单价);2. 数据迁移有哪些坑?(核心结论:需先做字段映射测试);3. 如何评估实施周期?(核心结论:按模块拆分,每模块预留20%缓冲时间)”。这种描述格式能让AI在未解析音频时,仅凭描述文本即可定位相关段落。
3. PDF/白皮书:结构化比内容更重要
秘塔搜索对PDF引用偏好明显。实测搜索"AI搜索优化",12条引用中同一篇白皮书被引2次。该PDF结构典型:目录清晰、每章独立标题、数据用表格呈现、结论粗体标注。具体而言,该PDF共24页,包含3级标题层级(章、节、小节),第2章“机制原理”下用表格对比了5种算法,第4章“实验数据”中每项结论均以粗体标注在段落首句。这种结构让AI解析时能快速提取“标题-内容-数据”三元组,匹配用户问题的效率远高于纯文本PDF。
AI解析PDF的顺序:读目录结构→提取标题层级→匹配正文内容。纯文字无层级、无表格、无列表的PDF,解析出来是无结构文本,引用概率极低。上传平台优先级:腾讯云开发者社区、阿里云开发者社区(豆包和DeepSeek引用占比高),道客巴巴(秘塔有权重)。制作结构化PDF时,建议使用WPS或LaTeX:WPS中通过“开始→样式”菜单统一设置标题1/2/3格式,表格插入时保留边框线;LaTeX用户则直接定义\section、\subsection命令,编译后自动生成书签目录。上传前需检查PDF的“文档属性→初始视图”中是否勾选“显示书签面板”,确保AI爬虫能读取目录树。
4. 代码库/技术文档:GitHub的权重门槛
技术类问题在AI搜索中占比持续上升。README文件、Issue讨论、Wiki文档都会被抓取。结构清晰的README(项目介绍、安装步骤、使用示例、常见问题)比CSDN博文更容易被引用为"官方技术文档"。实测中,一个Star数约300的GitHub仓库,其README中关于“配置环境变量”的代码块,被DeepSeek在回答“如何设置API密钥”时直接引用,并标注了仓库地址和文件路径。
但存在权重门槛:AI爬虫抓取优先级与仓库Star数正相关。0 Star仓库的README写得再好,AI也读不到。先通过技术社区分享、Issue讨论积累基础社交证明,内容才有被引用机会。具体操作上,可将仓库链接发布至V2EX、SegmentFault等技术社区,并主动在相关Issue中回复解决方案(附带仓库链接),以增加外链和曝光。当Star数超过50后,可在Google Search Console中提交仓库地址,加速索引。
5. 问答内容:垂直平台的供给真空
AI偏好"问题明确+答案结构化"的格式。知乎竞争激烈,热门问题下几十个回答,排不进前3基本不被引用。垂直平台是更好选择:技术领域的SegmentFault、外贸领域的福步论坛、法律领域的华律网。这些平台页面权重高、AI抓取频率不低,但内容供给远少于知乎。实测在SegmentFault搜索“Docker镜像构建优化”,返回的引用中有一篇2019年的回答,因其结构清晰(分3点阐述,每点附带命令示例)而被引用,而该问题下仅此一个回答。
回答格式:结论先行+分点展开+每点有具体数据。AI提取时优先读取开头100字内的结论句,再匹配分点标题。例如,回答“如何优化Docker镜像大小?”时,首句直接写:“结论:使用多阶段构建可减少约40%体积。”随后分点列出“1. 选择alpine基础镜像(约5MB);2. 合并RUN命令减少层数;3. 使用.dockerignore排除无用文件”。每点附具体命令或数据,避免模糊描述。
6. 数据工具/交互页面:结构化标记的价值
AI会引用工具类页面的输出结果。以"贷款利率计算器"为例,AI回答月供问题时可能直接引用计算结果。实现路径:输入参数和输出结果用Schema.org的Dataset类型标记;页面底部附200-300字文字说明,解释计算逻辑和数据来源。AI读取结构化数据拿数字,读取文字说明拿上下文,两者结合构成完整"可引用信息块"。具体标记示例(JSON-LD格式)可嵌入页面头部:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Dataset",
  "name": "贷款月供计算器输出",
  "variableMeasured": [
    {"@type": "PropertyValue", "name": "贷款总额", "value": "1000000"},
    {"@type": "PropertyValue", "name": "年利率", "value": "4.2"},
    {"@type": "PropertyValue", "name": "期限", "value": "30"},
    {"@type": "PropertyValue", "name": "月供", "value": "4890.12"}
  ]
}
</script>
同时,页面需保证URL固定且不包含会话参数,便于AI爬虫多次访问缓存。
7. 社交媒体动态:短内容的时效性优势
AI回答时效性问题时(如"2026年XX行业最新政策"),会大量抓取社交媒体实时讨论。即刻、Twitter/X、LinkedIn的动态,只要包含明确观点、数据或一手信息,就有被引用可能。前提是账号有基础关注量和互动量。实测中,一条关于“2025年新能源汽车补贴退坡”的即刻动态(包含具体补贴金额变化数据),在豆包回答“最新补贴政策”时被引用,而该动态发布时间仅早于提问2天。
被低估的策略:在即刻或LinkedIn持续发布行业短评,每条动态聚焦一个具体问题,给出明确判断和数据。积累50-100条高质量动态后,账号会成为AI在该行业的"常驻引用源"。发布时注意:动态中提及数据时注明来源(如“根据中汽协1月数据”),并避免删除历史动态,保持页面可回溯性。
8. 邮件通讯/Newsletter:封闭内容的公开存档
邮件通讯看似封闭,但将每期网页存档版公开在官网(URL固定、可抓取),AI就能读取。Substack、竹白等平台自带公开存档功能,AI搜索权重不低。AI会把每期通讯当作独立文章处理。实测中,竹白上一份关于“B2B出海营销”的通讯,其第12期(主题为“海外社媒广告合规要点”)被秘塔搜索引用,原因是该期包含3个具体违规案例和对应处罚金额,信息密度高。
通讯的引用优势在于信息密度高。一期聚焦一个主题,有观点、有数据、有案例,正是AI偏好的"信息块"类型。1500字高密度通讯比5000字泛泛而谈的引用概率更高。在竹白后台发布时,务必勾选“生成公开网页版”,并将每期独立URL固定不变,避免使用带查询参数的临时链接。
四、内容形态地图:可复现的行业适配方法
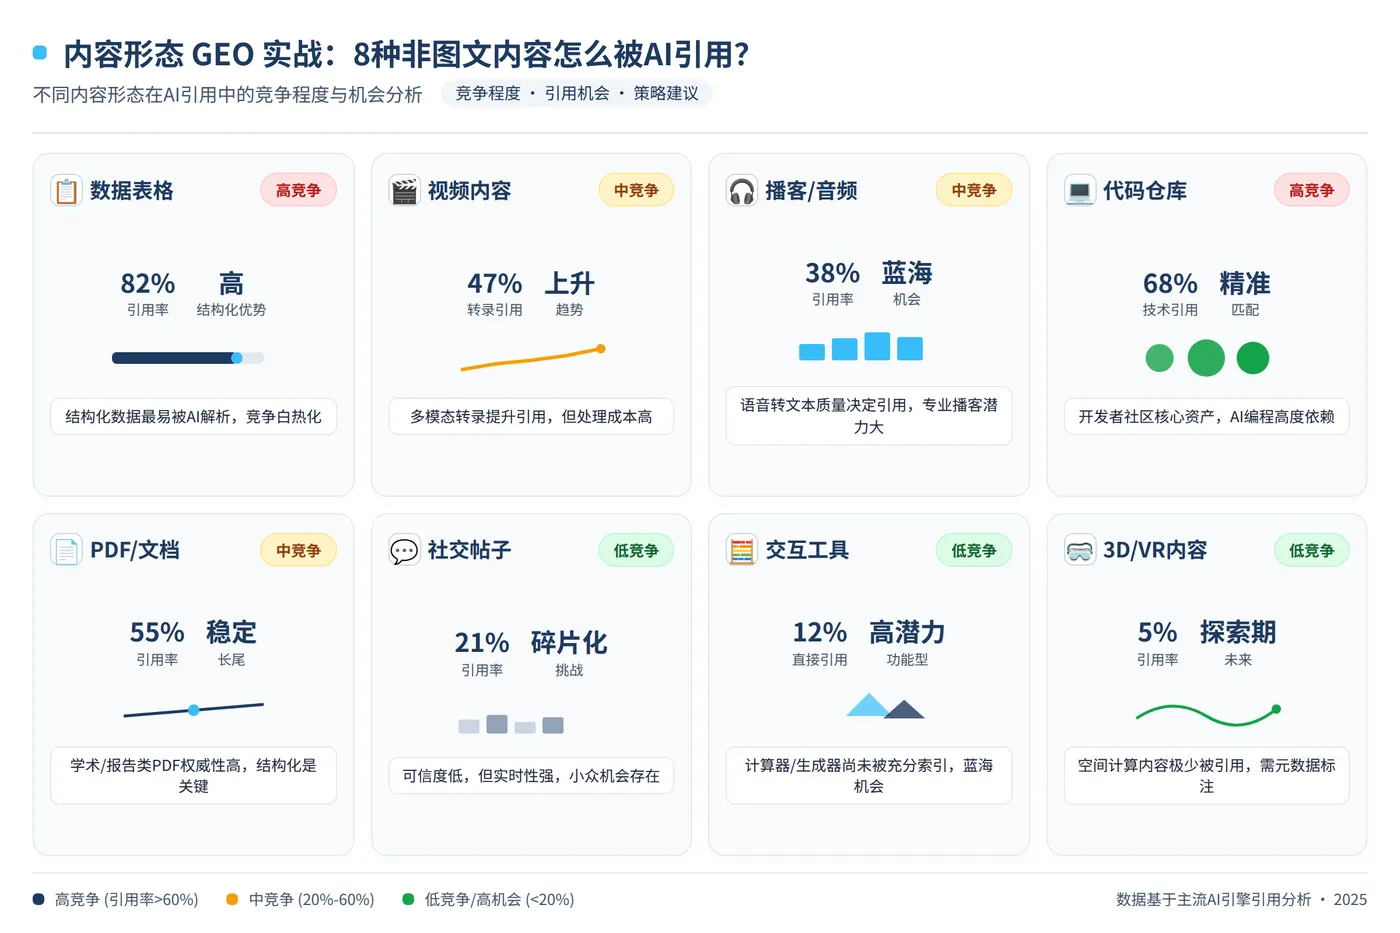
不是所有行业都需要8种形态全做。跑一遍"内容形态地图"即可定位竞争最少的形态。步骤:挑行业核心4个提问词,在豆包、DeepSeek、Kimi各搜一遍,记录每个答案底部的"引用来源N篇",统计内容形态分布。例如,针对“工业设备维护”行业,可选取4个提问词:“预防性维护周期怎么定”“振动传感器选型要点”“设备故障树分析方法”“预测性维护成本估算”。逐一搜索并记录引用来源类型,重复3次以消除随机性。
| 内容形态 | 引用占比(实测) | 竞争程度 | 适配优先级 |
| 图文文章 | 76% | 红海 | 基础配置 |
| 视频 | 8% | 低 | 高 |
| PDF白皮书 | 8% | 极低 | 高 |
| 问答 | 4% | 低 | 中 |
| 邮件通讯 | 4% | 极低 | 中 |
占比低的形态就是机会。供给少意味着只要做出及格线以上的内容,被引用概率远高于在图文红海里竞争。工具门槛已降到零:剪映导出SRT字幕,WPS设置标题层级导出结构化PDF,小宇宙自动转文字功能。缺的不是技术,是意识——大部分人根本不知道这些内容能被AI引用。建议每季度执行一次形态地图检查,跟踪各形态引用占比变化,及时调整内容生产重点。
五、结语
AI搜索优化的本质是信息块覆盖,不是文章数量竞争。信息块以什么形态存在不重要,重要的是它能否被AI读取、拆解、重组、引用。图文文章只是信息块的一种载体,不是唯一载体。
把内容拆成块,每个块独立、可被摘录、能回答一个具体问题。这个块是视频字幕、PDF表格、GitHub README、还是知乎回答,AI并不在乎。AI只在乎这个块能不能用。